La pregunta
Entre 2007 y 2009, un equipo de la Estación Palmer, en la Antártida, dirigido por la bióloga Kristen Gorman, midió a 344 pingüinos de tres islas: el largo y el alto del pico, el largo de la aleta y la masa corporal. Cada pingüino pertenece a una de tres especies: Adelie, Chinstrap o Gentoo.
Imagina que te pasan solo las medidas de un pingüino, sin decirte la especie. ¿Podrías adivinarla? ¿Qué medida te serviría más?
Antes de entrenar cualquier modelo (eso lo harás desde el tema 6), hay que mirar los datos: saber qué columnas hay, qué falta, cómo se reparte cada medida y cómo se relacionan entre sí. A ese trabajo se le llama análisis exploratorio, y es lo primero que hace cualquier persona que trabaja con datos. En este tema vas a:
- guardar datos en tablas de pandas (
DataFrameySeries) y revisarlas coninfo,describeyvalue_counts; - elegir filas y columnas con
loc,ilocy condiciones, agrupar congroupbyy unir tablas conmerge; - encontrar valores faltantes y valores atípicos;
- dibujar con Matplotlib y Seaborn el gráfico adecuado para cada pregunta (histograma, dispersión, caja, mapa de calor, barras y línea) y escribir una conclusión a partir de él.
Necesitas lo del tema 3: arreglos de NumPy, indexación booleana y ejes.
Actividad: mismos números, distinta historia
Antes de tocar los pingüinos, un aviso: los resúmenes (promedios, desviaciones, correlaciones) pueden esconder mucho. Arriba tienes cuatro conjuntos de once puntos y una tabla con sus números principales. Abajo, un histograma de 160 estaturas simuladas con un deslizador para el número de intervalos, es decir, de barras.
Mismos números, distinta historia
Sin JavaScript se ven los puntos desde el principio y el histograma con 3 intervalos. Con JavaScript puedes ocultar los puntos y mover el número de intervalos.
1. Cuatro conjuntos, un mismo resumen
| Medida | I | II | III | IV |
|---|---|---|---|---|
| Media de x | 9,00 | 9,00 | 9,00 | 9,00 |
| Media de y | 7,50 | 7,50 | 7,50 | 7,50 |
| Desviación de x | 3,32 | 3,32 | 3,32 | 3,32 |
| Desviación de y | 2,03 | 2,03 | 2,03 | 2,03 |
| Correlación | 0,82 | 0,82 | 0,82 | 0,82 |
Recta que mejor se ajusta, en los cuatro: y = 0,50·x + 3,00
Lee la tabla: ¿en qué se diferencian los cuatro conjuntos? Después, muestra los puntos.
2. El mismo histograma, distintos intervalos
Con 3 intervalos, cada barra abarca 26,7 cm. Mueve el deslizador.
Prueba esto, en orden:
- Mira la tabla de los cuatro conjuntos antes de ver los puntos. ¿En qué se diferencian? Escribe cómo te imaginas cada nube.
- Pulsa «Mostrar los puntos». ¿Se parecen a lo que imaginaste? ¿En cuál de los cuatro una recta describe bien los datos?
- En el histograma, empieza con 3 intervalos y súbelos de a uno. ¿Con cuántos aparecen dos montículos?
- Sigue subiendo hasta 40. ¿Sigue siendo fácil ver los dos grupos, o aparece ruido?
- Activa «Mostrar cada dato». Las rayitas son las estaturas una por una: no dependen del número de intervalos.
La lección del tema en pequeño: los mismos números pueden contar historias distintas, y la forma de graficar puede esconder o mostrar lo importante. Por eso siempre hay que graficar los datos, y probar más de un gráfico.
De arreglos a tablas: Series y DataFrame
Un arreglo de NumPy guarda números de un solo tipo, y sus filas y columnas solo tienen posiciones (0, 1, 2…). Los datos reales casi nunca son así: una tabla de estudiantes tiene nombres (texto), edades (enteros) y notas (decimales), y nos gusta llamar a las columnas por su nombre. Para eso está pandas.
- Un DataFrame es una tabla: filas y columnas con nombre. Cada columna puede tener su propio tipo.
- Una Series es una sola columna: un arreglo de NumPy con nombre y con un índice, la etiqueta de cada fila.
import numpy as np
import pandas as pd

# Un DataFrame se puede armar con un diccionario: una lista por columna
curso = pd.DataFrame({
    "nombre": ["Ana", "Luis", "Sara", "Iván", "Rosa"],
    "edad": [15, 16, 15, 17, 16],
    "ciudad": ["La Paz", "Sucre", "Oruro", "La Paz", "Tarija"],
    "nota": [78, 65, 91, 70, 84],
})
print(curso)
print()

# Una columna es una Series: un arreglo con nombre e índice
notas = curso["nota"]
print(type(notas).__name__, notas.shape)
print(notas.to_numpy())
print("Promedio:", notas.mean())
nombre edad ciudad nota
0 Ana 15 La Paz 78
1 Luis 16 Sucre 65
2 Sara 15 Oruro 91
3 Iván 17 La Paz 70
4 Rosa 16 Tarija 84
Series (5,)
[78 65 91 70 84]
Promedio: 77.6La columna de la izquierda (0 a 4) es el índice. Por dentro, cada columna es un arreglo de NumPy: to_numpy() lo devuelve y todo lo del tema 3 (operar sin bucles, mean, max) sigue valiendo.
Cargar el dataset y mirarlo
Los datos tabulares casi siempre llegan en un archivo CSV (comma-separated values): texto plano, una fila por línea y las columnas separadas por comas. En pandas se leen con pd.read_csv("archivo.csv"). La librería Seaborn trae una función, sns.load_dataset, que descarga de internet unos CSV de ejemplo y los lee con read_csv. La usamos para los pingüinos, publicados por Allison Horst, Alison Hill y Kristen Gorman con los datos de la Estación Palmer.
Las columnas vienen en inglés. Las renombramos con rename y traducimos los valores de la columna del sexo con map; los nombres de las especies y de las islas quedan como están.
import seaborn as sns

# Descarga el CSV la primera vez: necesita internet
pinguinos = sns.load_dataset("penguins")

pinguinos = pinguinos.rename(columns={
    "species": "especie",
    "island": "isla",
    "bill_length_mm": "pico_largo_mm",
    "bill_depth_mm": "pico_alto_mm",
    "flipper_length_mm": "aleta_mm",
    "body_mass_g": "masa_g",
    "sex": "sexo",
})
# map cambia cada valor según el diccionario
pinguinos["sexo"] = pinguinos["sexo"].map(
    {"Male": "macho", "Female": "hembra"})

print(pinguinos.shape)
print(pinguinos.head())
(344, 7)
especie isla pico_largo_mm pico_alto_mm aleta_mm masa_g sexo
0 Adelie Torgersen 39.1 18.7 181.0 3750.0 macho
1 Adelie Torgersen 39.5 17.4 186.0 3800.0 hembra
2 Adelie Torgersen 40.3 18.0 195.0 3250.0 hembra
3 Adelie Torgersen NaN NaN NaN NaN NaN
4 Adelie Torgersen 36.7 19.3 193.0 3450.0 hembrashape funciona igual que en NumPy: 344 filas (pingüinos) y 7 columnas. head() muestra las primeras cinco filas. Ya se ve algo raro: a la fila 3 le faltan todas las medidas. NaN (not a number) es la forma de pandas de decir «no hay dato».
Tres órdenes dan el primer panorama de cualquier tabla nueva. info() dice el tipo de cada columna y cuántos valores no faltan:
pinguinos.info()<class 'pandas.DataFrame'>
RangeIndex: 344 entries, 0 to 343
Data columns (total 7 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 especie 344 non-null str
1 isla 344 non-null str
2 pico_largo_mm 342 non-null float64
3 pico_alto_mm 342 non-null float64
4 aleta_mm 342 non-null float64
5 masa_g 342 non-null float64
6 sexo 333 non-null str
dtypes: float64(4), str(3)
memory usage: 18.9 KBHay dos clases de columnas:
- Numéricas (
float64,int64): medidas con las que se puede sacar un promedio. - Categóricas: etiquetas como la especie, la isla o el sexo. Aquí aparecen como
str(texto); en versiones anteriores de pandas, como en la de Colab, aparecen comoobject. Más adelante vas a ver una tercera clase, las fechas (datetime64).
En la columna de los conteos ya se ve que faltan datos: 342 medidas de 344, y solo 333 sexos. describe() resume las columnas numéricas y value_counts() cuenta cuántas veces aparece cada categoría:
print(pinguinos.describe().round(1))
print()
print(pinguinos["especie"].value_counts())
pico_largo_mm pico_alto_mm aleta_mm masa_g
count 342.0 342.0 342.0 342.0
mean 43.9 17.2 200.9 4201.8
std 5.5 2.0 14.1 802.0
min 32.1 13.1 172.0 2700.0
25% 39.2 15.6 190.0 3550.0
50% 44.4 17.3 197.0 4050.0
75% 48.5 18.7 213.0 4750.0
max 59.6 21.5 231.0 6300.0
especie
Adelie 152
Gentoo 124
Chinstrap 68
Name: count, dtype: int64describe da, por columna, la cantidad de datos, el promedio (mean), la desviación estándar (std), el mínimo, los cuartiles y el máximo. El 25 % es el primer cuartil: un cuarto de los pingüinos tiene un valor menor que ese. El 50 % es la mediana y el 75 %, el tercer cuartil. La masa va de 2,7 a 6,3 kg, y el promedio, 4,2 kg, mezcla tres especies muy distintas, como vas a ver.
Elegir filas y columnas
Hay dos maneras de señalar partes de una tabla:
loc[filas, columnas]usa etiquetas: el índice de la fila y el nombre de la columna. Un rango como0:2incluye el final.iloc[filas, columnas]usa posiciones, como en NumPy. El rango0:2no incluye el final.
Para filtrar filas se usa una condición, igual que la indexación booleana del tema 3: pinguinos["masa_g"] > 5500 es una Series de True y False, y entre corchetes deja solo las filas con True.
print(pinguinos.loc[0, "especie"])
print(pinguinos.loc[0:2, ["especie", "masa_g"]])
print(pinguinos.iloc[0:2, 0:3])

# Filtrar con una condición
pesados = pinguinos[pinguinos["masa_g"] > 5500]
print(len(pesados), "pingüinos pesan más de 5,5 kg:")
print(pesados["especie"].value_counts())

# Varias condiciones: & (y), | (o), cada una entre paréntesis
dream = pinguinos[(pinguinos["isla"] == "Dream")
                  & (pinguinos["aleta_mm"] > 200)]
print(len(dream), "pingüinos de Dream con aleta de más de 200 mm")
Adelie
especie masa_g
0 Adelie 3750.0
1 Adelie 3800.0
2 Adelie 3250.0
especie isla pico_largo_mm
0 Adelie Torgersen 39.1
1 Adelie Torgersen 39.5
28 pingüinos pesan más de 5,5 kg:
especie
Gentoo 28
Name: count, dtype: int64
22 pingüinos de Dream con aleta de más de 200 mmLos pingüinos de más de 5,5 kg son todos de la misma especie: primera pista para la pregunta del tema.
Valores faltantes
Antes de calcular nada hay que saber qué falta. isna() da una tabla de True y False (True donde falta el dato) y, como True vale 1, sum() cuenta los faltantes de cada columna:
print(pinguinos.isna().sum())

medidas = ["pico_largo_mm", "pico_alto_mm", "aleta_mm", "masa_g"]
# any(axis=1): True en las filas con al menos un faltante
sin_medidas = pinguinos[pinguinos[medidas].isna().any(axis=1)]
print(sin_medidas[["especie", "isla"] + medidas])
especie 0
isla 0
pico_largo_mm 2
pico_alto_mm 2
aleta_mm 2
masa_g 2
sexo 11
dtype: int64
especie isla pico_largo_mm pico_alto_mm aleta_mm masa_g
3 Adelie Torgersen NaN NaN NaN NaN
339 Gentoo Biscoe NaN NaN NaN NaNDos pingüinos no tienen ninguna medida: no sirven para estudiar medidas, así que los sacamos con dropna. A otros nueve les falta solo el sexo; esos los dejamos, porque sus medidas sí sirven. Borrar todas las filas con algún faltante tira información útil, y rellenar un faltante con un valor inventado (por ejemplo, el promedio) puede cambiar las conclusiones. Lo correcto depende de la pregunta, pero siempre hay que decir qué se hizo.
pinguinos = pinguinos.dropna(subset=medidas)
print(pinguinos.shape)
print("Sin sexo anotado:", pinguinos["sexo"].isna().sum())
(342, 7)
Sin sexo anotado: 9Agrupar y resumir: groupby
La pregunta «¿cuánto pesa en promedio cada especie?» tiene tres pasos: separar la tabla por especie, aplicar un resumen (el promedio) a cada parte y juntar los resultados. groupby hace los tres:
por_especie = pinguinos.groupby("especie")
print(por_especie["masa_g"].mean().round(0))
print()
# agg aplica varios resúmenes a la vez
print(por_especie[["aleta_mm", "masa_g"]].agg(["mean", "std"]).round(1))
print()
# Cuántos pingüinos hay de cada especie en cada isla
print(pinguinos.groupby(["especie", "isla"]).size())
especie
Adelie 3701.0
Chinstrap 3733.0
Gentoo 5076.0
Name: masa_g, dtype: float64
aleta_mm masa_g
mean std mean std
especie
Adelie 190.0 6.5 3700.7 458.6
Chinstrap 195.8 7.1 3733.1 384.3
Gentoo 217.2 6.5 5076.0 504.1
especie isla
Adelie Biscoe 44
Dream 56
Torgersen 51
Chinstrap Dream 68
Gentoo Biscoe 123
dtype: int64Los Gentoo pesan en promedio cerca de 1,4 kg más que las otras dos especies y tienen aletas unos 20 mm más largas. Adelie y Chinstrap se parecen mucho en masa y aleta. La última tabla muestra algo que el promedio general escondía: los Gentoo solo están en Biscoe, los Chinstrap solo en Dream, y los Adelie en las tres islas.
Unir tablas: merge
Muchas veces la información está repartida en varias tablas. Supón que en otra tabla tenemos el nombre común en español y el nombre científico de cada especie. merge une las dos usando una columna que comparten, la clave: a cada pingüino le pega la fila de su especie.
especies = pd.DataFrame({
    "especie": ["Adelie", "Chinstrap", "Gentoo"],
    "nombre_comun": ["pingüino de Adelia", "pingüino barbijo",
                     "pingüino papúa"],
    "cientifico": ["Pygoscelis adeliae", "Pygoscelis antarcticus",
                   "Pygoscelis papua"],
})

# how="left": quedan todas las filas de la tabla de la izquierda
completa = pinguinos.merge(especies, on="especie", how="left")
print(completa.shape)
print(completa[["especie", "nombre_comun", "masa_g"]]
      .sample(4, random_state=0))
(342, 9)
especie nombre_comun masa_g
92 Adelie pingüino de Adelia 4450.0
280 Gentoo pingüino papúa 5300.0
132 Adelie pingüino de Adelia 4475.0
279 Gentoo pingüino papúa 4200.0La tabla unida tiene las mismas 342 filas y dos columnas más. Con how="left", un pingüino cuya especie no estuviera en la tabla especies quedaría con NaN en las columnas nuevas; con how="inner", desaparecería. Lo vas a probar en los ejercicios.
Graficar: la figura y los ejes
Matplotlib dibuja en dos niveles: la figura (fig) es la hoja completa y los ejes (ax) son cada gráfico dentro de ella, con su eje x, su eje y y su título. plt.subplots() crea las dos cosas, y luego se dibuja llamando a métodos de ax.
Empezamos por la pregunta más simple: ¿cómo se reparte el largo de las aletas? Para eso sirve un histograma: divide el rango de valores en intervalos y dibuja una barra con la cantidad de datos que cae en cada uno.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()
ax.hist(pinguinos["aleta_mm"], bins=25, color="C0")
ax.set_xlabel("Largo de la aleta (mm)")
ax.set_ylabel("Cantidad de pingüinos")
ax.set_title("Las aletas de 342 pingüinos")
plt.show()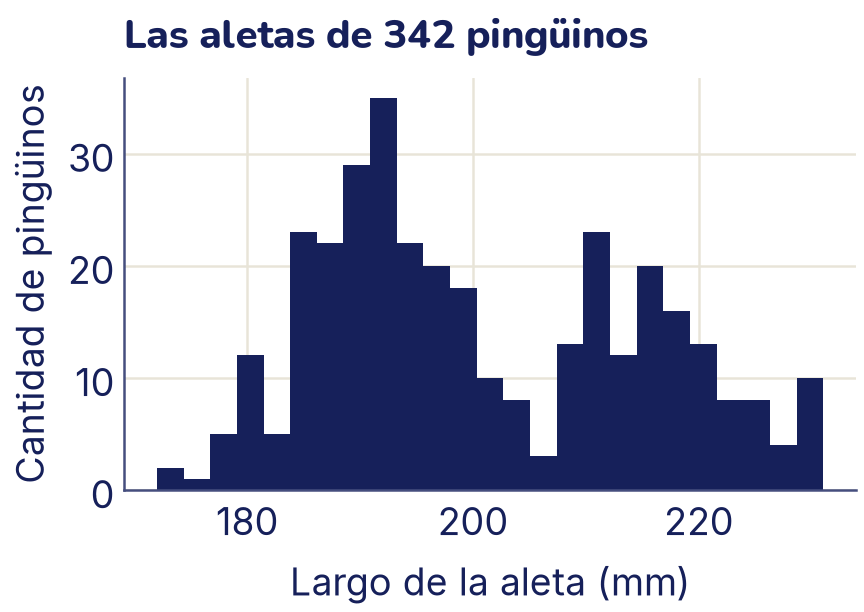
El histograma tiene dos montículos: una distribución así se llama bimodal, y casi siempre indica que hay dos grupos mezclados. ¿Qué grupos? Una figura puede tener varios ejes: con plt.subplots(3, 1) creamos tres, uno debajo del otro, y con un bucle sobre groupby dibujamos una especie en cada uno.
fig, ejes = plt.subplots(3, 1, figsize=(4.8, 4.8), sharex=True,
                         sharey=True)
intervalos = range(170, 236, 3)    # los mismos en los tres
for ax, (especie, grupo) in zip(ejes, pinguinos.groupby("especie")):
    color = "C1" if especie == "Gentoo" else "C0"
    ax.hist(grupo["aleta_mm"], bins=intervalos, color=color)
    ax.text(0.02, 0.75, especie, transform=ax.transAxes)
ejes[-1].set_xlabel("Largo de la aleta (mm)")
fig.supylabel("Cantidad de pingüinos", fontsize=15)
plt.show()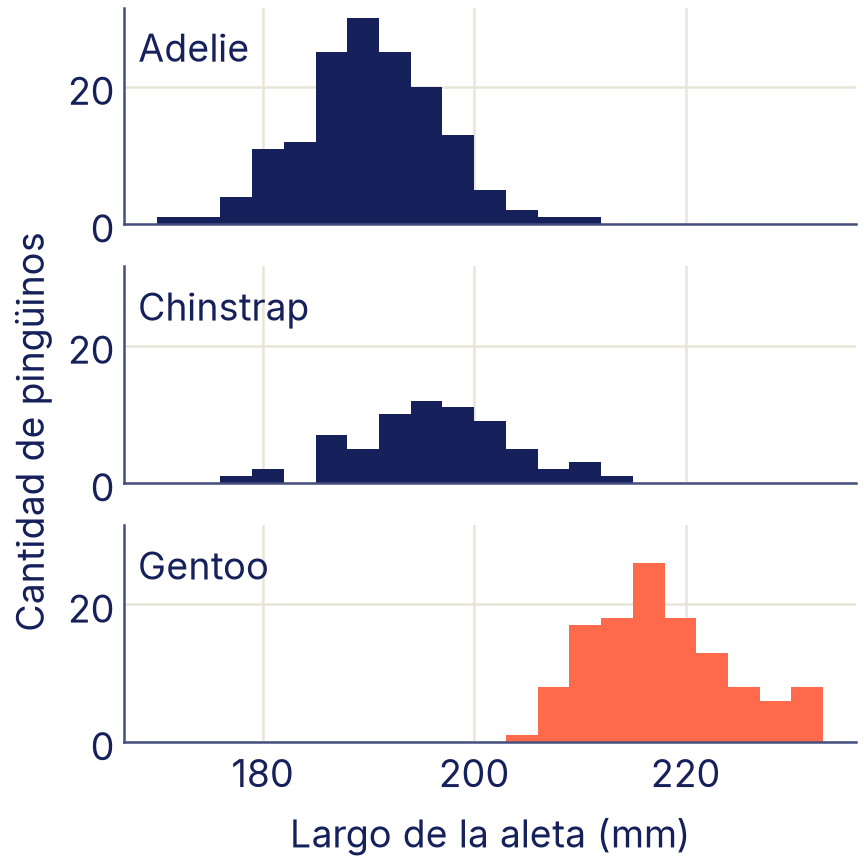
El montículo de la derecha son los Gentoo. Adelie y Chinstrap tienen aletas parecidas y forman juntos el montículo de la izquierda. Fíjate en dos detalles del código: los tres ejes comparten la escala (sharex, sharey) y los mismos intervalos, porque si no, comparar sería engañoso.
Dispersión: la relación entre dos medidas
Para saber cómo se relacionan dos medidas numéricas se usa un gráfico de dispersión: un punto por pingüino. Aquí entra Seaborn, una librería construida sobre Matplotlib que entiende los DataFrame: le pasas la tabla y los nombres de las columnas, y con hue colorea por una categoría. Con palette elegimos el color de cada especie y con style, la forma del punto, para que se distingan también sin color.
colores = {"Adelie": "C0", "Chinstrap": "C2", "Gentoo": "C1"}
ax = sns.scatterplot(data=pinguinos, x="pico_largo_mm",
                     y="pico_alto_mm", hue="especie",
                     style="especie", palette=colores)
ax.set_xlabel("Largo del pico (mm)")
ax.set_ylabel("Alto del pico (mm)")
ax.set_title("Cada especie forma su propia nube")
# Un poco de espacio arriba para la leyenda, en una sola fila
ax.set_ylim(13, 24)
ax.legend(title=None, fontsize=13, ncols=3, loc="upper left",
          columnspacing=0.8, handletextpad=0.1)
plt.show()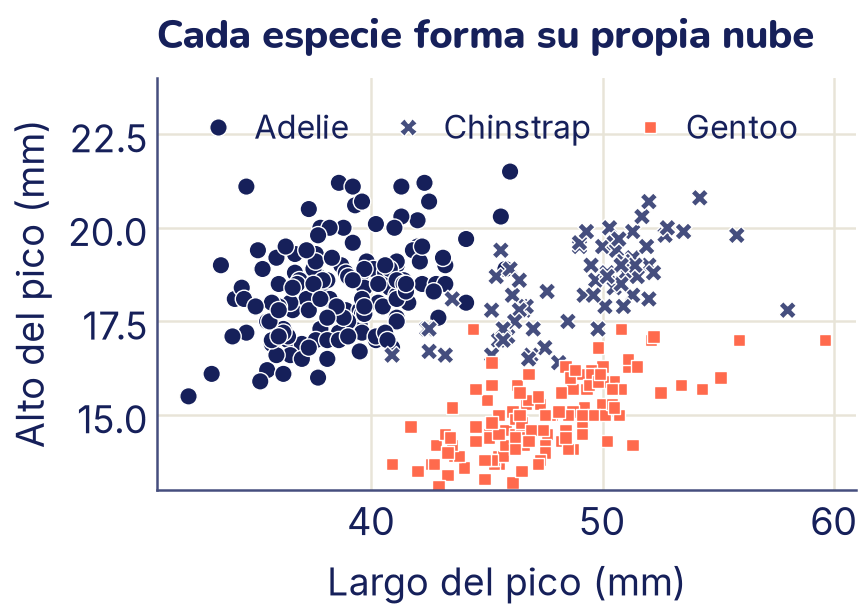
Esta figura responde la pregunta del tema: con solo dos medidas del pico, las tres especies quedan casi separadas. Adelie tiene el pico corto y alto; Chinstrap, largo y alto; Gentoo, largo y bajo. Un modelo que clasifique pingüinos (tema 8) va a tener muy fácil esta tarea. El histograma de las aletas no separaba a Adelie de Chinstrap; el pico, sí.
Diagrama de caja y valores atípicos
Un diagrama de caja resume una medida con cinco números y sirve para comparar grupos. La caja va del primer al tercer cuartil y la raya del medio es la mediana. La altura de la caja es el rango intercuartílico, RIC = Q3 − Q1. Los bigotes llegan hasta el dato más extremo que no está demasiado lejos de la caja, y los puntos que quedan fuera se marcan como atípicos. La regla más usada:
def atipicos(serie):
    """True donde el valor cae fuera de los bigotes (regla 1,5·RIC)."""
    q1, q3 = serie.quantile(0.25), serie.quantile(0.75)
    ric = q3 - q1
    return (serie < q1 - 1.5 * ric) | (serie > q3 + 1.5 * ric)

print("Atípicos con todos juntos:", atipicos(pinguinos["masa_g"]).sum())
# transform aplica la función a cada especie por separado
es_atipico = pinguinos.groupby("especie")["masa_g"].transform(atipicos)
print(pinguinos.loc[es_atipico, ["especie", "isla", "masa_g", "sexo"]])

orden = ["Adelie", "Chinstrap", "Gentoo"]
ax = sns.boxplot(data=pinguinos, x="especie", y="masa_g", order=orden,
                 color="C3", linecolor="C0", saturation=1,
                 showfliers=False)
# Los atípicos, dibujados aparte para resaltarlos
sns.stripplot(data=pinguinos[es_atipico], x="especie", y="masa_g",
              order=orden, color="C1", size=9, jitter=False, ax=ax)
ax.set_xlabel("")
ax.set_ylabel("Masa (g)")
ax.set_title("Masa por especie")
plt.show()
Atípicos con todos juntos: 0
especie isla masa_g sexo
189 Chinstrap Dream 4800.0 macho
190 Chinstrap Dream 2700.0 hembra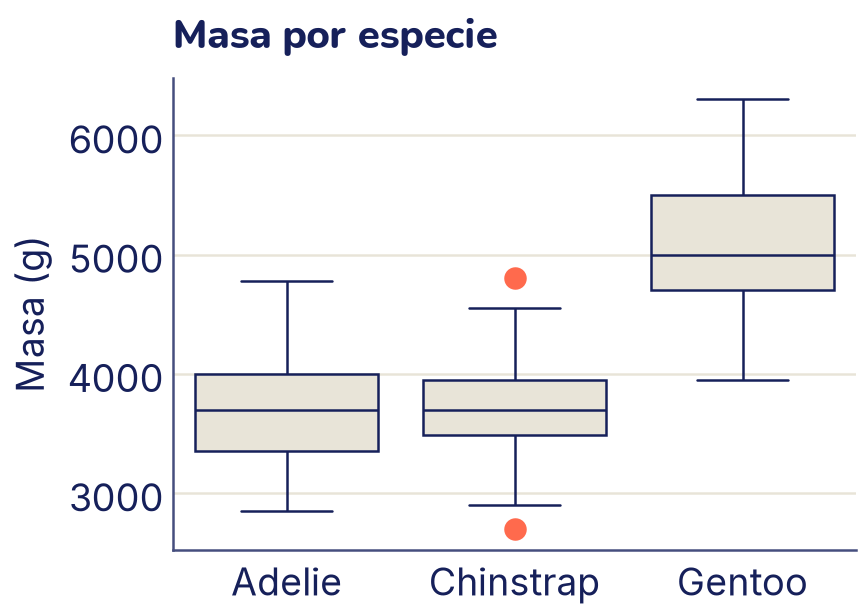
Mirando todos los pingüinos juntos no hay ningún atípico, pero dentro de los Chinstrap hay dos: uno muy liviano y uno muy pesado para su especie. Ser atípico depende del grupo con que se compara.
Un atípico no es lo mismo que un error. Un pingüino de 4,8 kg es posible; uno de 48 kg sería un error de tipeo. Ante un atípico, primero se investiga: si es un error, se corrige o se saca; si es real, se deja y se tiene en cuenta, porque puede pesar mucho en un promedio (lo viste con el MSE si ya llegaste al tema 6, y lo vas a ver ahí).
Correlación y mapa de calor
La correlación mide qué tan bien una recta describe la relación entre dos columnas. Es un número entre −1 y 1: cerca de 1, cuando una sube la otra también; cerca de −1, cuando una sube la otra baja; cerca de 0, no hay relación lineal. corr() la calcula para todos los pares de columnas, y un mapa de calor pinta esa tabla con colores.
Seaborn trae sus propias paletas de colores; aquí armamos una con LinearSegmentedColormap, que va del blanco a la tinta, y coloreamos según la fuerza de la relación (el valor absoluto, abs()): cuanto más oscura la casilla, más fuerte la relación, sea positiva o negativa. El signo queda escrito en cada casilla gracias a annot.
from matplotlib.colors import LinearSegmentedColormap

corr = pinguinos[medidas].corr()
print(corr.round(2))

# \n parte la etiqueta en dos líneas
nombres = ["Pico\nlargo", "Pico\nalto", "Aleta", "Masa"]
blanco_tinta = LinearSegmentedColormap.from_list("bt", ["white", "C0"])
fig, ax = plt.subplots(figsize=(4.8, 4.2))
sns.heatmap(corr.abs(), annot=corr, fmt=".2f", cmap=blanco_tinta,
            vmin=0, vmax=1, square=True, cbar=False,
            xticklabels=nombres, yticklabels=nombres, ax=ax)
ax.tick_params(axis="both", labelrotation=0)
ax.set_title("Correlación entre las medidas")
plt.show()
pico_largo_mm pico_alto_mm aleta_mm masa_g
pico_largo_mm 1.00 -0.24 0.66 0.60
pico_alto_mm -0.24 1.00 -0.58 -0.47
aleta_mm 0.66 -0.58 1.00 0.87
masa_g 0.60 -0.47 0.87 1.00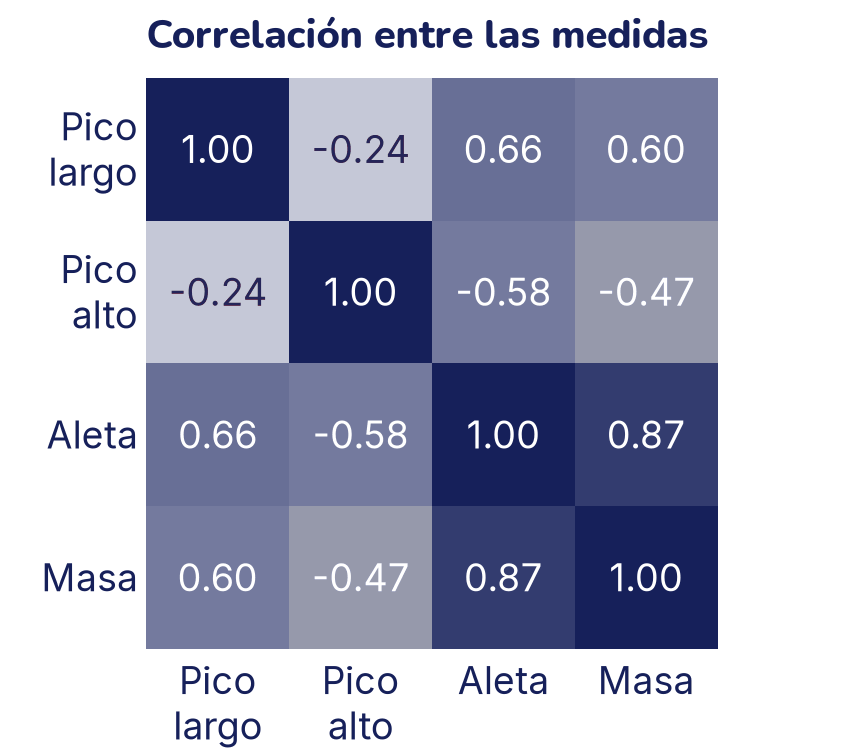
La relación más fuerte es entre la aleta y la masa: 0,87. Los pingüinos con aletas largas suelen pesar más. Pero correlación no es causalidad: las aletas largas no hacen pesar más a un pingüino. Las dos medidas crecen con el tamaño del animal, y el tamaño depende sobre todo de la especie. Cuando una tercera variable mueve a las otras dos, se dice que es una variable de confusión.
Fíjate también en el alto del pico: su correlación con las demás medidas es negativa. ¿Un pico más alto en un pingüino más chico? Otra vez la especie: los Gentoo son los más grandes y tienen el pico más bajo. Lo vas a desarmar en los ejercicios.
Barras y líneas
Un gráfico de barras compara cantidades entre categorías. Los DataFrame de pandas también saben graficarse: .plot.bar() usa Matplotlib por dentro. Con pd.crosstab contamos cuántos pingüinos hay de cada especie en cada isla y apilamos las barras:
conteo = pd.crosstab(pinguinos["isla"], pinguinos["especie"])
print(conteo)

ax = conteo.plot.bar(stacked=True, color=["C0", "C2", "C1"], rot=0)
ax.set_xlabel("Isla")
ax.set_ylabel("Cantidad de pingüinos")
ax.set_title("¿Quién vive en cada isla?")
ax.legend(title=None, fontsize=13)
plt.show()
especie Adelie Chinstrap Gentoo
isla
Biscoe 44 0 123
Dream 56 68 0
Torgersen 51 0 0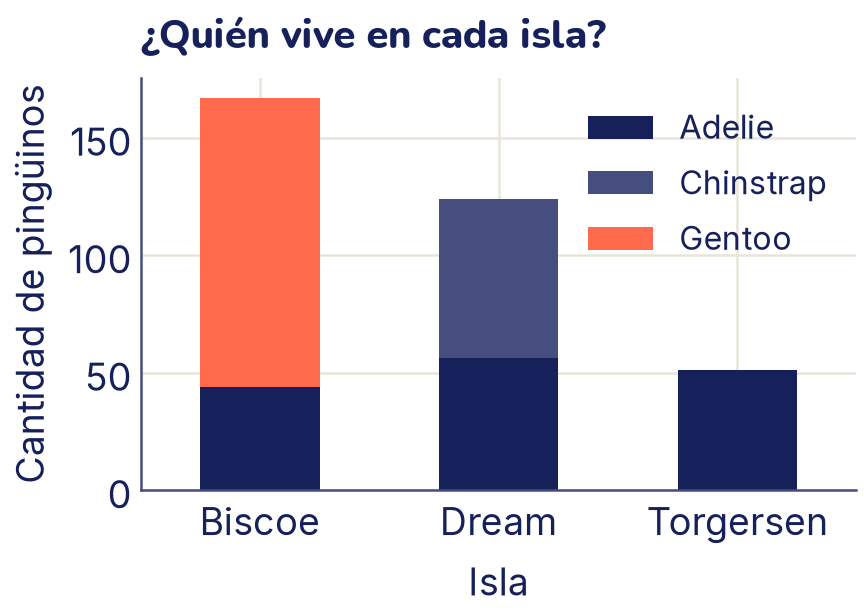
Un gráfico de línea sirve cuando el eje x tiene un orden natural, casi siempre el tiempo: la línea une un mes con el siguiente. Los pingüinos no tienen fechas, así que usamos otro dataset de Seaborn: la cantidad mensual de pasajeros de vuelos internacionales entre 1949 y 1960, en miles, una serie clásica del libro de Box y Jenkins sobre series de tiempo. Para que pandas entienda el tiempo, convertimos el año y el mes en una columna de tipo fecha con pd.to_datetime. Su tipo es datetime64 (lo que va entre corchetes, la precisión, puede cambiar según la versión de pandas).
vuelos = sns.load_dataset("flights")
print(vuelos.head(3))

# "1949" + "-" + "Jan" → fecha; %Y es el año y %b, el mes abreviado
texto = vuelos["year"].astype(str) + "-" + vuelos["month"].astype(str)
vuelos["fecha"] = pd.to_datetime(texto, format="%Y-%b")
print(vuelos["fecha"].dtype)

mayor = vuelos.loc[vuelos["passengers"].idxmax()]
print("Mes con más pasajeros:", mayor["fecha"].strftime("%m/%Y"),
      "con", mayor["passengers"], "mil")

fig, ax = plt.subplots()
ax.plot(vuelos["fecha"], vuelos["passengers"], color="C0")
ax.scatter(mayor["fecha"], mayor["passengers"], color="C1", s=60,
           zorder=3)
ax.set_ylabel("Pasajeros (miles)")
ax.set_title("Pasajeros de vuelos por mes")
plt.show()
year month passengers
0 1949 Jan 112
1 1949 Feb 118
2 1949 Mar 132
datetime64[us]
Mes con más pasajeros: 07/1960 con 622 mil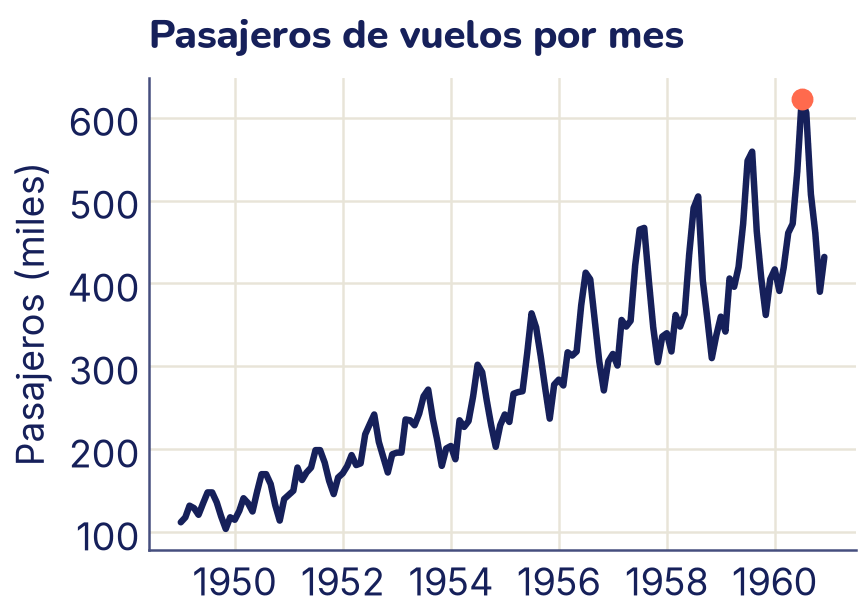
La línea muestra dos cosas que una tabla de 144 números escondería: una tendencia (los pasajeros se multiplican por más de cuatro en doce años) y una estacionalidad (cada año hay un pico a mitad de año, en el verano del hemisferio norte, y el pico crece con los años). Las series de tiempo vuelven en el tema 13.
¿Qué gráfico para qué pregunta?
| Pregunta | Gráfico |
|---|---|
| ¿Cómo se reparten los valores de una medida? | Histograma |
| ¿Cómo se relacionan dos medidas? | Dispersión |
| ¿Cómo se compara una medida entre grupos? ¿Hay atípicos? | Caja |
| ¿Qué pares de medidas van juntos? | Mapa de calor de correlaciones |
| ¿Cuánto hay de cada categoría? | Barras |
| ¿Cómo cambia algo con el tiempo? | Línea |
El cuarteto de Anscombe
En 1973, el estadístico Francis Anscombe armó cuatro conjuntos de once puntos para demostrar por qué hay que graficar. Son los de la actividad, y Seaborn los trae:
anscombe = sns.load_dataset("anscombe")
resumen = anscombe.groupby("dataset").agg(
    media_x=("x", "mean"), media_y=("y", "mean"),
    desv_x=("x", "std"), desv_y=("y", "std"))
resumen["correlacion"] = [g["x"].corr(g["y"])
                          for _, g in anscombe.groupby("dataset")]
print(resumen.round(2))

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8), sharex=True,
                         sharey=True)
x_recta = np.array([3, 20])
for ax, (nombre, g) in zip(ejes.flat, anscombe.groupby("dataset")):
    ax.scatter(g["x"], g["y"], color="C0", s=30)
    # La recta que mejor se ajusta (la vas a calcular en el tema 6)
    pendiente, corte = np.polyfit(g["x"], g["y"], 1)
    ax.plot(x_recta, pendiente * x_recta + corte, color="C2",
            linewidth=1.6)
    ax.set_title(nombre)
plt.show()
media_x media_y desv_x desv_y correlacion
dataset
I 9.0 7.5 3.32 2.03 0.82
II 9.0 7.5 3.32 2.03 0.82
III 9.0 7.5 3.32 2.03 0.82
IV 9.0 7.5 3.32 2.03 0.82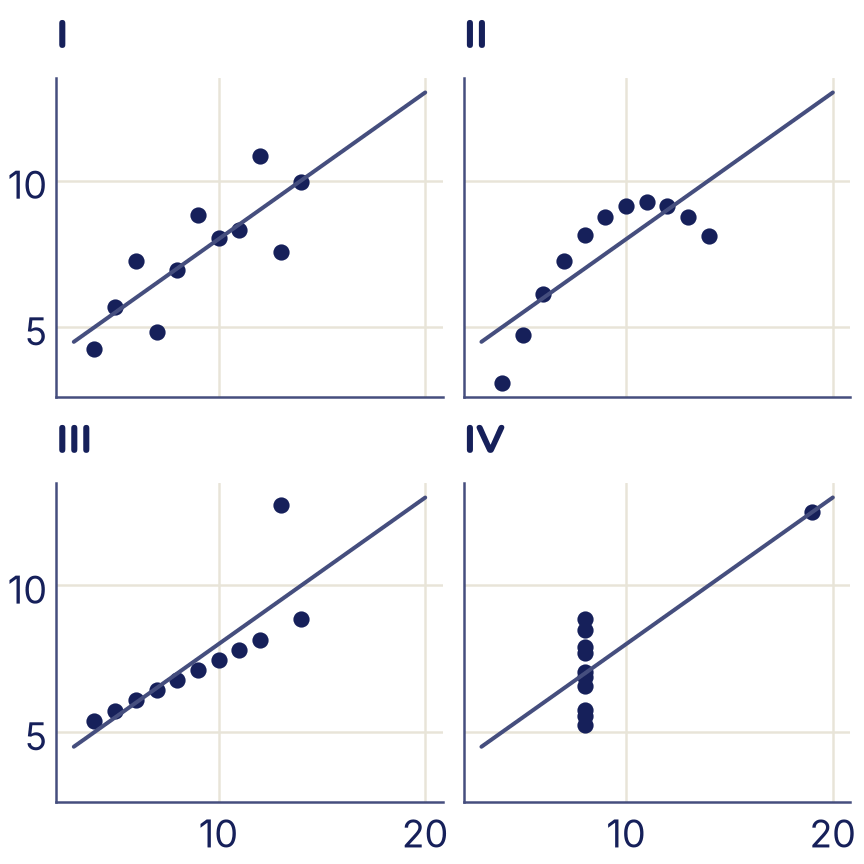
Los cuatro resúmenes son prácticamente iguales, y también la recta. Pero solo en el conjunto I la recta es una buena descripción. En el II la relación es una curva; en el III un solo atípico inclina la recta; en el IV un único punto crea toda la correlación. Ningún resumen reemplaza a mirar los datos.
Un análisis exploratorio en cinco preguntas
Lo que hiciste con los pingüinos es un análisis exploratorio completo. Con cualquier dataset nuevo, hazte estas cinco preguntas, en orden:
- ¿Qué hay en la tabla?
shape,head,info: 344 pingüinos, 7 columnas, 4 numéricas y 3 categóricas. - ¿Qué falta?
isna().sum(): dos pingüinos sin medidas (los sacamos) y nueve sin sexo (los dejamos). - ¿Cómo se reparte cada medida?
describe,value_countse histogramas: las aletas son bimodales porque los Gentoo son más grandes. - ¿Cómo se relacionan las medidas? Dispersión y correlaciones: con el largo y el alto del pico las especies casi se separan; la aleta y la masa van muy juntas.
- ¿Hay atípicos o sorpresas? Cajas por grupo: dos Chinstrap fuera de lo común, pero reales; cada especie vive en islas distintas.
Cada respuesta termina en una conclusión escrita, una oración que cualquiera pueda comprobar mirando el gráfico. Un gráfico sin conclusión no le dice nada a nadie.
Lo que aprendiste y lo que sigue
- Un DataFrame es una tabla con columnas de distinto tipo; cada columna es una Series, un arreglo de NumPy con nombre e índice.
info,describeyvalue_countsdan el primer panorama;isna().sum()cuenta los faltantes, y la regla del 1,5·RIC señala los atípicos, que hay que investigar antes de borrar.locelige por etiqueta,ilocpor posición, y una condición filtra filas.groupbysepara, resume y junta;mergeune tablas por una clave.- Cada pregunta tiene su gráfico: histograma, dispersión, caja, mapa de calor, barras o línea. Matplotlib dibuja en una figura con ejes, y Seaborn grafica directo desde un DataFrame.
- Los resúmenes pueden esconder la forma de los datos (Anscombe), el número de intervalos cambia lo que muestra un histograma, y correlación no es causalidad.
En el tema 5 vas a usar estas tablas para calcular promedios, desviaciones y probabilidades con código. Desde el tema 6, cada modelo empezará con un análisis exploratorio como este.