Antes de empezar
Los ejercicios usan lo que se definió en la teoría: pinguinos (ya sin las dos filas sin medidas), medidas, especies, atipicos, colores y las librerías np, pd, plt y sns. Abre un cuaderno nuevo en Colab, pega y ejecuta en orden los bloques de la ficha Código y después trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta: equivocarse primero y corregir después es como se aprende de verdad.
Ejercicios
1. Diez preguntas cortas
Responde cada pregunta con una o dos líneas de pandas.
- ¿Cuántas filas y columnas tiene
pinguinos? - ¿Cuál es la aleta más larga?
- ¿Cuántas hembras hay?
- ¿En cuántas islas distintas vive cada especie?
- ¿Cuál es la masa media de los machos y de las hembras?
- ¿Cuántos Gentoo pesan menos de 4 kg?
- ¿De qué especie e isla es el pingüino más liviano, y cuánto pesa?
- ¿Cuál es la mediana del largo del pico de cada especie?
- ¿Qué porcentaje de los pingüinos vive en cada isla?
- Agrega una columna
masa_kgcon la masa en kilos. ¿Cuál es su promedio?
Respuesta
# 1
print(pinguinos.shape)
# 2
print(pinguinos["aleta_mm"].max())
# 3
print((pinguinos["sexo"] == "hembra").sum())
# 4
print(pinguinos.groupby("especie")["isla"].nunique())
# 5
print(pinguinos.groupby("sexo")["masa_g"].mean().round(0))
# 6
gentoo = pinguinos[pinguinos["especie"] == "Gentoo"]
print((gentoo["masa_g"] < 4000).sum())
# 7: idxmin da la etiqueta de la fila con el valor más chico
print(pinguinos.loc[pinguinos["masa_g"].idxmin(),
                    ["especie", "isla", "masa_g"]])
# 8
print(pinguinos.groupby("especie")["pico_largo_mm"].median())
# 9: normalize=True da proporciones en lugar de conteos
print((pinguinos["isla"].value_counts(normalize=True) * 100).round(1))
# 10
pinguinos["masa_kg"] = pinguinos["masa_g"] / 1000
print(round(pinguinos["masa_kg"].mean(), 2))
(342, 7)
231.0
165
especie
Adelie 3
Chinstrap 1
Gentoo 1
Name: isla, dtype: int64
sexo
hembra 3862.0
macho 4546.0
Name: masa_g, dtype: float64
1
especie Chinstrap
isla Dream
masa_g 2700.0
Name: 190, dtype: object
especie
Adelie 38.80
Chinstrap 49.55
Gentoo 47.30
Name: pico_largo_mm, dtype: float64
isla
Biscoe 48.8
Dream 36.3
Torgersen 14.9
Name: proportion, dtype: float64
4.2Fíjate en el 5: groupby deja fuera a los nueve pingüinos sin sexo, porque NaN no es un grupo. Y en el 3: comparar con == da False donde falta el dato, así que esos nueve tampoco se cuentan como hembras.
2. Guardar y volver a leer un CSV
a) Guarda pinguinos en un archivo pinguinos.csv con to_csv(..., index=False), léelo de nuevo con pd.read_csv y revisa la copia con info(). ¿Tiene las mismas filas y columnas? ¿Siguen ahí los faltantes del sexo?
b) Guárdalo otra vez, ahora sin index=False, y lee el archivo. ¿Qué columna nueva aparece?
Respuesta
pinguinos.to_csv("pinguinos.csv", index=False)
copia = pd.read_csv("pinguinos.csv")
copia.info()

pinguinos.to_csv("con_indice.csv")
print(pd.read_csv("con_indice.csv").columns[:3].tolist())
<class 'pandas.DataFrame'>
RangeIndex: 342 entries, 0 to 341
Data columns (total 8 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 especie 342 non-null str
1 isla 342 non-null str
2 pico_largo_mm 342 non-null float64
3 pico_alto_mm 342 non-null float64
4 aleta_mm 342 non-null float64
5 masa_g 342 non-null float64
6 sexo 333 non-null str
7 masa_kg 342 non-null float64
dtypes: float64(5), str(3)
memory usage: 21.5 KB
['Unnamed: 0', 'especie', 'isla']a) La copia tiene las mismas 342 filas y 8 columnas (con masa_kg del ejercicio 1), y los mismos 9 faltantes en sexo: en el CSV un faltante es una casilla vacía, y read_csv lo vuelve a leer como NaN.
b) Sin index=False, el índice se guarda como una columna sin nombre, y al leerla aparece como Unnamed: 0. Es uno de los errores más comunes: por eso conviene guardar con index=False, salvo que el índice tenga información.
3. Los faltantes de la tabla original
Vuelve a cargar los datos sin limpiar: crudo = sns.load_dataset("penguins").
a) ¿Cuántas filas tienen al menos un faltante?
b) ¿Qué porcentaje de las filas no tiene el sexo anotado?
c) Si hicieras crudo.dropna(), ¿cuántos pingüinos perderías? ¿Por qué en la teoría no lo hicimos así?
Respuesta
crudo = sns.load_dataset("penguins")
con_faltantes = crudo.isna().any(axis=1)
print("Filas con algún faltante:", con_faltantes.sum())
print(f"Sin sexo: {crudo['sex'].isna().mean() * 100:.1f} %")
print("Filas después de dropna():", len(crudo.dropna()))
Filas con algún faltante: 11
Sin sexo: 3.2 %
Filas después de dropna(): 333a) Once filas tienen algún faltante: las 11 sin sexo, que incluyen a los dos pingüinos sin ninguna medida.
b) El promedio de una columna de True y False es la proporción de True: el 3,2 % de las filas no tiene sexo.
c) dropna() sin más borra 11 pingüinos. Nueve de ellos tienen todas sus medidas, que sirven para cualquier pregunta que no use el sexo. Por eso en la teoría solo borramos las filas sin medidas, con dropna(subset=medidas). La regla: borra solo lo que la pregunta necesita, y di qué borraste.
4. Atípicos en el largo del pico
a) Usa la función atipicos de la teoría para buscar valores atípicos en el largo del pico, primero mirando a todos los pingüinos juntos y después dentro de cada especie.
b) ¿Te parece un error de medición? ¿Qué harías con ese pingüino?
Respuesta
pico = pinguinos["pico_largo_mm"]
print("Todos juntos:", atipicos(pico).sum())
raro = pinguinos.groupby("especie")["pico_largo_mm"].transform(atipicos)
print(pinguinos.loc[raro, ["especie", "isla", "pico_largo_mm", "sexo"]])
print(pinguinos.groupby("especie")["pico_largo_mm"]
      .describe()[["mean", "75%", "max"]].round(1))
# Los tres picos más largos de todo el dataset
print(pico.nlargest(3).tolist())
Todos juntos: 0
especie isla pico_largo_mm sexo
253 Gentoo Biscoe 59.6 macho
mean 75% max
especie
Adelie 38.8 40.8 46.0
Chinstrap 48.8 51.1 58.0
Gentoo 47.5 49.6 59.6
[59.6, 58.0, 55.9]a) Juntos no hay atípicos; dentro de cada especie, uno: un Gentoo macho con un pico de 59,6 mm, el más largo de todo el dataset.
b) Su pico es unos 12 mm más largo que el promedio de los Gentoo, pero no es imposible: el segundo pico más largo del dataset, de un Chinstrap, mide 58 mm, apenas 1,6 mm menos. No hay razón para creer que es un error de tipeo, así que lo dejamos y, si un análisis depende mucho de él (por ejemplo, un promedio de pocos datos), lo decimos. Un atípico se investiga; no se borra solo por ser raro.
5. Unir tablas cuando falta una clave
Supón que la tabla de nombres se escribió incompleta y le falta la fila de Chinstrap:
incompleta = especies[especies["especie"] != "Chinstrap"]
print(incompleta[["especie", "nombre_comun"]])
especie nombre_comun
0 Adelie pingüino de Adelia
2 Gentoo pingüino papúaa) Únela a pinguinos con how="left" y con how="inner". ¿Cuántas filas tiene cada resultado?
b) En la unión con how="left", ¿cuántos faltantes tiene nombre_comun, y de qué especie son?
c) ¿Qué peligro tiene usar how="inner" sin revisar el resultado?
Respuesta
izquierda = pinguinos.merge(incompleta, on="especie", how="left")
interna = pinguinos.merge(incompleta, on="especie", how="inner")
print("left: ", izquierda.shape)
print("inner:", interna.shape)
faltan = izquierda[izquierda["nombre_comun"].isna()]
print(faltan["especie"].value_counts())
left: (342, 10)
inner: (274, 10)
especie
Chinstrap 68
Name: count, dtype: int64a) Con how="left" quedan las 342 filas; con how="inner", solo las 274 cuya especie está en las dos tablas.
b) Los 68 Chinstrap quedan con NaN en nombre_comun.
c) how="inner" borra en silencio las filas sin pareja: aquí desaparece una especie entera y nada avisa. Después de un merge, compara siempre la cantidad de filas con la que esperabas.
6. ¿Qué gráfico usarías?
Para cada pregunta, elige el gráfico y di qué columnas pondrías en cada eje.
- ¿Los machos pesan más que las hembras en cada especie?
- ¿Cómo se reparte el largo del pico de los Adelie?
- ¿Hay relación entre el largo de la aleta y el largo del pico?
- ¿Cuántos pingüinos se midieron de cada sexo?
- ¿Qué par de medidas está más relacionado?
- ¿Cómo cambió la cantidad de pasajeros de enero a diciembre de 1955?
Respuesta
- Caja: la especie en x, la masa en y, y una caja por sexo (
hue="sexo"ensns.boxplot). Compara grupos y muestra atípicos. - Histograma del largo del pico, filtrando antes a los Adelie.
- Dispersión: aleta en x, pico en y, con color por especie para no mezclar grupos.
- Barras: una barra por sexo con su conteo (
value_counts().plot.bar()). - Mapa de calor de la matriz de correlación.
- Línea: los meses de 1955 en x, en orden, y los pasajeros en y.
7. Tres gráficos engañosos
Cada gráfico de abajo lleva a una conclusión equivocada. Para cada uno, di qué conclusión sugiere, por qué engaña y escribe el código de una versión honesta.
a) «Los Gentoo pesan casi el triple que los Adelie».
masa_media = pinguinos.groupby("especie")["masa_g"].mean()
fig, ax = plt.subplots()
ax.bar(masa_media.index, masa_media, color="C0")
ax.set_ylim(3600, 5200)
ax.set_ylabel("Masa media (g)")
ax.set_title("Masa media por especie")
plt.show()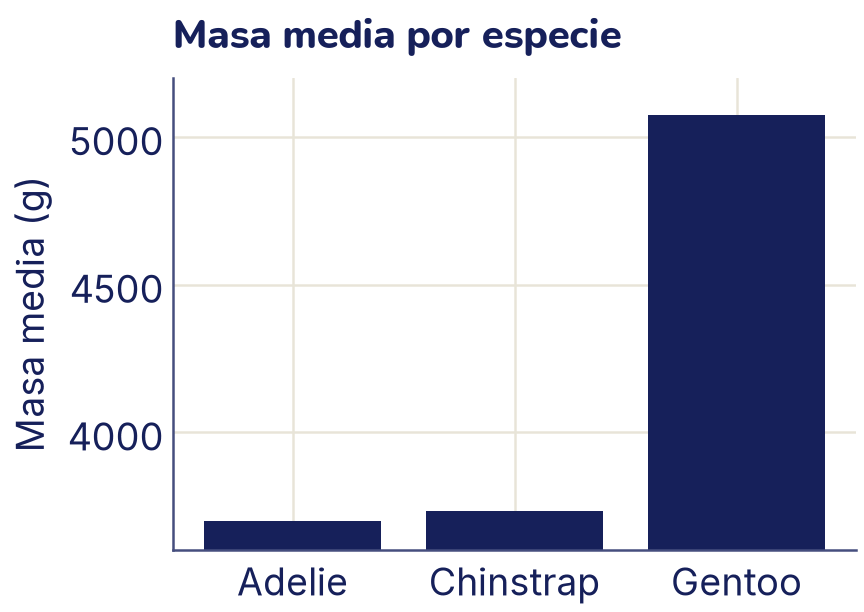
b) «La cantidad de pingüinos baja de isla en isla».
por_isla = pinguinos["isla"].value_counts()
fig, ax = plt.subplots()
ax.plot(por_isla.index, por_isla, color="C0", marker="o")
ax.set_ylabel("Cantidad de pingüinos")
ax.set_title("Pingüinos por isla")
plt.show()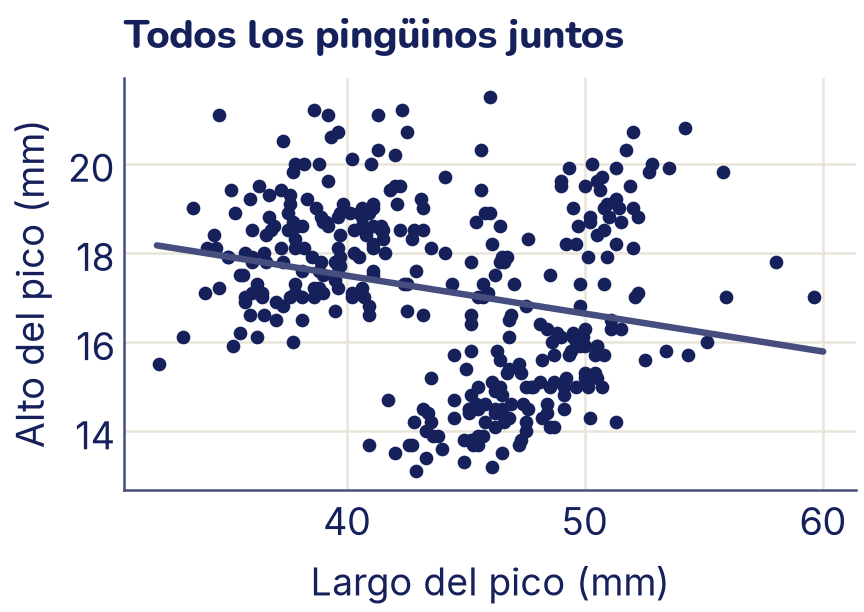
c) «A pico más largo, pico menos alto».
fig, ax = plt.subplots()
ax.scatter(pinguinos["pico_largo_mm"], pinguinos["pico_alto_mm"],
           color="C0", s=20)
pendiente, corte = np.polyfit(pinguinos["pico_largo_mm"],
                              pinguinos["pico_alto_mm"], 1)
x_recta = np.array([32, 60])
ax.plot(x_recta, pendiente * x_recta + corte, color="C2")
ax.set_xlabel("Largo del pico (mm)")
ax.set_ylabel("Alto del pico (mm)")
ax.set_title("Todos los pingüinos juntos")
plt.show()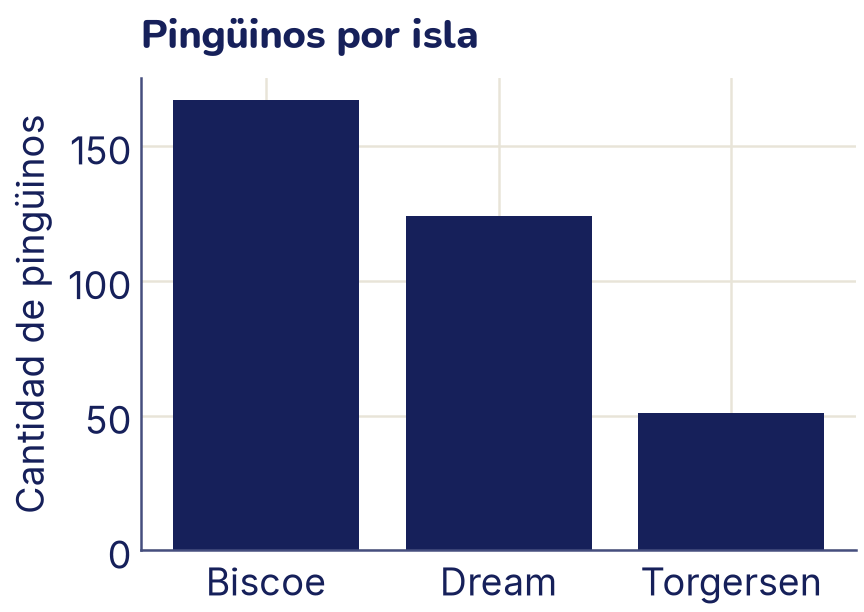
Respuesta
a) El eje y empieza en 3600 g, no en 0. El largo de una barra se lee como la cantidad, así que una diferencia de un 37 % se ve como si fuera del triple. En un gráfico de barras, el eje empieza en cero.
print((masa_media / masa_media["Adelie"]).round(2))
fig, ax = plt.subplots()
colores_barras = ["C1" if e == "Gentoo" else "C0"
                  for e in masa_media.index]
ax.bar(masa_media.index, masa_media, color=colores_barras)
ax.set_ylim(0, 5500)
ax.set_ylabel("Masa media (g)")
ax.set_title("Masa media por especie")
plt.show()
especie
Adelie 1.00
Chinstrap 1.01
Gentoo 1.37
Name: masa_g, dtype: float64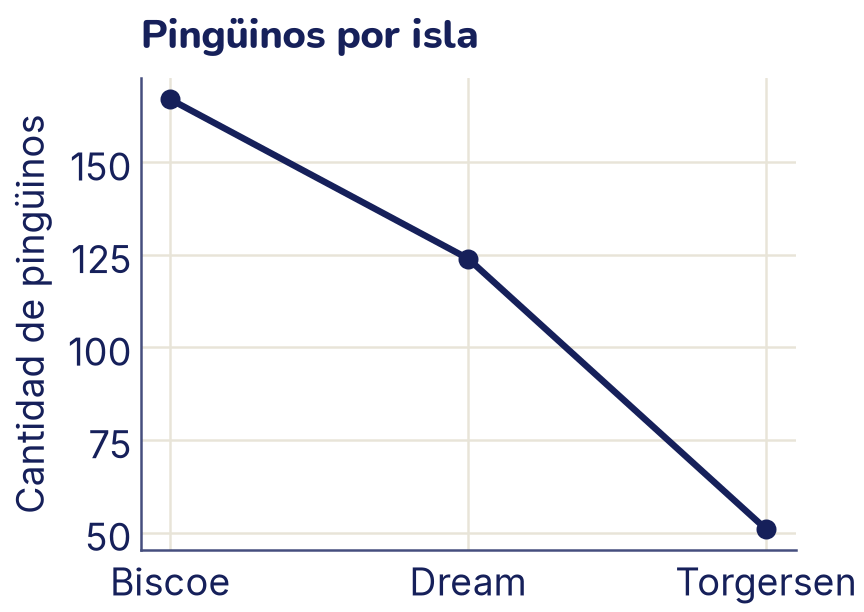
Los Gentoo pesan un 37 % más que los Adelie: bastante, pero no el triple.
b) Una línea dice «hay un orden y algo cambia de un punto al siguiente», como en el tiempo. Las islas no tienen orden: value_counts las ordenó de mayor a menor, y por eso la línea «baja». Para contar categorías se usan barras.
fig, ax = plt.subplots()
ax.bar(por_isla.index, por_isla, color="C0")
ax.set_ylabel("Cantidad de pingüinos")
ax.set_title("Pingüinos por isla")
plt.show()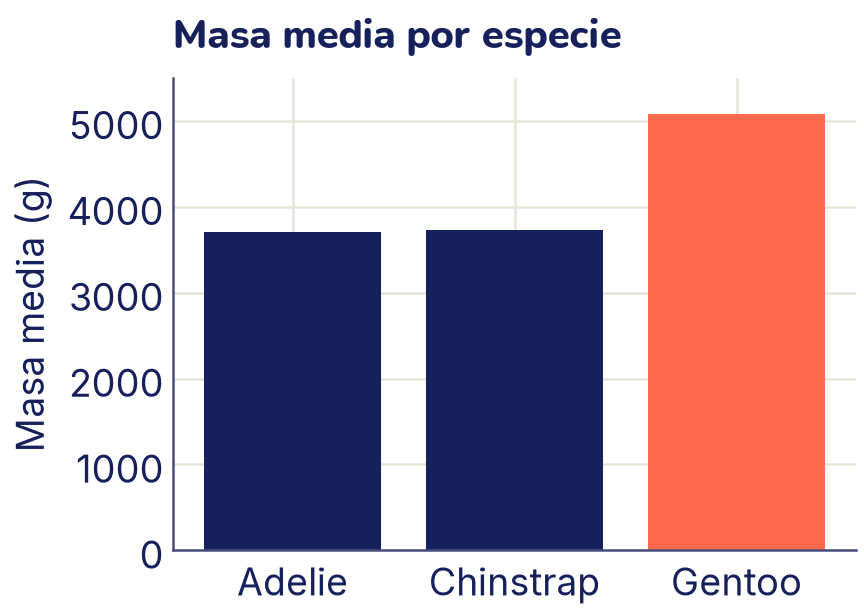
c) Mezcla tres especies distintas. Con todos juntos la correlación es negativa, pero dentro de cada especie es positiva: a pico más largo, pico más alto. La recta baja solo porque los Gentoo tienen picos largos y bajos. Cuando una relación se invierte al separar por grupos se habla de la paradoja de Simpson, y la especie es la variable de confusión.
print("Todos:", round(pinguinos["pico_largo_mm"]
                      .corr(pinguinos["pico_alto_mm"]), 2))
for especie, g in pinguinos.groupby("especie"):
    r = g["pico_largo_mm"].corr(g["pico_alto_mm"])
    print(f"{especie}: {r:.2f}")

fig, ax = plt.subplots()
for especie, g in pinguinos.groupby("especie"):
    ax.scatter(g["pico_largo_mm"], g["pico_alto_mm"],
               color=colores[especie], s=20, label=especie)
    m, c = np.polyfit(g["pico_largo_mm"], g["pico_alto_mm"], 1)
    x = np.array([g["pico_largo_mm"].min(), g["pico_largo_mm"].max()])
    ax.plot(x, m * x + c, color=colores[especie])
ax.set_ylim(13, 24)
ax.set_xlabel("Largo del pico (mm)")
ax.set_ylabel("Alto del pico (mm)")
ax.set_title("Separados por especie")
ax.legend(fontsize=13, ncols=3, loc="upper left", columnspacing=0.8,
          handletextpad=0.1)
plt.show()
Todos: -0.24
Adelie: 0.39
Chinstrap: 0.65
Gentoo: 0.64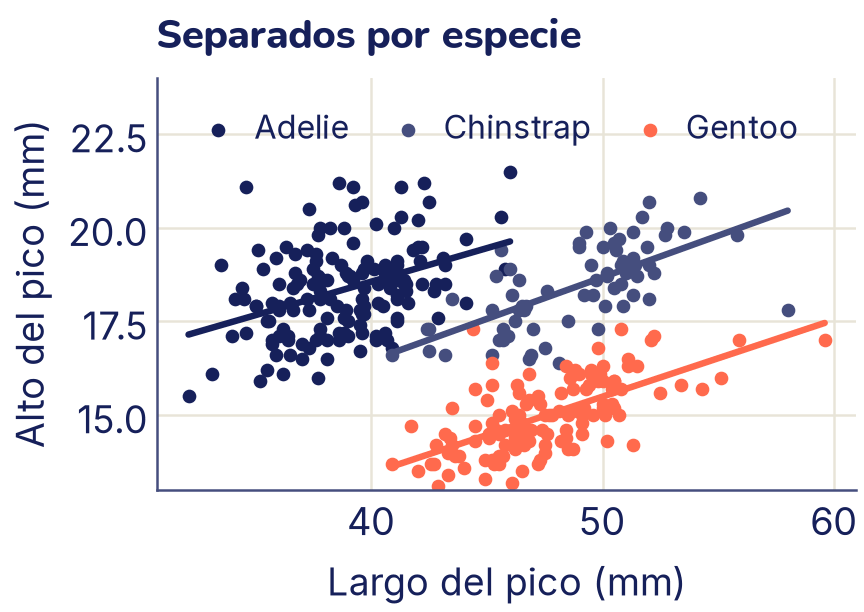
8. De un gráfico a una conclusión
En el mapa de calor de la teoría, la correlación entre la aleta y la masa es 0,87.
a) Escribe una conclusión correcta, en una oración, a partir de ese número.
b) Una compañera escribe: «Las aletas largas hacen que los pingüinos pesen más». ¿Qué le dirías?
c) ¿La relación entre la aleta y la masa sigue existiendo dentro de cada especie? Calcúlalo.
Respuesta
a) Por ejemplo: «En estos 342 pingüinos, los que tienen la aleta más larga suelen pesar más; la relación es fuerte y casi lineal».
b) Que la correlación no dice qué causa qué. Las dos medidas crecen con el tamaño del cuerpo, y los pingüinos más grandes son casi todos Gentoo. Para hablar de causas haría falta un experimento, o por lo menos descartar las variables de confusión.
for especie, g in pinguinos.groupby("especie"):
    print(f"{especie}: {g['aleta_mm'].corr(g['masa_g']):.2f}")
Adelie: 0.47
Chinstrap: 0.64
Gentoo: 0.70c) Sí, pero más débil: dentro de cada especie la correlación baja a valores entre 0,47 y 0,70. Parte del 0,87 venía de mezclar especies de tamaños distintos.
Mini-proyecto: un informe exploratorio de una página
Elige un dataset y escribe un informe de una página con tres gráficos y tres conclusiones. Algunas opciones que traen las librerías:
sns.load_dataset("titanic"): los pasajeros del Titanic, si sobrevivieron, su clase, su sexo y su edad.sns.load_dataset("tips"): las cuentas y las propinas de un restaurante.sklearn.datasets.load_wine(as_frame=True).frame: análisis químicos de 178 vinos de tres variedades (no necesita internet).
El informe sigue las cinco preguntas de la teoría:
- Qué hay: de dónde salen los datos, cuántas filas y columnas, qué significa cada columna que uses.
- Qué falta: los faltantes de cada columna y qué hiciste con ellos.
- Tres preguntas, cada una con su gráfico (de tipo adecuado, con ejes en español y título) y una conclusión escrita en una oración que se pueda comprobar mirando el gráfico.
- Una advertencia: algo que tus datos no permiten concluir (una causa, una generalización a otra población).
Un ejemplo con el Titanic
titanic = sns.load_dataset("titanic")
print(titanic.shape)
print(titanic[["survived", "pclass", "sex", "age", "deck"]]
      .isna().sum())
print()
# El promedio de una columna de 0 y 1 es la proporción de 1
print("Sobrevivió:", round(titanic["survived"].mean() * 100, 1), "%")
tasa = (titanic.groupby(["pclass", "sex"])["survived"].mean() * 100)
print(tasa.round(1).unstack())
con_edad = titanic.dropna(subset=["age"])
ninos = con_edad["age"] < 12
print("Niños menores de 12:",
      round(con_edad.loc[ninos, "survived"].mean() * 100, 1), "%")
print("De 12 años o más:",
      round(con_edad.loc[~ninos, "survived"].mean() * 100, 1), "%")

tabla = tasa.unstack().rename(columns={"female": "Mujeres",
                                       "male": "Hombres"})
ax = tabla.plot.bar(color=["C1", "C0"], rot=0)
ax.set_xlabel("Clase del pasaje")
ax.set_ylabel("Sobrevivieron (%)")
ax.set_title("Supervivencia por clase y sexo")
ax.legend(title=None, fontsize=13)
plt.show()
(891, 15)
survived 0
pclass 0
sex 0
age 177
deck 688
dtype: int64
Sobrevivió: 38.4 %
sex female male
pclass
1 96.8 36.9
2 92.1 15.7
3 50.0 13.5
Niños menores de 12: 57.4 %
De 12 años o más: 38.9 %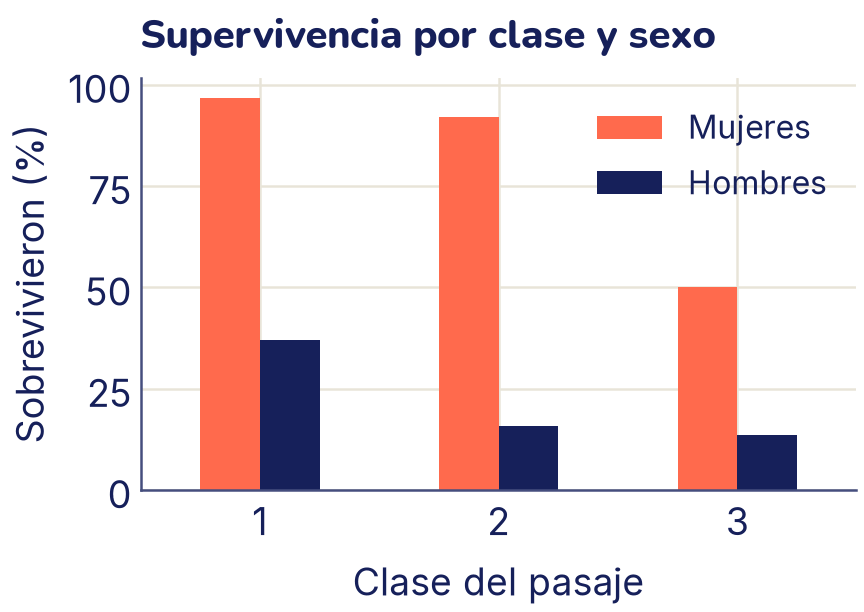
Tres conclusiones posibles, cada una con su gráfico:
- Sexo y clase (barras, arriba): en las tres clases sobrevivieron muchas más mujeres que hombres. Las mujeres de primera y segunda clase sobrevivieron en más del 90 %; las de tercera, la mitad.
- Edad (histograma de la edad, separado por
survived): los menores de 12 años sobrevivieron más que el resto. Ojo: a 177 pasajeros les falta la edad, y esa conclusión solo vale para los 714 que la tienen. - Cubierta (
deck): falta en 688 de 891 filas, así que no conviene sacar conclusiones con esa columna.
Advertencia: estos datos describen a los pasajeros de esta muestra; la tabla dice quién sobrevivió, no por qué.
Errores comunes
- Graficar sin mirar la tabla. Antes de cualquier gráfico:
shape,head,infoeisna().sum(). - Confundir
locconiloc.loc[0:2]incluye la fila con etiqueta 2;iloc[0:2]no incluye la posición 2. Después de filtrar o dedropna, las etiquetas ya no coinciden con las posiciones. - Olvidar los paréntesis en las condiciones.
pinguinos["masa_g"] > 4000 & pinguinos["aleta_mm"] > 200falla; cada condición va entre paréntesis y se usa&, noand. - Borrar todos los faltantes con
dropna()sin pensar. Borra solo lo que la pregunta necesita (subset=) y di cuántas filas sacaste. - Borrar atípicos porque sí. Un atípico puede ser real. Investígalo antes de decidir.
- Usar
how="inner"y no contar las filas. Unmergepuede perder o duplicar filas en silencio. - Promedios de grupos mezclados. Un promedio general puede no describir a nadie (las aletas bimodales) y una correlación puede invertirse al separar por grupos (paradoja de Simpson).
- Barras que no empiezan en cero, líneas entre categorías, muy pocos o demasiados intervalos. Son las formas más comunes de que un gráfico engañe, aunque los números sean correctos.
- Leer una correlación como una causa. Busca primero una variable de confusión.
- Gráficos sin ejes ni título. Quien lo mira tiene que saber qué se midió y en qué unidades.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Cargar un CSV en un
DataFramee inspeccionarlo coninfo,describeyvalue_counts(ejercicios 1 y 2, y paso 1 del mini-proyecto). - Filtrar, agrupar con
groupbyy unir tablas conmerge(ejercicios 1 y 5). - Detectar valores faltantes y atípicos, y decidir qué hacer con ellos (ejercicios 3 y 4).
- Elegir el gráfico adecuado para una pregunta y escribir una conclusión a partir de él (ejercicios 6, 7 y 8, y el mini-proyecto).