La pregunta
Imagina que estás en un cerro, de noche y con niebla, y quieres bajar al valle. No ves el camino ni el fondo; solo sientes con los pies hacia dónde se inclina el suelo. ¿Cómo eliges para dónde dar el próximo paso?
Esa es, casi palabra por palabra, la situación de un modelo de inteligencia artificial cuando aprende. El modelo no «ve» la mejor respuesta: solo puede medir, en el lugar donde está, hacia dónde baja su error, y dar un paso en esa dirección. Para eso necesita saber medir pendientes. Y como aprende de datos que traen ruido y azar, también necesita promedios para resumirlos y probabilidades para razonar con lo incierto.
En este tema no vas a memorizar fórmulas: vas a calcular cada idea con código y comprobarla con números y gráficos. Vas a:
- aproximar una derivada con la computadora y leerla como la pendiente de una curva;
- calcular el gradiente de una función de dos variables y ver que apunta cuesta arriba;
- calcular la media, la varianza y la desviación estándar, y estandarizar datos;
- simular el azar para estimar probabilidades, usar la regla de Bayes y entender la distribución normal;
- usar
logyexp, y explicar por qué el logaritmo convierte productos en sumas.
Necesitas lo del tema 3 (arreglos de NumPy) y lo del tema 4 (gráficos con matplotlib). De matemática, basta con la del colegio: qué es una función y cómo se calcula la pendiente de una recta.
Actividad: la pendiente
Antes de cualquier fórmula, juega. En el panel 1 hay una curva y un punto coral que puedes arrastrar. La línea gruesa es la tangente: la recta que «roza» la curva en ese punto y tiene su misma inclinación. La línea punteada es una secante: une tu punto con otro que está h más a la derecha. En el panel 2 hay un mapa de curvas de nivel, como el de un cerro visto desde arriba; al tocarlo aparece una flecha: el gradiente en ese lugar.
La pendiente
Esta es la posición inicial. Con JavaScript activado puedes mover el punto, cambiar h y tocar el mapa.
Con el foco en el punto de la curva, las flechas izquierda y derecha lo mueven; con Mayúsculas, el movimiento es más largo.
Con el foco en el punto del mapa, las flechas lo mueven y la tecla Intro deja fija su flecha.
1. Secante y tangente de f(x) = x³/3 − x
f(x) = −0,67pendiente de la secante = 1,33pendiente de la tangente = 3,00
Arrastra el punto coral por la curva y achica h: la secante punteada gira hasta pegarse a la tangente.
2. Curvas de nivel de g(x, y) = x² + 3y²
g = 7,00∂g/∂x = 4,00∂g/∂y = 6,00largo = 7,21
Toca el mapa en varios lugares: en cada uno queda la flecha del gradiente, achicada a la décima parte. La línea punteada va en contra: cuesta abajo.
Prueba esto, en orden:
- Con h = 1, mueve el punto por toda la curva. ¿Dónde es positiva la pendiente de la tangente, dónde negativa y dónde vale cero?
- Deja el punto quieto y achica h paso a paso. ¿Qué le pasa a la secante? ¿Y a la diferencia entre las dos pendientes?
- En el mapa, toca puntos sobre una misma curva de nivel. ¿Qué ángulo forma cada flecha con la curva?
- Toca un punto cerca del centro y otro lejos. ¿Cuál flecha es más larga? ¿Qué significa eso para el cerro?
- Toca un punto como (2; 1). ¿La flecha apunta exactamente hacia afuera, lejos del centro?
Lo que acabas de ver es el corazón del tema: la derivada es la pendiente de la tangente, y se puede aproximar con secantes cada vez más cortas. Con dos variables, el gradiente junta las pendientes en una flecha que apunta cuesta arriba. El tema 6 usa exactamente esto para que un modelo baje su error.
Funciones y pendientes
Una función es una regla que a cada número x le asigna otro número, f(x). Su gráfica es una curva. Si la función es una recta, su pendiente es fácil: cuánto sube dividido entre cuánto avanza. Una curva, en cambio, se inclina distinto en cada lugar. ¿Cómo medimos su pendiente en un punto a?
La idea es usar un segundo punto, un poco más a la derecha, en a + h. La recta que pasa por los dos es una secante, y su pendiente, que llamaremos m, es «subida sobre avance»:
Probemos con f(x) = x² en a = 1, con distancias h cada vez más chicas:
import numpy as np
import matplotlib.pyplot as plt

def f(x):
    """La función de ejemplo: f(x) = x²."""
    return x ** 2

def pendiente_secante(f, a, h):
    """Pendiente de la recta que une (a, f(a)) con (a + h, f(a + h))."""
    return (f(a + h) - f(a)) / h

for h in [1, 0.1, 0.01, 0.001]:
    print(f"h = {h:<6} pendiente de la secante = "
          f"{pendiente_secante(f, 1, h):.4f}")
h = 1 pendiente de la secante = 3.0000
h = 0.1 pendiente de la secante = 2.1000
h = 0.01 pendiente de la secante = 2.0100
h = 0.001 pendiente de la secante = 2.0010Las pendientes se acercan a 2. Ese número al que se acercan es la pendiente de la tangente en a = 1. El gráfico muestra tres secantes y la tangente:
a = 1
xs = np.linspace(-0.5, 3.2, 200)
plt.plot(xs, f(xs), color="C0", linewidth=3, label="f(x) = x²")
for h, estilo in [(2, ":"), (1, "--"), (0.5, "-.")]:
    m = pendiente_secante(f, a, h)
    plt.plot(xs, f(a) + m * (xs - a), color="C2", linestyle=estilo,
             label=f"Secante, h = {h}: pendiente {m:g}")
    plt.scatter([a + h], [f(a + h)], color="C2", zorder=3)
# La tangente: la recta por (1, 1) con pendiente 2
plt.plot(xs, f(a) + 2 * (xs - a), color="C1", linewidth=2.5,
         label="Tangente: pendiente 2")
plt.scatter([a], [f(a)], color="C0", s=60, zorder=4)
plt.ylim(-1, 15)
plt.xlabel("x")
plt.ylabel("f(x)")
plt.title("Secantes que se acercan a la tangente")
plt.legend(fontsize=9, loc="upper left")
plt.show()
La derivada
La derivada de f en a, que se escribe f′(a), es el número al que se acercan las pendientes de las secantes cuando h se hace cada vez más chico. En símbolos, es un límite:
Se lee así: la derivada es la pendiente de la tangente, o sea, qué tan rápido cambia f cuando x cambia un poquito. Para f(x) = x² la cuenta se puede hacer a mano: (a + h)² − a² = 2ah + h², y al dividir por h queda 2a + h, que se acerca a 2a. Por eso f′(x) = 2x, y en a = 1 vale 2, como vimos.
Lo que dice la derivada se lee en su signo:
- Positiva: la curva sube hacia la derecha. Si x aumenta un poquito, f aumenta.
- Negativa: la curva baja hacia la derecha.
- Cero: la curva está plana en ese punto. Pasa en el fondo de un valle (un mínimo) y en la cima de un cerro (un máximo).
Esta última línea es la que más vamos a usar: en el fondo del valle la pendiente vale cero, y si la pendiente es positiva, para bajar hay que moverse hacia la izquierda (en contra de la pendiente).
La derivada numérica
La computadora no necesita hacer el límite: le basta con un h muy chico. Hay una versión mejor que la secante «hacia adelante»: la diferencia centrada, que toma un punto a cada lado de x, en x − h y en x + h:
Comparemos las dos con x³, cuya derivada exacta es 3x² (en x = 2 vale 12):
def derivada(f, x, h=1e-6):
    """Derivada numérica de f en x, con la diferencia centrada."""
    return (f(x + h) - f(x - h)) / (2 * h)

def cubo(x):
    return x ** 3

# La derivada exacta de x³ es 3x²: en x = 2 vale 12
for h in [0.1, 0.01, 0.001]:
    adelante = pendiente_secante(cubo, 2, h)
    centrada = derivada(cubo, 2, h)
    print(f"h = {h:<5}  hacia adelante: {adelante:.6f}   "
          f"centrada: {centrada:.6f}")
print(f"Centrada con h = 0.000001: {derivada(cubo, 2):.6f}")
h = 0.1 hacia adelante: 12.610000 centrada: 12.010000
h = 0.01 hacia adelante: 12.060100 centrada: 12.000100
h = 0.001 hacia adelante: 12.006001 centrada: 12.000001
Centrada con h = 0.000001: 12.000000Con el mismo h, la diferencia centrada se equivoca muchísimo menos: con h = 0,1, la de adelante se pasa por 0,61 y la centrada solo por 0,01. Cuando h se divide por 10, el error de la de adelante también se divide por 10, pero el de la centrada se divide por 100. Por eso, desde ahora, nuestra función derivada usa la diferencia centrada con h = 0,000001. (Un h todavía más chico no siempre ayuda: la computadora guarda los números con unas 16 cifras, y restar dos números casi iguales pierde precisión.)
Ahora usemos la derivada para leer una curva. La de la actividad es f(x) = x³/3 − x:
def curva(x):
    """La curva de la actividad: x³/3 − x."""
    return x ** 3 / 3 - x

for x in [-2, -1, 0, 1, 2]:
    m = derivada(curva, x)
    if abs(m) < 1e-6:
        forma = "está plana"
    elif m > 0:
        forma = "sube"
    else:
        forma = "baja"
    print(f"x = {x:>2}: pendiente {round(m, 4):>5}  -> la curva {forma}")
x = -2: pendiente 3.0 -> la curva sube
x = -1: pendiente 0.0 -> la curva está plana
x = 0: pendiente -1.0 -> la curva baja
x = 1: pendiente 0.0 -> la curva está plana
x = 2: pendiente 3.0 -> la curva subeSube, se aplana en x = −1 (la cima de un cerrito), baja, se aplana otra vez en x = 1 (el fondo de un valle) y vuelve a subir. Eso es lo que viste al arrastrar el punto. La derivada exacta es x² − 1, que vale cero justo en −1 y en 1.
La regla de la cadena: engranajes
Muchas funciones están hechas de otras, una adentro de otra. Por ejemplo, (3x + 1)² es «elevar al cuadrado» aplicado a «3x + 1». ¿Cómo se deriva?
Piensa en dos engranajes. Cuando x da una vuelta, el engranaje de adentro, u = 3x + 1, da 3 vueltas. Y cada vuelta de u hace girar al de afuera, u², tantas vueltas como diga su derivada, 2u. En total, las velocidades se multiplican:
Aquí dy/dx es otra forma de escribir la derivada de y respecto de x. Para y = (3x + 1)²: la derivada de afuera es 2u = 2(3x + 1) y la de adentro es 3, así que la derivada es 2(3x + 1) · 3. En x = 1 da 2 · 4 · 3 = 24. Comprobémoslo:
def adentro(x):
    return 3 * x + 1

def afuera(u):
    return u ** 2

def compuesta(x):
    return afuera(adentro(x))

x0 = 1
u0 = adentro(x0)                      # u0 = 4
print("Engranaje de afuera, du² en u = 4:", round(derivada(afuera, u0), 4))
print("Engranaje de adentro, d(3x+1):    ", round(derivada(adentro, x0), 4))
print("Producto (regla de la cadena):    ",
      round(derivada(afuera, u0) * derivada(adentro, x0), 4))
print("Derivada numérica directa:        ", round(derivada(compuesta, x0), 4))
Engranaje de afuera, du² en u = 4: 8.0
Engranaje de adentro, d(3x+1): 3.0
Producto (regla de la cadena): 24.0
Derivada numérica directa: 24.0La regla de la cadena es la que, en el tema 6, te va a permitir derivar el error de un modelo («la derivada de algo al cuadrado es 2 por ese algo, por la derivada de lo de adentro»), y en las redes neuronales se aplica capa por capa.
Dos variables: derivadas parciales y gradiente
Un modelo casi nunca tiene una sola perilla. Veamos una función de dos variables:
Su gráfica es una superficie con forma de cuenco, con el fondo en (0, 0). Para dibujarla en papel se usan curvas de nivel, como en un mapa topográfico: cada curva une los puntos donde g vale lo mismo. Las curvas de g son elipses, más angostas en la dirección de y, porque ahí el cuenco es más empinado.
¿Cuál es la pendiente de una superficie? Depende de la dirección en que camines. Hay dos direcciones fáciles:
- La derivada parcial respecto de x, que se escribe ∂g/∂x, es la pendiente cuando te mueves solo en x, con y quieta. Se calcula derivando como siempre y tratando a y como un número fijo: ∂g/∂x = 2x.
- La derivada parcial respecto de y, ∂g/∂y, es la pendiente cuando te mueves solo en y, con x quieta: ∂g/∂y = 6y.
El gradiente junta las dos en un vector (una flecha), y se escribe con el símbolo ∇ («nabla»):
Numéricamente, cada derivada parcial es una derivada centrada en la que solo se mueve una variable:
def g(x, y):
    """Un cuenco alargado: g(x, y) = x² + 3y²."""
    return x ** 2 + 3 * y ** 2

def gradiente_numerico(f, x, y, h=1e-6):
    """Las dos derivadas parciales de f en (x, y), juntas en un vector."""
    df_dx = (f(x + h, y) - f(x - h, y)) / (2 * h)
    df_dy = (f(x, y + h) - f(x, y - h)) / (2 * h)
    return np.array([df_dx, df_dy])

print("Gradiente numérico en (2, 1):",
      np.round(gradiente_numerico(g, 2, 1), 4))
print("Gradiente exacto (2x, 6y):   ", np.array([2 * 2, 6 * 1]))
Gradiente numérico en (2, 1): [4. 6.]
Gradiente exacto (2x, 6y): [4 6]El gradiente apunta cuesta arriba
El gradiente tiene una propiedad que lo hace famoso: apunta en la dirección en que la función sube más rápido, y su largo dice qué tan empinada es esa subida. No hace falta creerlo: probemos las 360 direcciones posibles (una por grado) desde el punto (2, 1), con pasos todos del mismo largo, y veamos cuál sube más.
punto = np.array([2.0, 1.0])
grad = gradiente_numerico(g, *punto)
paso = 1e-4                           # un paso muy corto
angulos = np.arange(360)              # una dirección por grado
rad = np.deg2rad(angulos)
direcciones = np.column_stack([np.cos(rad), np.sin(rad)])
subidas = [g(*(punto + paso * d)) - g(*punto) for d in direcciones]

print("Dirección en que g sube más:", angulos[np.argmax(subidas)],
      "grados")
angulo_grad = np.degrees(np.arctan2(grad[1], grad[0]))
print(f"Dirección del gradiente:     {angulo_grad:.1f} grados")
print(f"Mayor subida dividida por el paso: {max(subidas) / paso:.3f}")
print(f"Largo del gradiente:               {np.linalg.norm(grad):.3f}")
Dirección en que g sube más: 56 grados
Dirección del gradiente: 56.3 grados
Mayor subida dividida por el paso: 7.211
Largo del gradiente: 7.211La mejor dirección entre las 360 es la del gradiente (redondeada al grado), y la subida por unidad de paso coincide con el largo del gradiente. En la dirección contraria al gradiente, la función baja lo más rápido posible. Ese es todo el truco del descenso de gradiente del tema 6: calcular el gradiente del error y dar un paso en contra.
El gráfico dibuja las curvas de nivel de g y el gradiente en una cuadrícula de puntos. Las flechas están achicadas a la décima parte para que quepan.
xs = np.linspace(-3.5, 3.5, 200)
ys = np.linspace(-2.2, 2.2, 200)
XX, YY = np.meshgrid(xs, ys)
plt.contour(XX, YY, g(XX, YY), levels=[1, 3, 7, 12, 19], colors="C2")

# Flechas del gradiente en una cuadrícula de puntos
xq, yq = np.meshgrid(np.arange(-2.5, 3, 1), [-1.2, 0, 1.2])
gx, gy = gradiente_numerico(g, xq, yq)
plt.quiver(xq, yq, gx, gy, color="C0", angles="xy",
           scale_units="xy", scale=10, width=0.007)
# El gradiente en (2, 1), sobre la curva de nivel g = 7
plt.quiver([2], [1], [grad[0]], [grad[1]], color="C1", angles="xy",
           scale_units="xy", scale=10, width=0.009)
plt.scatter([0], [0], marker="+", s=120, color="C0")
plt.gca().set_aspect("equal")
plt.xlabel("x")
plt.ylabel("y")
plt.title("Curvas de nivel de g y su gradiente")
plt.show()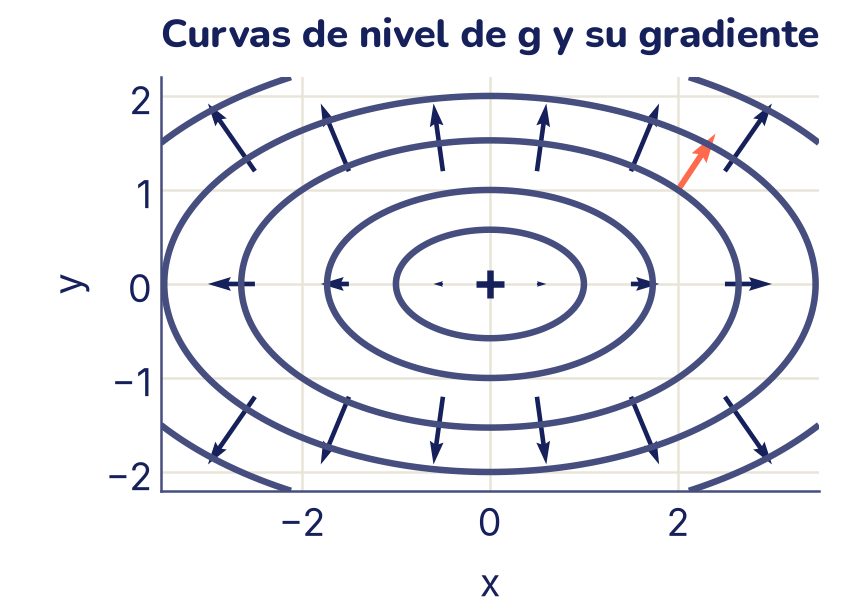
Fíjate en tres cosas, las mismas de la actividad:
- Cada flecha cruza su curva de nivel en ángulo recto. Caminar a lo largo de una curva de nivel no cambia g; el gradiente apunta hacia donde cambia más.
- Las flechas son más largas lejos del fondo, donde el cuenco es más empinado, y casi nulas cerca de (0, 0). En el mínimo, el gradiente es cero.
- Como el cuenco es alargado, las flechas no apuntan justo hacia afuera desde el centro: se inclinan hacia la dirección más empinada, la de y. Bajar en contra del gradiente no lleva en línea recta al fondo. Eso explica el camino en zigzag que verás en el tema 6.
Promedios: media, varianza y desviación estándar
Cambiemos de tema: de pendientes a datos. Dos estudiantes, Sofía y Mateo, anotaron cuántos minutos tardaron en llegar al colegio durante cinco días:
# Minutos de viaje al colegio durante cinco días
sofia = np.array([20, 22, 19, 21, 18])
mateo = np.array([10, 35, 15, 30, 10])
print("Sofía:", sofia.mean(), "minutos en promedio")
print("Mateo:", mateo.mean(), "minutos en promedio")
Sofía: 20.0 minutos en promedio
Mateo: 20.0 minutos en promedioLos dos tardan, en promedio, 20 minutos. Pero no es lo mismo: Sofía llega casi siempre a la misma hora y Mateo a veces vuela y a veces se atrasa mucho. La media (el promedio) dice dónde está el centro de los datos; necesitamos otro número que diga qué tan dispersos están alrededor de ese centro.
La varianza es el promedio de las distancias a la media, elevadas al cuadrado (para que las de abajo no cancelen a las de arriba). Como queda en «minutos al cuadrado», se usa su raíz, la desviación estándar, que vuelve a estar en minutos. Con n datos x1, …, xn:
x̄ se lee «x barra» y σ es la letra griega sigma. Programado tal cual:
for nombre, t in [("Sofía", sofia), ("Mateo", mateo)]:
    media = t.mean()
    varianza = np.mean((t - media) ** 2)
    desviacion = np.sqrt(varianza)
    print(f"{nombre}: media {media:.1f}   varianza {varianza:.1f}   "
          f"desviación {desviacion:.2f}")

print("Con NumPy:", np.var(mateo), round(np.std(mateo), 2))
Sofía: media 20.0 varianza 2.0 desviación 1.41
Mateo: media 20.0 varianza 110.0 desviación 10.49
Con NumPy: 110.0 10.49Sofía se aleja de su media unos 1,4 minutos «típicos»; Mateo, unos 10,5. np.var y np.std dan lo mismo que nuestra fórmula.
Un detalle que confunde a todo el mundo: algunas herramientas dividen por n − 1 en lugar de n (por razones que verás en estadística). NumPy divide por n, como nosotros; pandas divide por n − 1. Para que pandas haga lo mismo que NumPy, escribe .std(ddof=0).
El puntaje z y la estandarización
¿Qué es más raro: que Sofía tarde 23 minutos o que Mateo tarde 40? Mateo se pasa más de su media (20 minutos contra 3), pero él varía mucho más. Para comparar hay que medir la distancia a la media en desviaciones estándar. Eso es el puntaje z:
z_sofia = (23 - sofia.mean()) / sofia.std()
z_mateo = (40 - mateo.mean()) / mateo.std()
print(f"23 minutos para Sofía: z = {z_sofia:.2f}")
print(f"40 minutos para Mateo: z = {z_mateo:.2f}")
23 minutos para Sofía: z = 2.12
40 minutos para Mateo: z = 1.91Sofía tardando 23 minutos está a 2,12 desviaciones de lo normal para ella; Mateo tardando 40, a 1,91. Lo de Sofía es más raro, aunque sean menos minutos.
Estandarizar una columna de datos es reemplazar cada valor por su puntaje z. La columna nueva siempre queda con media 0 y desviación estándar 1, sin importar en qué unidades estaba:
z = (mateo - mateo.mean()) / mateo.std()
print("Mateo estandarizado:", np.round(z, 2))
print(f"Media: {abs(z.mean()):.2f}   desviación: {z.std():.2f}")
Mateo estandarizado: [-0.95 1.43 -0.48 0.95 -0.95]
Media: 0.00 desviación: 1.00¿Para qué sirve? Para poner en la misma escala datos que vienen en unidades muy distintas. En una tabla con la estatura en centímetros y el peso en kilos, un modelo no debería tratar a una columna como más importante solo porque sus números son más grandes. En el tema 6 vas a ver que, además, estandarizar hace que el descenso de gradiente llegue mucho más rápido.
Una tabla entera: vectores y matrices
En el tema 3 viste que una tabla de números es una matriz: cada fila, un ejemplo; cada columna, una característica. Y que cada fila (o columna) es un vector. El gradiente que calculamos arriba también es un vector. Con axis=0, NumPy saca la media y la desviación de cada columna, y la resta y la división se aplican columna por columna. Así se estandariza una tabla entera en una línea:
# Cuatro estudiantes: estatura (cm) y peso (kg)
tabla = np.array([[150, 45], [160, 52], [170, 61], [180, 70]],
                 dtype=float)
tabla_est = (tabla - tabla.mean(axis=0)) / tabla.std(axis=0)

print("Medias por columna:", tabla.mean(axis=0))
print("Desviaciones:", np.round(tabla.std(axis=0), 2))
print(np.round(tabla_est, 2))
Medias por columna: [165. 57.]
Desviaciones: [11.18 9.41]
[[-1.34 -1.28]
[-0.45 -0.53]
[ 0.45 0.43]
[ 1.34 1.38]]Ahora las dos columnas hablan el mismo idioma: un 1 significa «una desviación estándar por encima del promedio», sea en estatura o en peso.
Azar: probabilidad como frecuencia
¿Qué quiere decir que la probabilidad de sacar un 6 con un dado es 1/6? Una forma muy práctica de entenderlo: si tiras el dado muchísimas veces, la fracción de tiros que salen 6 se acerca a 1/6. A esa fracción se le llama frecuencia relativa.
Con la computadora podemos tirar un dado cien mil veces en un instante. rng.integers(1, 7) da enteros del 1 al 6 (el 7 no entra), todos igual de probables:
rng = np.random.default_rng(7)
tiros = rng.integers(1, 7, size=100_000)
print("Primeros diez tiros:", tiros[:10])

for n in [10, 100, 1_000, 10_000, 100_000]:
    fraccion = np.mean(tiros[:n] == 6)
    print(f"{n:>7} tiros: fracción de seises = {fraccion:.4f}")
print(f"Probabilidad: 1/6 = {1 / 6:.4f}")
Primeros diez tiros: [6 4 5 6 4 5 6 2 1 2]
10 tiros: fracción de seises = 0.3000
100 tiros: fracción de seises = 0.2000
1000 tiros: fracción de seises = 0.1800
10000 tiros: fracción de seises = 0.1690
100000 tiros: fracción de seises = 0.1682
Probabilidad: 1/6 = 0.1667Con pocos tiros la fracción salta mucho; con muchos se queda pegada a 1/6. Eso se llama ley de los grandes números: el promedio de muchos experimentos al azar se acerca a la probabilidad. Lo vemos mejor siguiendo la fracción tiro a tiro:
n_tiros = np.arange(1, len(tiros) + 1)
# Fracción de seises acumulada después de cada tiro
frecuencia = np.cumsum(tiros == 6) / n_tiros
plt.plot(n_tiros, frecuencia, color="C0", label="Fracción de seises")
plt.axhline(1 / 6, color="C2", linestyle="--", label="1/6")
plt.xscale("log")
plt.ylim(0, 0.5)
plt.xlabel("Cantidad de tiros (escala logarítmica)")
plt.ylabel("Fracción de seises")
plt.title("La frecuencia se acerca a 1/6")
plt.legend()
plt.show()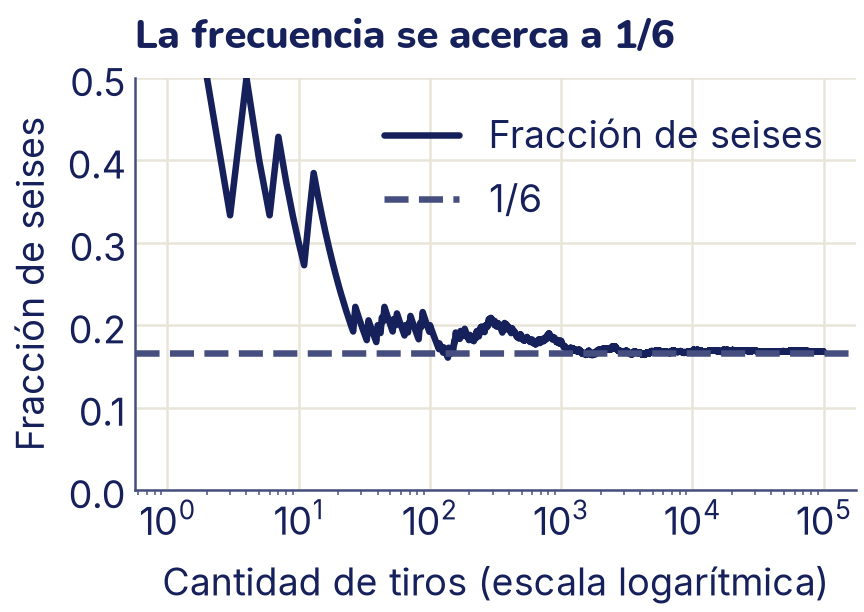
La escala logarítmica del eje horizontal pone 1, 10, 100, 1000… a la misma distancia, para que se vean a la vez los primeros tiros y los últimos. (Vas a entender por qué al final del tema.)
Probabilidad condicional y la regla de Bayes
A veces la probabilidad cambia cuando sabemos algo más. La probabilidad condicional P(A | B) se lee «la probabilidad de A sabiendo que pasó B». Por ejemplo, la probabilidad de que llueva es una; la probabilidad de que llueva sabiendo que el cielo está cubierto de nubes negras es otra, mucho mayor.
Un ejemplo médico muestra por qué importa. Una enfermedad la tiene 1 de cada 100 personas. Hay una prueba para detectarla:
- si la persona tiene la enfermedad, la prueba sale positiva el 90 % de las veces;
- si no la tiene, igual sale positiva (por error) el 5 % de las veces.
A una persona tomada al azar le sale positivo. ¿Qué probabilidad hay de que tenga la enfermedad? Mucha gente responde «90 %». Pensemos en 10 000 personas:
- 100 tienen la enfermedad, y a 90 de ellas les sale positivo;
- 9900 no la tienen, y a 5 % de ellas, 495, también les sale positivo.
En total hay 90 + 495 = 585 positivos, y solo 90 están enfermos: 90/585 ≈ 15,4 %. La prueba no es mala; lo que pasa es que hay tantas personas sanas que sus pocos errores suman más que los enfermos de verdad. Eso es la regla de Bayes:
Con A = «está enferma» y B = «sale positivo»: P(B | A) = 0,9 y P(A) = 0,01, así que el numerador es 0,009. P(B), la probabilidad de salir positivo, suma los dos caminos: 0,9 · 0,01 + 0,05 · 0,99 = 0,0585. Y 0,009/0,0585 ≈ 0,154. Ahora comprobémoslo simulando un millón de personas:
N = 1_000_000                         # personas simuladas
p_enfermedad = 0.01                   # 1 de cada 100
sensibilidad = 0.90                   # P(positivo | enferma)
falso_positivo = 0.05                 # P(positivo | sana)

rng = np.random.default_rng(1)
enferma = rng.random(N) < p_enfermedad
azar = rng.random(N)
# A cada persona le sale positivo con la probabilidad que le toca
positivo = np.where(enferma, azar < sensibilidad, azar < falso_positivo)

print("Personas con resultado positivo:", positivo.sum())
print(f"P(enferma | positivo) simulada: {enferma[positivo].mean():.4f}")
p_positivo = (sensibilidad * p_enfermedad
              + falso_positivo * (1 - p_enfermedad))
print(f"P(enferma | positivo) con Bayes: "
      f"{sensibilidad * p_enfermedad / p_positivo:.4f}")
Personas con resultado positivo: 58896
P(enferma | positivo) simulada: 0.1534
P(enferma | positivo) con Bayes: 0.1538La simulación y la fórmula difieren en menos de una milésima. enferma[positivo] se queda solo con las personas a las que les salió positivo, y su media es la fracción de enfermas entre ellas: eso es la probabilidad condicional, contada. Muchos modelos de clasificación hacen este mismo razonamiento: partir de lo común que es cada clase y actualizarlo con la evidencia.
Distribuciones: uniforme, Bernoulli y normal
Una distribución dice qué valores puede tomar algo al azar y con qué probabilidad. Ya usaste tres:
- Uniforme: todos los valores igual de probables. El dado (1 a 6, cada uno con 1/6) y
rng.random(), que da cualquier número entre 0 y 1 sin preferir ninguno. - Bernoulli: un experimento con dos resultados, «sí» (1) con probabilidad p y «no» (0) con probabilidad 1 − p. Una moneda es Bernoulli con p = 0,5; «¿le sale positivo?» también es una Bernoulli. En código,
rng.random() < p. - Normal: la famosa campana. Aparece cuando algo es la suma de muchos efectos chicos al azar: las estaturas, los errores de medición, las notas de un curso grande.
La normal tiene dos parámetros: su media μ (mu), donde está el centro, y su desviación estándar σ, el ancho. Su fórmula no hace falta memorizarla; usa la exponencial, exp, que verás en la sección siguiente:
Lo que sí conviene recordar es la regla 68–95–99,7: en una normal, más o menos el 68 % de los datos queda a menos de una desviación estándar de la media, el 95 % a menos de dos y el 99,7 % a menos de tres. Probémoslo con estaturas simuladas de media 165 cm y desviación 7 cm:
rng = np.random.default_rng(5)
estaturas = rng.normal(165, 7, size=100_000)
print(f"Media: {estaturas.mean():.2f}   "
      f"desviación: {estaturas.std():.2f}")

z = (estaturas - estaturas.mean()) / estaturas.std()
for k in [1, 2, 3]:
    print(f"Fracción con |z| menor que {k}: {np.mean(np.abs(z) < k):.3f}")
Media: 165.01 desviación: 6.99
Fracción con |z| menor que 1: 0.682
Fracción con |z| menor que 2: 0.955
Fracción con |z| menor que 3: 0.997Por qué aparece tanto la campana
Tira un dado: cada número sale con la misma probabilidad, sin ninguna campana. Pero si tiras dos dados y sumas, el 7 sale mucho más que el 2 o el 12 (hay más formas de sumar 7). Con más dados, las sumas forman una campana cada vez más perfecta. Este resultado, el teorema central del límite, explica por qué la normal está en todas partes: lo que se forma sumando muchas partes al azar termina pareciéndose a una campana.
def densidad_normal(x, mu, sigma):
    """La fórmula de la campana."""
    return (np.exp(-(x - mu) ** 2 / (2 * sigma ** 2))
            / (sigma * np.sqrt(2 * np.pi)))

rng = np.random.default_rng(3)
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
for eje, k in zip(ejes.flat, [1, 2, 5, 20]):
    # 100 000 tiradas de k dados, sumando cada tirada
    sumas = rng.integers(1, 7, size=(100_000, k)).sum(axis=1)
    valores, cuentas = np.unique(sumas, return_counts=True)
    eje.bar(valores, cuentas / len(sumas), width=0.8, color="C0")
    eje.set_title("1 dado" if k == 1 else f"Suma de {k} dados")
    eje.set_xticks([k, 6 * k])          # la menor y la mayor suma
    eje.set_yticks([])

# Un dado tiene media 3,5 y varianza 35/12; con k dados, k veces eso
xs = np.linspace(20, 120, 300)
eje.plot(xs, densidad_normal(xs, 3.5 * k, np.sqrt(35 / 12 * k)),
         color="C1", linewidth=2)
fig.suptitle("Sumar dados forma una campana")
plt.show()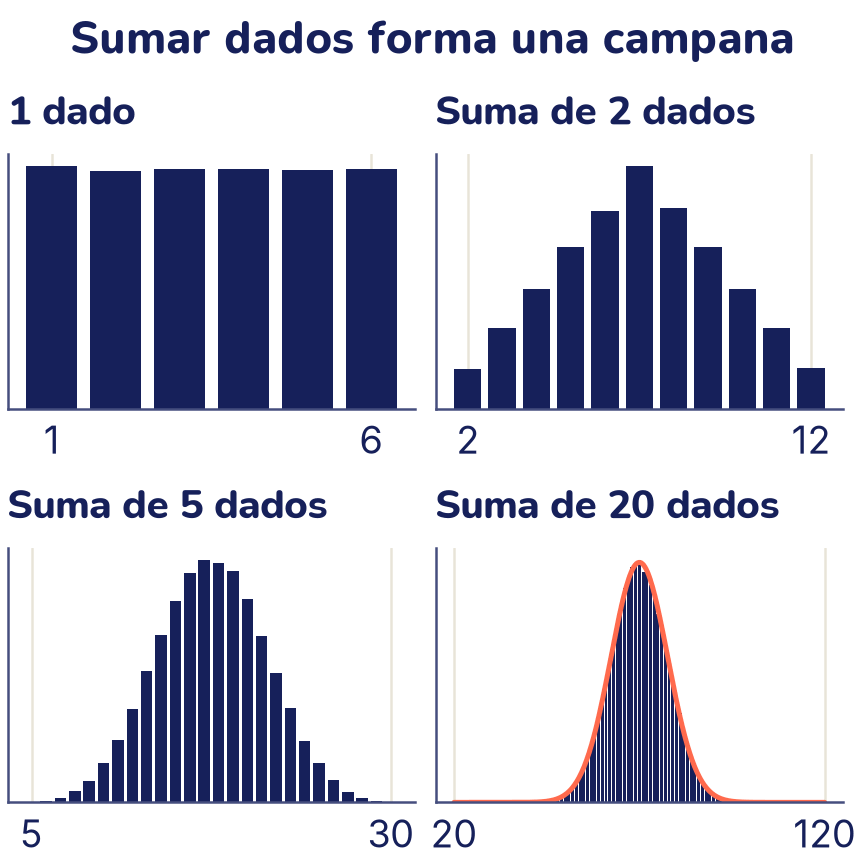
La curva del último panel no se ajustó a los datos: es la normal con la media y la desviación que la teoría predice para la suma de 20 dados (media 20 · 3,5 = 70, varianza 20 · 35/12). Y aun así coincide con las barras. Ojo: la campana aparece al sumar muchos efectos independientes. No todo en el mundo es normal: los ingresos de las personas, por ejemplo, tienen una cola larga hacia la derecha.
Logaritmo y exponencial
La exponencial exp(x) = ex es la potencia de un número especial, e ≈ 2,718. Crece muy rápido y siempre es positiva. El logaritmo (natural), log(x), es su operación inversa: responde «¿a qué potencia hay que elevar e para obtener x?». Por eso log(exp(x)) = x, y log solo acepta números positivos. En NumPy son np.exp y np.log.
print("e =", np.e)
print("exp(1) =", np.exp(1), "  log(e) =", np.log(np.e))
print("log(exp(5)) =", np.log(np.exp(5)))
print("exp(10) =", round(np.exp(10), 1), "  log(10) =",
      round(np.log(10), 4))
e = 2.718281828459045
exp(1) = 2.718281828459045 log(e) = 1.0
log(exp(5)) = 5.0
exp(10) = 22026.5 log(10) = 2.3026xs = np.linspace(-3, 3, 200)
plt.plot(xs, np.exp(xs), color="C0", label="exp(x)")
xs_pos = np.linspace(0.02, 9, 300) # log solo acepta positivos
plt.plot(xs_pos, np.log(xs_pos), color="C0", linestyle="--",
label="log(x)")
plt.plot([-3, 9], [-3, 9], color="C2", linestyle=":",
label="y = x")
plt.xlim(-3, 9)
plt.ylim(-3, 9)
plt.gca().set_aspect("equal")
plt.xlabel("x")
plt.title("exp y log son inversas")
plt.legend(loc="center left", bbox_to_anchor=(1, 0.5))
plt.show()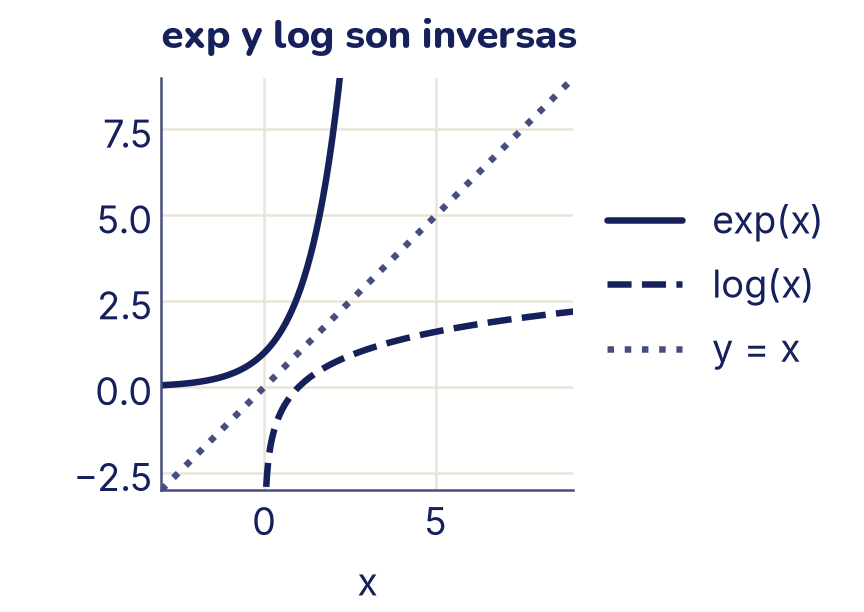
Cada curva es el reflejo de la otra en la recta y = x, como pasa con toda función y su inversa.
El logaritmo convierte productos en sumas
La propiedad más útil del logaritmo es esta:
¿Por qué? Porque al multiplicar potencias de la misma base, los exponentes se suman: eu · ev = eu + v. Si a = eu y b = ev, entonces log(a) = u, log(b) = v y a · b = eu + v, así que log(a · b) = u + v. El logaritmo «baja» los exponentes, y lo que era multiplicar pasa a ser sumar.
print("log(6 · 8)      =", round(np.log(6 * 8), 6))
print("log(6) + log(8) =", round(np.log(6) + np.log(8), 6))

# La probabilidad de 1000 sucesos independientes, cada uno de 1 %
probabilidades = np.full(1000, 0.01)
print("Producto directo:", np.prod(probabilidades))
print("Suma de logaritmos:", round(np.sum(np.log(probabilidades)), 2))
log(6 · 8) = 3.871201
log(6) + log(8) = 3.871201
Producto directo: 0.0
Suma de logaritmos: -4605.17El producto da 0, y está mal: el número verdadero es 10−2000, que es positivo pero demasiado chico para que la computadora lo guarde, así que lo redondea a cero. La suma de logaritmos, −4605,17, no tiene ese problema. Por eso, cuando un modelo multiplica muchas probabilidades (lo vas a ver en la regresión logística y en los modelos de lenguaje), en la práctica suma sus logaritmos. Además, sumar es más fácil de derivar que multiplicar.
Un último dato que conecta todo el tema: la exponencial es su propia derivada. Su pendiente en cada punto es igual a su altura:
for x in [0, 1, 2]:
    print(f"x = {x}: exp(x) = {np.exp(x):.4f}   "
          f"pendiente = {derivada(np.exp, x):.4f}")
x = 0: exp(x) = 1.0000 pendiente = 1.0000
x = 1: exp(x) = 2.7183 pendiente = 2.7183
x = 2: exp(x) = 7.3891 pendiente = 7.3891Lo que aprendiste y lo que sigue
- La derivada es la pendiente de la tangente: el límite de las pendientes de las secantes cuando h se achica. Con código se aproxima con la diferencia centrada. Su signo dice si la curva sube o baja, y vale cero en los mínimos y máximos.
- La regla de la cadena multiplica las derivadas de funciones encadenadas, como engranajes.
- Con dos variables, las derivadas parciales forman el gradiente, una flecha que apunta cuesta arriba, perpendicular a las curvas de nivel. En contra del gradiente, la función baja lo más rápido posible.
- La media dice dónde está el centro de los datos y la desviación estándar, qué tan dispersos están. Estandarizar (restar la media y dividir por la desviación) deja cualquier columna con media 0 y desviación 1.
- La probabilidad se puede estimar simulando y contando frecuencias. La regla de Bayes actualiza una probabilidad con la evidencia, y puede dar resultados muy distintos de la intuición.
- La normal aparece al sumar muchos efectos al azar. El logaritmo convierte productos en sumas y evita que los productos de muchas probabilidades se vuelvan cero.
En el tema 6 todo esto se junta: el error de un modelo es una función de sus parámetros, su gradiente apunta cuesta arriba y el modelo aprende dando pasos en contra. Las características se estandarizan antes de empezar, para que el camino sea corto.