La pregunta
Una foto de celular tiene unos 12 millones de píxeles, y cada píxel son tres números: cuánto rojo, cuánto verde y cuánto azul. Si quieres aclarar la foto, tienes que sumarle algo a 36 millones de números. Con lo que aprendiste en el tema 2, escribirías un bucle que recorre los números uno por uno. ¿Cuánto tardaría? ¿Y si son mil fotos?
Los modelos de inteligencia artificial hacen esto todo el tiempo: una red neuronal recibe lotes de imágenes, textos convertidos en números o tablas con miles de filas, y los transforma con sumas y multiplicaciones. Nadie escribe esos bucles a mano. Se usa NumPy, una librería de Python que guarda muchos números juntos en un arreglo y opera con todos a la vez, mucho más rápido. Casi todas las herramientas de IA que vas a usar en la ruta (pandas, scikit-learn, PyTorch) están construidas sobre esta misma idea.
En este tema vas a:
- crear arreglos de una a cuatro dimensiones, y leer su forma (
shape) y su tipo (dtype); - sacar partes de un arreglo con índices, rebanadas y condiciones;
- sumar y promediar por ejes, y predecir la forma del resultado;
- entender el broadcasting, la regla con la que NumPy opera con arreglos de formas distintas;
- usar el producto punto para medir qué tan parecidos son dos vectores, y multiplicar matrices;
- tratar una foto como un arreglo: recortarla, voltearla y pasarla a gris;
- cambiar un bucle por una operación vectorizada y medir cuánto se acelera.
Necesitas lo del tema 2: listas, bucles for, funciones e import.
Actividad: estirar formas
Antes de escribir código, juega con la regla más importante del tema. Cuando sumas dos arreglos de formas distintas, NumPy intenta estirar el más chico copiándolo, hasta que los dos tengan la misma forma. A eso se le llama broadcasting. Una forma se escribe entre paréntesis: (3, 1) es una tabla de 3 filas y 1 columna; (4,) es una fila suelta de 4 números.
En el primer panel eliges la forma de A y la de B y ves cómo se estiran hasta la forma de A + B. Las celdas con borde continuo son los números que de verdad existen; las de borde punteado son copias. El segundo panel es una tabla de 3 × 4 que puedes sumar «por el eje 0» o «por el eje 1».
Broadcasting
Este es el estado inicial. Con JavaScript activado puedes elegir las formas y sumar por cada eje.
1. Estirar dos formas hasta que encajen
un número que existe una copia hecha al estirar
| penúltima | última | |
|---|---|---|
| A | 3 | 1 |
| B | 1 | 4 |
| A + B | 3 | 4 |
Un 1 en gris es una dimensión que NumPy agrega a la izquierda de la forma más corta. Cada columna tiene que tener dos números iguales o un 1.
A (3, 1) y B (1, 4) son compatibles. A se copia 4 veces hacia la derecha; B se copia 3 veces hacia abajo. El resultado tiene forma (3, 4).
2. Sumar a lo largo de un eje
M.sum(axis=0) da [6 9 9 13], forma (4,)
M.sum(axis=1) da [12 11 14], forma (3,)
Eje 0: se suma hacia abajo. Las 3 filas desaparecen y queda un número por columna: de (3, 4) a (4,).
Prueba esto, en orden:
- Empieza con A =
(3, 1)y B =(1, 4). ¿Cuántas veces se copia la columna de A? ¿Y la fila de B? ¿Qué forma tiene el resultado? - Cambia B a
(4,). ¿Cambia el resultado? Mira la tabla de formas: ¿qué número aparece en gris al lado izquierdo de B? - Pon A =
(3, 4)y B =(3,). ¿Qué dimensión choca? Busca un B que sí funcione con ese A. - Prueba A =
(3,)y B =(3, 1). ¿Te sorprende la forma del resultado? - En el segundo panel, suma por el eje 0 y después por el eje 1. ¿Qué forma tiene cada resultado? ¿Qué dimensión de la tabla desaparece en cada caso?
Si en el paso 3 encontraste que (3, 4) funciona con (4,) o con (3, 1), pero no con (3,), ya descubriste la regla. Al final de la sección de broadcasting está escrita con todas sus letras.
De la lista al arreglo
Un arreglo de NumPy se parece a una lista, pero se comporta distinto. Compara:
import numpy as np

lista = [1, 2, 3, 4]
arreglo = np.array([1, 2, 3, 4])

print(lista * 2)     # la lista repetida dos veces
print(arreglo * 2)   # cada número multiplicado por 2
print(arreglo + 10)
print(arreglo ** 2)
[1, 2, 3, 4, 1, 2, 3, 4]
[2 4 6 8]
[11 12 13 14]
[ 1 4 9 16]Con una lista, * 2 repite la lista. Con un arreglo, la operación se aplica a cada número: se dice que es una operación elemento a elemento o vectorizada. No hace falta escribir ningún bucle.
La costumbre es importar NumPy con el nombre corto np. Para el resto del tema vamos a usar las notas de un curso, como las del analizador del tema 2, pero ahora guardadas en un arreglo de dos dimensiones: una fila por estudiante y una columna por materia.
materias = ["Matemática", "Física", "Lenguaje", "Biología"]
# Notas sobre 100: una fila por estudiante, una columna por materia
notas = np.array([
    [72, 65, 80, 58],
    [45, 50, 62, 70],
    [88, 92, 75, 81],
    [60, 48, 55, 66],
    [95, 85, 90, 88],
    [38, 52, 47, 61],
])

print("shape:", notas.shape)   # (filas, columnas)
print("ndim: ", notas.ndim)    # cuántas dimensiones tiene
print("size: ", notas.size)    # cuántos números hay en total
print("dtype:", notas.dtype)   # de qué tipo es cada número
print("En décimos:", (notas / 10).dtype)
shape: (6, 4)
ndim: 2
size: 24
dtype: int64
En décimos: float64Estas cuatro propiedades describen cualquier arreglo:
shape(forma): cuántos elementos hay en cada dimensión.(6, 4)son 6 filas y 4 columnas. Es lo más importante que tienes que saber de un arreglo, y lo que más vas a mirar cuando algo falle.ndim: cuántas dimensiones tiene. Un arreglo de una dimensión se llama vector; de dos, matriz; de tres o más, tensor.size: cuántos números hay en total, el producto de la forma (6 × 4 = 24).dtype: el tipo de todos los números. A diferencia de una lista, un arreglo no mezcla tipos.int64son enteros yfloat64, números con decimales; al dividir, NumPy pasa afloat64. Más adelante vas a veruint8, los enteros de 0 a 255 de las imágenes.
Otras formas de crear arreglos
No siempre se escriben los números a mano. Estas funciones crean arreglos de la forma que les pidas:
print(np.zeros((2, 3)))          # una tabla de ceros de 2 × 3
print(np.ones(4))                # cuatro unos
print(np.arange(0, 10, 2))       # como range, pero da un arreglo
print(np.linspace(0, 1, 5))      # 5 números parejos de 0 a 1

# Números al azar, con semilla fija para que salgan siempre iguales
rng = np.random.default_rng(42)
print(rng.integers(1, 7, size=10))          # diez dados
print(rng.normal(0, 1, size=(2, 3)).round(2))
[[0. 0. 0.]
[0. 0. 0.]]
[1. 1. 1. 1.]
[0 2 4 6 8]
[0. 0.25 0.5 0.75 1. ]
[1 5 4 3 3 6 1 5 2 1]
[[-1.3 0.13 -0.32]
[-0.02 -0.85 0.88]]np.random.default_rng(42) crea un generador de números aleatorios con la semilla 42. Con la misma semilla, los números «al azar» salen siempre iguales: así cualquiera puede repetir tus resultados. Lo vas a usar en todos los temas de la ruta.
Indexar, rebanar y filtrar
Para leer partes de un arreglo se usan corchetes, como con las listas. En una matriz van dos índices separados por coma: primero la fila y después la columna. Se empieza a contar desde 0.
print(notas[0])          # la fila 0: el primer estudiante
print(notas[0, 2])       # fila 0, columna 2: su nota de Lenguaje
print(notas[-1])         # la última fila
print(notas[:, 0])       # todas las filas, columna 0: Matemática
print(notas[1:3, :2])    # filas 1 y 2, columnas 0 y 1
print(notas[::2, -1])    # una fila sí y otra no, última columna
[72 65 80 58]
80
[38 52 47 61]
[72 45 88 60 95 38]
[[45 50]
[88 92]]
[58 81 88]Una rebanada inicio:fin:paso funciona como en las listas: incluye el inicio, no incluye el fin, y si omites algo se usa el valor de siempre (desde el principio, hasta el final, de uno en uno). Un : solo significa «todo en esta dimensión». Fíjate en las formas: notas[0] es un vector de 4 números, y notas[1:3, :2] es una matriz de 2 × 2.
Una advertencia: una rebanada no es una copia, es una ventana al mismo arreglo. Si cambias un número de la rebanada, cambia también en notas. Si quieres una copia independiente, usa .copy(), por ejemplo primera = notas[0].copy().
Filtrar con condiciones
Una comparación con un arreglo da un arreglo de True y False, del mismo tamaño. Ese arreglo sirve como índice: se queda solo con los números donde hay True. A esto se le llama indexación booleana. Supongamos que en este curso se aprueba con 51 o más.
aprobado = notas >= 51
print(aprobado[:2])                  # las dos primeras filas
print("Notas reprobadas:", notas[notas < 51])
print("Cuántas notas aprobadas:", aprobado.sum())
# Las notas de Matemática de quienes aprobaron Física
print(notas[notas[:, 1] >= 51, 0])
[[ True True True True]
[False False True True]]
Notas reprobadas: [45 50 48 38 47]
Cuántas notas aprobadas: 19
[72 88 95 38]True cuenta como 1 y False como 0, por eso aprobado.sum() cuenta los True. En el tema 2, cada una de estas líneas era un bucle con un if adentro.
Los ejes
Cada dimensión de un arreglo es un eje, numerado desde 0. En una matriz, el eje 0 recorre las filas (va hacia abajo) y el eje 1 recorre las columnas (va hacia la derecha). Muchas funciones, como sum, mean, max o argmax, aceptan axis= para operar a lo largo de un eje.
M = np.array([[2, 5, 1, 4],
              [3, 0, 6, 2],
              [1, 4, 2, 7]])

print("Sin eje:  ", M.sum())
print("axis=0:   ", M.sum(axis=0), "forma", M.sum(axis=0).shape)
print("axis=1:   ", M.sum(axis=1), "forma", M.sum(axis=1).shape)
Sin eje: 37
axis=0: [ 6 9 9 13] forma (4,)
axis=1: [12 11 14] forma (3,)La forma de M es (3, 4). Con axis=0 se suma hacia abajo: el eje 0 desaparece y queda un número por columna, forma (4,). Con axis=1 se suma hacia la derecha: desaparece el eje 1 y queda un número por fila, forma (3,). La regla para predecir la forma es tachar el eje que pides. Este código dibuja el esquema:
import matplotlib.pyplot as plt

filas, columnas = M.shape
fig, ax = plt.subplots()
for i in range(filas):
    for j in range(columnas):
        # La fila i se dibuja más abajo cuanto mayor es i
        ax.add_patch(plt.Rectangle((j, -i), 1, 1, fill=False,
                                   edgecolor="C0", linewidth=1.5))
        ax.text(j + 0.5, -i + 0.5, M[i, j], ha="center", va="center")
for j, s in enumerate(M.sum(axis=0)):
    ax.text(j + 0.5, -filas + 0.1, s, ha="center", va="center",
            color="C2")
for i, s in enumerate(M.sum(axis=1)):
    ax.text(columnas + 0.6, -i + 0.5, s, ha="center", va="center",
            color="C2")
# Las flechas de los ejes
flecha = dict(arrowstyle="-|>", color="C0", linewidth=2)
ax.annotate("", xy=(-0.4, -filas + 1), xytext=(-0.4, 1),
            arrowprops=flecha)
ax.annotate("", xy=(columnas, 1.4), xytext=(0, 1.4), arrowprops=flecha)
ax.text(-0.7, -0.5, "eje 0", rotation=90, ha="center", va="center")
ax.text(columnas / 2, 1.75, "eje 1", ha="center")
ax.text(columnas / 2, -filas - 0.5, "sum(axis=0): forma (4,)",
        ha="center", color="C2")
ax.text(columnas + 1.2, -filas / 2 + 1, "sum(axis=1): forma (3,)",
        rotation=-90, ha="center", va="center", color="C2")
ax.set_xlim(-1, columnas + 1.5)
ax.set_ylim(-filas - 0.9, 2.1)
ax.set_aspect("equal")
ax.axis("off")
plt.show()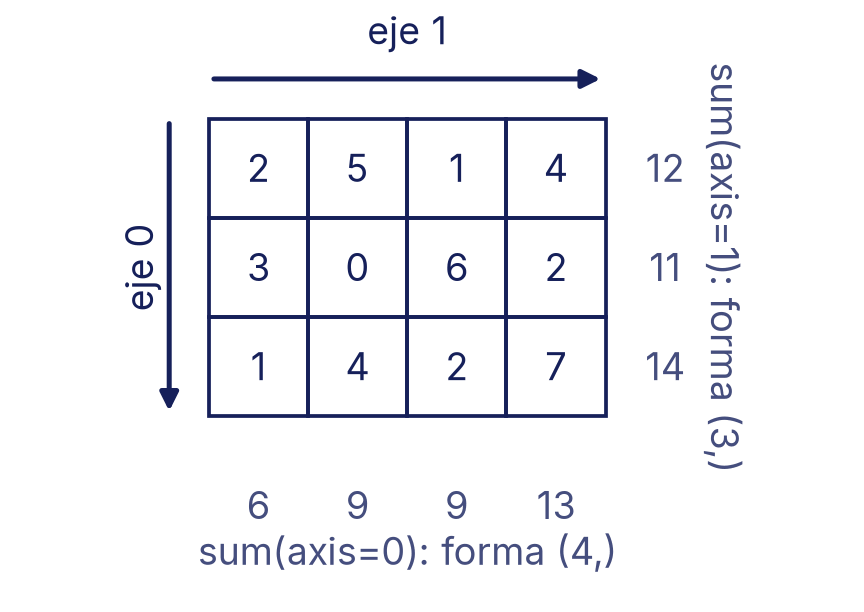
Con las notas, los ejes responden preguntas distintas:
prom_materia = notas.mean(axis=0)     # un promedio por materia
prom_estudiante = notas.mean(axis=1)  # un promedio por estudiante

for materia, p in zip(materias, prom_materia):
    print(f"{materia:<11} {p:5.1f}")
print("Por estudiante:", prom_estudiante.round(1))
print("Mejor estudiante: fila", prom_estudiante.argmax())
print("Nota más alta de cada materia:", notas.max(axis=0))
Matemática 66.3
Física 65.3
Lenguaje 68.2
Biología 70.7
Por estudiante: [68.8 56.8 84. 57.2 89.5 49.5]
Mejor estudiante: fila 4
Nota más alta de cada materia: [95 92 90 88]argmax da la posición del máximo, no el máximo. En arreglos de más dimensiones la regla es la misma: si un arreglo tiene forma (2, 3, 4), sum(axis=1) tacha el 3 y da (2, 4), y sum(axis=(0, 2)) tacha el 2 y el 4 y da (3,).
Cambiar la forma: reshape y transpuesta
Los mismos números se pueden ordenar en otra forma con reshape, siempre que la cantidad total no cambie. La transpuesta .T intercambia filas y columnas.
a = np.arange(12)
print(a, a.shape)

b = a.reshape(3, 4)
print(b)
print("b.T:", b.T.shape)
print(b.T)
print(a.reshape(2, 2, 3).shape)
print(a.reshape(-1, 6).shape)    # -1: «calcula tú este número»
[ 0 1 2 3 4 5 6 7 8 9 10 11] (12,)
[[ 0 1 2 3]
[ 4 5 6 7]
[ 8 9 10 11]]
b.T: (4, 3)
[[ 0 4 8]
[ 1 5 9]
[ 2 6 10]
[ 3 7 11]]
(2, 2, 3)
(2, 6)reshape lee los números en orden, fila por fila, y los vuelve a acomodar. Como 12 = 3 × 4 = 2 × 2 × 3, esas formas funcionan; a.reshape(5, 2) daría un error, porque 5 × 2 = 10 y no 12. Un -1 en una de las dimensiones le pide a NumPy que la calcule: 12 / 6 = 2. En un arreglo de más de dos dimensiones, .T invierte el orden de todos los ejes: una forma (2, 3, 4) pasa a (4, 3, 2).
Broadcasting: operar con formas distintas
Ya usaste broadcasting sin darte cuenta: en arreglo + 10, el número 10 se «estiró» hasta tener la forma de arreglo. Lo mismo pasa entre arreglos. Por ejemplo, para ver qué estudiante está por encima o por debajo del promedio de cada materia, restamos a cada fila el vector de promedios:
print(notas.shape, prom_materia.shape)
diferencia = notas - prom_materia      # (6, 4) - (4,)
print(diferencia[:2].round(1))
(6, 4) (4,)
[[ 5.7 -0.3 11.8 -12.7]
[-21.3 -15.3 -6.2 -0.7]]NumPy restó el vector de 4 promedios a cada una de las 6 filas, como si lo hubiera copiado 6 veces hacia abajo (en realidad no copia nada en memoria, por eso es rápido). Ahora intentemos lo mismo con los estudiantes: restar a cada estudiante su propio promedio.
print(prom_estudiante.shape)
notas - prom_estudiante                # (6, 4) - (6,)
(6,)
Traceback (most recent call last):
...
ValueError: operands could not be broadcast together with shapes (6,4) (6,) No funciona, y la regla explica por qué. Para operar con dos arreglos, NumPy:
- Alinea las formas por la derecha. Si una tiene menos dimensiones, le agrega unos (1) a la izquierda:
(6,)frente a(6, 4)se convierte en(1, 6). - Compara cada par de dimensiones, de derecha a izquierda. Son compatibles si son iguales o si una de las dos es 1.
- Estira los 1 copiando, hasta la otra medida. La forma del resultado es la mayor de cada par.
| penúltima | última | ||
|---|---|---|---|
notas - prom_materia |
6 y (1) | 4 y 4 | compatible: (6, 4) |
notas - prom_estudiante |
6 y (1) | 4 y 6 | choca |
El vector de 6 promedios queda alineado con las 4 columnas, y 4 y 6 ni son iguales ni tienen un 1. La solución es darle la forma (6, 1), una columna, para que se estire hacia la derecha. Hay dos maneras: pedir keepdims=True al promediar, que conserva el eje tachado con tamaño 1, o agregar un eje con np.newaxis.
prom_col = notas.mean(axis=1, keepdims=True)
print(prom_col.shape)                              # (6, 1)
print((notas - prom_col)[:2].round(1))
# Lo mismo, agregando un eje al vector de forma (6,)
print(prom_estudiante[:, np.newaxis].shape)
(6, 1)
[[ 3.2 -3.8 11.2 -10.8]
[-11.8 -6.8 5.2 13.2]]
(6, 1)Cuando una operación falla o da una forma rara, escribe las dos formas una debajo de la otra, alineadas por la derecha, y compáralas columna por columna. Es lo mismo que hace la actividad de arriba.
Producto punto: medir el parecido
Imagina que tres estudiantes, Ana, Beto y Caro, puntúan de 0 a 5 cuánto les gustan cuatro cosas: fútbol, música, lectura y videojuegos. Cada estudiante es un vector de 4 números. ¿Quién se parece más a quién?
El producto punto de dos vectores multiplica término a término y suma todo:
Es grande cuando los dos vectores tienen números grandes en los mismos lugares: cuando a los dos les gusta mucho lo mismo. En NumPy se escribe a @ b (o np.dot(a, b)).
# fútbol, música, lectura, videojuegos
ana = np.array([5, 1, 0, 4])
beto = np.array([4, 0, 1, 5])
caro = np.array([0, 5, 4, 1])

print("Ana · Beto =", ana @ beto)
print("Ana · Caro =", ana @ caro)
print("A mano:    ", np.sum(ana * beto))
Ana · Beto = 40
Ana · Caro = 9
A mano: 40Pero el producto punto también crece si alguien pone notas altas a todo. Para medir solo el parecido, se divide entre el largo de cada vector, su norma:
Ese cociente se llama similitud coseno: vale 1 si los vectores apuntan exactamente hacia el mismo lado, 0 si no tienen nada en común y −1 si son opuestos. Es la misma idea con la que, en la fase 5, un modelo de lenguaje decide que «perro» se parece más a «gato» que a «mesa».
def parecido(a, b):
    """Similitud coseno: el producto punto de los vectores normalizados."""
    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))

print(f"Norma de Ana: {np.linalg.norm(ana):.2f}")
print(f"Ana y Beto: {parecido(ana, beto):.2f}")
print(f"Ana y Caro: {parecido(ana, caro):.2f}")
Norma de Ana: 6.48
Ana y Beto: 0.95
Ana y Caro: 0.21Normalizar filas y multiplicar matrices
Si apilamos los tres vectores en una matriz, podemos normalizar cada fila (dividirla entre su norma) de una vez, con broadcasting: la norma de cada fila con keepdims=True tiene forma (3, 1). Después, una sola multiplicación de matrices calcula el parecido de todos con todos.
G = np.array([ana, beto, caro])                  # forma (3, 4)
normas = np.linalg.norm(G, axis=1, keepdims=True)  # forma (3, 1)
G_unit = G / normas                              # cada fila mide 1
print(np.linalg.norm(G_unit, axis=1))

similitudes = G_unit @ G_unit.T                  # (3, 4) @ (4, 3)
print(similitudes.shape)
print(similitudes.round(2))
[1. 1. 1.]
(3, 3)
[[1. 0.95 0.21]
[0.95 1. 0.21]
[0.21 0.21 1. ]]La fila i, columna j del resultado es el producto punto de la fila i de la primera matriz con la columna j de la segunda. Por eso las medidas de adentro tienen que coincidir: (m, n) @ (n, p) da (m, p). Aquí, (3, 4) @ (4, 3) da (3, 3). La diagonal vale 1 (cada uno se parece totalmente a sí mismo) y la matriz es simétrica.
Una matriz por un vector transforma el vector
Una matriz de 2 × 2 multiplicada por un punto del plano da otro punto del plano. Si aplicas la misma matriz a todos los puntos de una figura, la figura se estira, se inclina o gira: la matriz es una transformación. Las capas de una red neuronal (tema 16) son exactamente esto, matrices que transforman vectores, una tras otra.
T = np.array([[1.5, 0.5],
              [0.0, 1.0]])
angulos = np.linspace(0, 2 * np.pi, 100)
# 100 puntos de un círculo, uno por columna: forma (2, 100)
circulo = np.array([np.cos(angulos), np.sin(angulos)])
transformado = T @ circulo                       # (2, 2) @ (2, 100)

v = np.array([0.0, 1.0])
print("T @ v =", T @ v)

plt.plot(circulo[0], circulo[1], color="C2", label="Antes")
plt.plot(transformado[0], transformado[1], color="C0",
         label="Después de T")
plt.annotate("", xy=v, xytext=(0, 0),
             arrowprops=dict(arrowstyle="-|>", color="C2", lw=2))
plt.annotate("", xy=T @ v, xytext=(0, 0),
             arrowprops=dict(arrowstyle="-|>", color="C1", lw=2.5))
plt.text(0.5, 0.35, "T @ v")
plt.gca().set_aspect("equal")
plt.ylim(-1.2, 1.9)
plt.title("Una matriz transforma el plano")
plt.legend(loc="upper center", ncol=2)
plt.show()
T @ v = [0.5 1. ]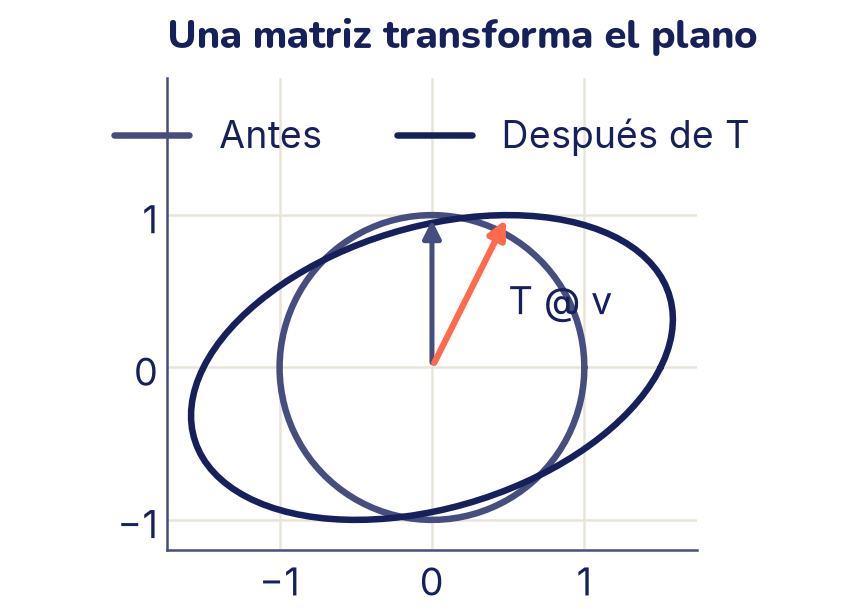
El punto (0, 1) pasó a (0,5; 1): la matriz empuja hacia la derecha lo que está arriba y estira en horizontal. Todo el círculo se convirtió en una elipse inclinada con una sola multiplicación de matrices, sin recorrer los 100 puntos.
Una imagen es un arreglo
Para la computadora, una foto en color es un tensor de tres dimensiones: alto × ancho × 3, un número de 0 a 255 por cada canal de color (rojo, verde, azul) de cada píxel. scikit-learn trae dos fotos de ejemplo, así que no hace falta descargar nada.
from sklearn.datasets import load_sample_image

foto = load_sample_image("china.jpg")
print(type(foto).__name__, foto.shape, foto.dtype)
print("Píxel de arriba a la izquierda (R, G, B):", foto[0, 0])
print("Valor más chico y más grande:", foto.min(), foto.max())
ndarray (427, 640, 3) uint8
Píxel de arriba a la izquierda (R, G, B): [174 201 231]
Valor más chico y más grande: 0 255La foto mide 427 píxeles de alto y 640 de ancho, y cada número es un uint8: un entero sin signo de 8 bits, de 0 a 255. Todo lo que aprendiste sirve tal cual:
- Recortar es rebanar filas y columnas.
- Voltear como en un espejo es recorrer las columnas al revés, con paso −1.
- Pasar a gris es un promedio ponderado de los tres canales: el ojo es más sensible al verde, así que pesa más. Es una matriz por vector:
(427, 640, 3) @ (3,)da(427, 640), porque el@hace el producto punto de cada píxel con los pesos.
recorte = foto[60:300, 150:470]      # filas 60 a 299, columnas 150 a 469
espejo = foto[:, ::-1]               # las columnas, de atrás para adelante
pesos = np.array([0.299, 0.587, 0.114])
gris = foto @ pesos                  # un número por píxel
print(recorte.shape, espejo.shape, gris.shape)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
ejes[0, 0].imshow(foto)
ejes[0, 0].set_title("Original")
ejes[0, 1].imshow(recorte)
ejes[0, 1].set_title("Recortada")
ejes[1, 0].imshow(espejo)
ejes[1, 0].set_title("Volteada")
ejes[1, 1].imshow(gris, cmap="gray")
ejes[1, 1].set_title("En gris")
for eje in ejes.flat:
    eje.axis("off")
plt.show()
(240, 320, 3) (427, 640, 3) (427, 640)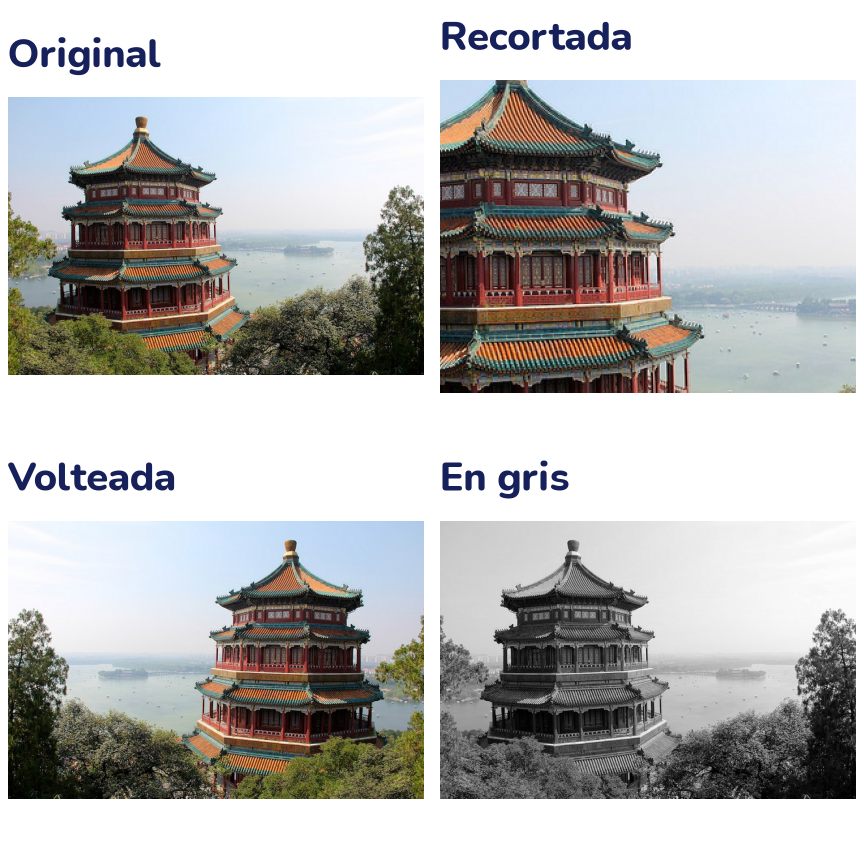
Un lote de imágenes
Las redes neuronales no ven una foto a la vez, sino lotes: varias fotos del mismo tamaño apiladas en un tensor de cuatro dimensiones, (N, alto, ancho, 3). np.stack apila arreglos de la misma forma a lo largo de un eje nuevo.
lote = np.stack([foto, espejo, foto[::-1]])      # tres fotos
print("lote:", lote.shape)                        # (N, alto, ancho, 3)
print("una foto:", lote[1].shape)
print("el píxel (0, 0) de cada foto:", lote[:, 0, 0].shape)
# El color promedio de cada foto: se tachan el alto y el ancho
print(lote.mean(axis=(1, 2)).round(1))
lote: (3, 427, 640, 3)
una foto: (427, 640, 3)
el píxel (0, 0) de cada foto: (3, 3)
[[144.7 145.5 140.9]
[144.7 145.5 140.9]
[144.7 145.5 140.9]]Las tres fotos tienen el mismo color promedio, como debía ser: tienen los mismos píxeles, solo que en otro orden. Así se ve un lote en PyTorch (tema 18), con la diferencia de que allá los canales suelen ir antes del alto y el ancho: (N, 3, alto, ancho). Pasar de una forma a la otra es una transpuesta de ejes.
Vectorizar: cambiar bucles por arreglos
¿Cuánto se gana de verdad? Calculemos la suma de los cuadrados de un millón de números, primero con un bucle de Python y después con NumPy, y midamos el tiempo con time.perf_counter(), un cronómetro de alta precisión.
import time

grande = rng.random(1_000_000)        # un millón de números entre 0 y 1

inicio = time.perf_counter()
total = 0.0
for valor in grande:
    total += valor * valor
t_bucle = time.perf_counter() - inicio

inicio = time.perf_counter()
total_np = np.sum(grande * grande)
t_numpy = time.perf_counter() - inicio

print("¿Dan lo mismo?", np.isclose(total, total_np))
print("¿NumPy fue más de 10 veces más rápido?", t_bucle > 10 * t_numpy)
¿Dan lo mismo? True
¿NumPy fue más de 10 veces más rápido? TrueLos tiempos cambian de una computadora a otra y de una vez a otra, por eso el código no los imprime. En la computadora donde se escribió este tema, el bucle tardó unos 75 milisegundos y NumPy menos de uno: alrededor de 100 veces más rápido. Agrega print(t_bucle, t_numpy) para ver los tuyos. En Colab hay una forma más cómoda de medir: escribe %timeit np.sum(grande * grande) en una celda: repite la medición muchas veces y te da el tiempo promedio.
¿Por qué tanta diferencia? En el bucle, Python revisa en cada vuelta qué tipo tiene valor, busca cómo multiplicarlo y crea un número nuevo. Un arreglo de NumPy guarda números de un solo tipo, juntos en la memoria, y la operación completa corre en código compilado, sin esas revisiones. Vectorizar es escribir el cálculo como operaciones sobre arreglos enteros en lugar de un bucle que visita los números uno por uno. Con datos grandes, es la diferencia entre esperar un segundo y esperar dos minutos.
Lo que aprendiste y lo que sigue
- Un arreglo de NumPy guarda números de un solo
dtypeen una forma (shape). Un vector tiene una dimensión, una matriz dos y un tensor, tres o más: una foto es(alto, ancho, 3)y un lote de fotos,(N, alto, ancho, 3). - Se indexa con
[fila, columna], se rebana coninicio:fin:pasoy se filtra con condiciones. - Una operación por eje tacha ese eje de la forma:
sum(axis=0)en una matriz de(3, 4)da(4,). - El broadcasting compara las formas de derecha a izquierda: cada par tiene que ser igual o tener un 1, que se estira.
keepdims=Trueynp.newaxisayudan a acomodar las formas. - El producto punto mide el parecido entre vectores; dividido entre las normas, es la similitud coseno.
(m, n) @ (n, p)da(m, p), y una matriz por un vector es una transformación. - Vectorizar da el mismo resultado que un bucle, decenas o cientos de veces más rápido.
En el tema 4 vas a usar pandas, que pone nombres a las filas y las columnas de estos arreglos para explorar datos reales. En el tema 6, el descenso de gradiente se escribe en tres líneas gracias a las operaciones vectorizadas y al producto de matrices de este tema.