Antes de empezar
Varios ejercicios usan las variables de la teoría: np, plt, rng, notas, materias, ana, beto, caro, G_unit, parecido, foto, recorte, pesos y lote. Abre un cuaderno nuevo en Colab, pega y ejecuta en orden los bloques de la ficha Código y después trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta: en este tema conviene escribir primero la forma que esperas y recién después comprobarla con .shape.
Ejercicios
1. Predecir formas
Sin computadora, escribe la forma del resultado de cada línea, o «error» si NumPy no puede calcularla. Usa a = np.zeros((2, 3, 4)).
np.arange(24).reshape(4, -1)a.Ta.sum(axis=1)a.mean(axis=(0, 2))a[0]ya[:, 0]np.ones((5, 1)) + np.ones(3)np.ones((8, 1, 6)) * np.ones((7, 1))np.ones((2, 3)) @ np.ones((3, 5))np.ones((2, 3)) + np.ones((3, 2))
Respuesta
a = np.zeros((2, 3, 4))
print("1:", np.arange(24).reshape(4, -1).shape)
print("2:", a.T.shape)
print("3:", a.sum(axis=1).shape)
print("4:", a.mean(axis=(0, 2)).shape)
print("5:", a[0].shape, a[:, 0].shape)
print("6:", (np.ones((5, 1)) + np.ones(3)).shape)
print("7:", (np.ones((8, 1, 6)) * np.ones((7, 1))).shape)
print("8:", (np.ones((2, 3)) @ np.ones((3, 5))).shape)
1: (4, 6)
2: (4, 3, 2)
3: (2, 4)
4: (3,)
5: (3, 4) (2, 4)
6: (5, 3)
7: (8, 7, 6)
8: (2, 5)- 24 / 4 = 6, así que el
-1vale 6. .Tinvierte el orden de todos los ejes.- y 4. Se tachan los ejes pedidos: el 3 en el primer caso; el 2 y el 4 en el segundo.
a[0]fija el eje 0 y deja los otros dos;a[:, 0]fija el eje 1.- Alineadas por la derecha:
(5, 1)y(1, 3). El 1 de cada lado se estira:(5, 3). (7, 1)pasa a(1, 7, 1). De derecha a izquierda: 6 y 1 dan 6; 1 y 7 dan 7; 8 y 1 dan 8.- Las medidas de adentro coinciden (3 y 3) y quedan las de afuera:
(2, 5). - Error. La última dimensión es 3 frente a 2: ni iguales ni con un 1.
np.ones((2, 3)) + np.ones((3, 2))Traceback (most recent call last):
...
ValueError: operands could not be broadcast together with shapes (2,3) (3,2) 2. Sacar partes de un tensor
lote tiene forma (3, 427, 640, 3): tres fotos, cada una de alto × ancho × canales. Escribe una sola expresión para cada pedido y anota la forma que esperas antes de comprobarla.
- La tercera foto del lote.
- El canal verde (índice 1) de todas las fotos.
- El cuadrado de 100 × 100 píxeles de la esquina inferior derecha de cada foto, con sus tres canales.
- La primera foto achicada: una de cada cuatro filas y una de cada cuatro columnas.
- ¿Qué fracción de los píxeles de
fototiene más azul que rojo? (Pista: el promedio de un arreglo deTrueyFalsees la fracción deTrue.) - Crea con
np.arangeyreshapeun arreglo de forma(2, 3, 4, 5)con los números del 0 en adelante. ¿Qué número está en la posición[1, 2, 3, 4]? ¿Por qué?
Respuesta
print("1:", lote[2].shape)
print("2:", lote[:, :, :, 1].shape)
print("3:", lote[:, -100:, -100:].shape)
print("4:", lote[0, ::4, ::4].shape)

mas_azul = foto[:, :, 2] > foto[:, :, 0]
print(f"5: {mas_azul.mean():.2f} de los píxeles")

t = np.arange(2 * 3 * 4 * 5).reshape(2, 3, 4, 5)
print("6:", t.shape, t[1, 2, 3, 4], t.size)
1: (427, 640, 3)
2: (3, 427, 640)
3: (3, 100, 100, 3)
4: (107, 160, 3)
5: 0.52 de los píxeles
6: (2, 3, 4, 5) 119 120- En el 3,
-100:toma las últimas 100 filas y las últimas 100 columnas; el canal, que no se menciona, queda entero. - En el 4, 427 filas de cuatro en cuatro dan 107, porque se incluye la fila 0.
- En el 5, algo más de la mitad de los píxeles (0,52) tiene más azul que rojo: el cielo y el agua ocupan buena parte de la foto.
- En el 6,
[1, 2, 3, 4]es la última posición de cada eje, así que es el último número: 119, uno menos que los 120 que hay.
3. Parecido y matrices
- Calcula a mano el producto punto de
[1, 2, 3]y[4, 5, 6], y compruébalo con@. - Dani puntúa así fútbol, música, lectura y videojuegos:
[1, 4, 5, 0]. Normaliza su vector y calcula, con una sola multiplicación de matriz por vector, su parecido con Ana, Beto y Caro (usaG_unit). ¿A quién se parece más? ¿Qué forma tiene el resultado y por qué? - Eli le pone 5 a todo:
[5, 5, 5, 5]. Compara el producto punto de Ana con Beto y de Ana con Eli. Después compara sus parecidos. ¿Cuál de las dos medidas te dice mejor quién comparte los gustos de Ana?
Respuesta
- 1·4 + 2·5 + 3·6 = 4 + 10 + 18 = 32.
print("1:", np.array([1, 2, 3]) @ np.array([4, 5, 6]))

dani = np.array([1, 4, 5, 0])
dani_unit = dani / np.linalg.norm(dani)
print("2:", G_unit.shape, "@", dani_unit.shape)
print("   Ana, Beto, Caro:", (G_unit @ dani_unit).round(2))

eli = np.array([5, 5, 5, 5])
print("3: Ana · Beto =", ana @ beto, "  Ana · Eli =", ana @ eli)
print(f"   parecido Ana-Beto: {parecido(ana, beto):.2f}"
      f"   Ana-Eli: {parecido(ana, eli):.2f}")
1: 32
2: (3, 4) @ (4,)
Ana, Beto, Caro: [0.21 0.21 0.95]
3: Ana · Beto = 40 Ana · Eli = 50
parecido Ana-Beto: 0.95 Ana-Eli: 0.77(3, 4) @ (4,)da(3,): un parecido por cada fila deG_unit. Dani se parece mucho a Caro y poco a Ana y a Beto.- Ana · Eli es más grande que Ana · Beto, solo porque Eli pone números altos a todo. El parecido corrige eso: Beto comparte los gustos de Ana mucho más que Eli. Para comparar gustos sirve el parecido, no el producto punto solo.
4. Tres bucles para vectorizar
Escribe cada bucle en una sola línea de NumPy, sin for, y comprueba que da lo mismo. Después mide con time.perf_counter() cuántas veces más rápida es tu versión del bucle 3.
valores = rng.normal(60, 15, size=10_000)

# Bucle 1: cada valor al cuadrado, más 1
cuadrados = []
for v in valores:
    cuadrados.append(v ** 2 + 1)

# Bucle 2: cuántos valores superan el promedio
promedio = sum(valores) / len(valores)
cuenta = 0
for v in valores:
    if v > promedio:
        cuenta += 1

# Bucle 3: pasar una imagen a gris, píxel por píxel
def gris_con_bucle(imagen):
    alto, ancho, _ = imagen.shape
    resultado = np.zeros((alto, ancho))
    for i in range(alto):
        for j in range(ancho):
            r, g, b = imagen[i, j]
            resultado[i, j] = 0.299 * r + 0.587 * g + 0.114 * b
    return resultado
Respuesta
cuadrados_np = valores ** 2 + 1
cuenta_np = (valores > valores.mean()).sum()
print("1:", np.allclose(cuadrados, cuadrados_np))
print("2:", cuenta, cuenta_np)

inicio = time.perf_counter()
gris_b = gris_con_bucle(recorte)
t_bucle = time.perf_counter() - inicio

inicio = time.perf_counter()
gris_v = recorte @ pesos
t_vector = time.perf_counter() - inicio

print("3:", np.allclose(gris_b, gris_v), gris_v.shape)
print("¿Más de 50 veces más rápido?", t_bucle > 50 * t_vector)
1: True
2: 4969 4969
3: True (240, 320)
¿Más de 50 veces más rápido? TrueEl bucle 3 recorre los 76 800 píxeles del recorte (240 × 320) de a uno. En la computadora donde se escribió este tema tardó algo más de una décima de segundo, y la versión vectorizada, una o dos décimas de milisegundo: entre 600 y 1200 veces menos, según la medición. Tus números serán otros, pero la diferencia va a ser de cientos de veces. En Colab puedes compararlos con %timeit gris_con_bucle(recorte) y %timeit recorte @ pesos.
5. Distancias entre todos los pares
Cuatro puntos del plano están en las filas de P = np.array([[0, 0], [3, 4], [6, 0], [3, -4]]). Calcula la matriz de 4 × 4 con la distancia euclidiana entre cada par de puntos, sin bucles. La distancia entre (x₁, y₁) y (x₂, y₂) es √((x₁ − x₂)² + (y₁ − y₂)²).
Pista: P[:, np.newaxis, :] tiene forma (4, 1, 2) y P[np.newaxis, :, :] tiene forma (1, 4, 2). ¿Qué forma tiene su resta?
Respuesta
P = np.array([[0, 0], [3, 4], [6, 0], [3, -4]])
diferencias = P[:, np.newaxis, :] - P[np.newaxis, :, :]
print("Diferencias:", diferencias.shape)
distancias = np.sqrt((diferencias ** 2).sum(axis=-1))
print(distancias)

# Comprobación con dos bucles
con_bucle = np.zeros((4, 4))
for i in range(4):
    for j in range(4):
        con_bucle[i, j] = np.linalg.norm(P[i] - P[j])
print("¿Iguales?", np.allclose(distancias, con_bucle))
Diferencias: (4, 4, 2)
[[0. 5. 6. 5.]
[5. 0. 5. 8.]
[6. 5. 0. 5.]
[5. 8. 5. 0.]]
¿Iguales? TruePor broadcasting, (4, 1, 2) - (1, 4, 2) da (4, 4, 2): para cada par (i, j), la diferencia entre el punto i y el punto j. Sumar los cuadrados en el último eje (axis=-1 es «el último») lo tacha y deja (4, 4). La matriz tiene ceros en la diagonal (cada punto está a distancia 0 de sí mismo) y es simétrica, porque de i a j hay lo mismo que de j a i. Esta misma cuenta es el corazón de los vecinos cercanos (tema 8) y del clustering (tema 14).
6. Escalar por materia y por estudiante
- Escala las notas por materia: en cada columna, la nota más baja tiene que quedar en 0 y la más alta en 1. Usa
(notas - mínimo) / (máximo - mínimo), con los mínimos y máximos de cada columna. - Haz lo mismo por estudiante: en cada fila, su peor nota queda en 0 y la mejor en 1. Si te sale un
ValueError, escribe las formas una debajo de la otra y arréglalo.
Respuesta
minimo = notas.min(axis=0)                    # forma (4,)
maximo = notas.max(axis=0)
por_materia = (notas - minimo) / (maximo - minimo)
print("1:", minimo.shape, por_materia.shape)
print(por_materia[:2].round(2))

minimo = notas.min(axis=1, keepdims=True)     # forma (6, 1)
maximo = notas.max(axis=1, keepdims=True)
por_estudiante = (notas - minimo) / (maximo - minimo)
print("2:", minimo.shape, por_estudiante.shape)
print(por_estudiante[:2].round(2))
1: (4,) (6, 4)
[[0.6 0.39 0.77 0. ]
[0.12 0.05 0.35 0.4 ]]
2: (6, 1) (6, 4)
[[0.64 0.32 1. 0. ]
[0. 0.2 0.68 1. ]]Por materia no hace falta nada especial: (6, 4) con (4,) estira el vector hacia abajo. Por estudiante, notas.min(axis=1) da (6,), que choca con las 4 columnas; con keepdims=True es (6, 1) y se estira hacia la derecha. Comprueba que cada columna del primer resultado y cada fila del segundo tiene un 0 y un 1.
Mini-proyecto: filtros de imagen
Programa cuatro filtros que reciban una foto (un arreglo de forma (alto, ancho, 3) y tipo uint8) y devuelvan otra foto de tipo uint8, solo con NumPy y sin bucles. Pruébalos con foto y muestra los cuatro resultados en una cuadrícula de 2 × 2 con plt.subplots(2, 2, figsize=(4.8, 4.8)), como en la teoría.
- Brillo. Suma una cantidad a todos los números. Antes, mira qué da
foto[0, 0] + 100y explica por qué. Para evitarlo, pasa la foto a enteros grandes con.astype(int), suma, limita connp.clip(..., 0, 255)y vuelve auint8con.astype(np.uint8). - Negativo. Cada número v pasa a 255 − v: lo oscuro se vuelve claro y cada color, su opuesto.
- Espejo. La mitad izquierda de la foto queda igual y la mitad derecha es su reflejo, como si hubiera un espejo vertical en el centro. (Pista:
foto.copy()y asignar a una rebanada.) - Pixelado. Divide la foto en bloques de 16 × 16 píxeles y pinta cada bloque con su color promedio. Recorta primero la foto para que el alto y el ancho sean múltiplos de 16. Pista: con
reshape, un arreglo de(416, 640, 3)se puede ver como(26, 16, 40, 16, 3); ¿qué ejes tienes que promediar? Para volver al tamaño original, usanp.repeat(chica, 16, axis=0)y lo mismo conaxis=1.
Para ir más allá: haz que tus filtros funcionen también con todo lote a la vez, un arreglo de cuatro dimensiones. ¿Cuáles funcionan sin cambios? ¿Qué hay que cambiar en el pixelado?
Una solución de referencia, para comparar con la tuya
print("foto[0, 0] + 100 =", foto[0, 0] + 100, "  foto[0, 0] =", foto[0, 0])

def brillo(img, cantidad):
    return np.clip(img.astype(int) + cantidad, 0, 255).astype(np.uint8)

def negativo(img):
    return 255 - img

def espejo(img):
    resultado = img.copy()
    mitad = img.shape[1] // 2
    # La mitad derecha es la izquierda leída de atrás para adelante
    resultado[:, mitad:] = img[:, :mitad][:, ::-1]
    return resultado

def pixelado(img, lado=16):
    alto = img.shape[0] // lado * lado
    ancho = img.shape[1] // lado * lado
    bloques = img[:alto, :ancho].reshape(alto // lado, lado,
                                         ancho // lado, lado, 3)
    # El promedio de cada bloque: se tachan los ejes de adentro
    chica = bloques.mean(axis=(1, 3))
    grande = np.repeat(np.repeat(chica, lado, axis=0), lado, axis=1)
    return grande.astype(np.uint8)

filtros = [("Más brillo", brillo(foto, 70)), ("Negativo", negativo(foto)),
           ("Espejo", espejo(foto)), ("Pixelado", pixelado(foto))]
for nombre, img in filtros:
    print(f"{nombre:<10} {img.shape} {img.dtype}")

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
for eje, (nombre, img) in zip(ejes.flat, filtros):
    eje.imshow(img)
    eje.set_title(nombre)
    eje.axis("off")
plt.show()
foto[0, 0] + 100 = [18 45 75] foto[0, 0] = [174 201 231]
Más brillo (427, 640, 3) uint8
Negativo (427, 640, 3) uint8
Espejo (427, 640, 3) uint8
Pixelado (416, 640, 3) uint8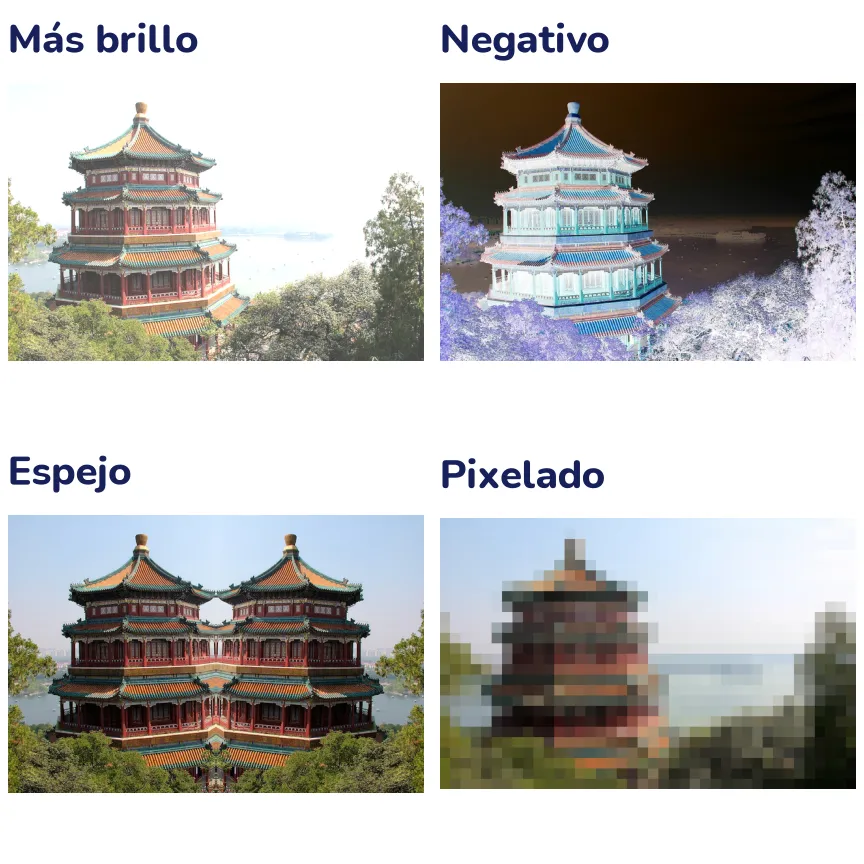
foto[0, 0] + 100da números más chicos que los originales: unuint8solo llega hasta 255 y, al pasarse, da la vuelta y vuelve a empezar desde 0 (por ejemplo, 174 + 100 = 274, que se guarda como 274 − 256 = 18). NumPy no avisa. Por eso el brillo pasa primero aint.- El pixelado pierde las últimas 11 filas (427 no es múltiplo de 16): la foto queda de 416 × 640.
- Con
lote, el brillo y el negativo funcionan sin cambios: operan con cada número, sin importar la forma. En el espejo y el pixelado, el ancho pasa a ser el eje 2 y el alto el eje 1, así que hay que agregar un:al principio de cada rebanada, un eje más (el de las N fotos) al principio delreshapey sumar 1 a los ejes delmeany de losrepeat.
Errores comunes
- Confundir el eje.
axis=0no es «por fila»: recorre las filas y deja un resultado por columna. Ante la duda, piensa qué eje desaparece de la forma. - El desborde de
uint8. Sumar o restar a una imagen sin pasarla antes aintofloatda la vuelta al pasar de 255 o de 0, sin ningún aviso. - Creer que una rebanada es una copia.
parte = notas[0]y despuésparte[0] = 100también cambianotas. Usa.copy()cuando quieras un arreglo independiente. - Broadcasting que no da error, pero sí un resultado equivocado.
(6,)con(6, 1)no falla: da una matriz de(6, 6). Si el resultado tiene una forma que no esperabas, revisa las formas antes de seguir. - Usar
*cuando querías@.a * bmultiplica elemento a elemento;a @ bes el producto punto o el producto de matrices. - Usar
reshapepara transponer.b.reshape(4, 3)no es lo mismo queb.T:reshapevuelve a acomodar los números en el mismo orden;.Tcambia filas por columnas. - Medir el tiempo una sola vez. Una medición suelta puede salir rara porque la computadora estaba ocupada en otra cosa.
%timeitrepite muchas veces por eso. - Volver a los bucles por costumbre. Si estás recorriendo un arreglo con
forpara hacer la misma cuenta en cada elemento, casi siempre hay una versión vectorizada.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Crear, indexar y rebanar arreglos de 1 a 4 dimensiones (ejercicio 2 y el mini-proyecto).
- Predecir la forma del resultado de
reshape,transpose,sum(axis=…)y del broadcasting (ejercicios 1 y 6). - Multiplicar matrices y explicar el producto punto como «parecido» entre vectores (ejercicio 3).
- Reemplazar un bucle por una operación vectorizada y medir cuánto se acelera (ejercicios 4 y 5).