La pregunta
Lee estas dos frases:
- «Ana sacó plata del banco».
- «Ana se sentó en el banco de la plaza».
La palabra es la misma, pero tú sabes al instante que en la primera es un lugar donde se guarda dinero y en la segunda, un asiento. ¿Cómo lo sabes? Porque no lees «banco» sola: la miras junto con las demás palabras. «Plata» empuja hacia un significado; «se sentó» y «plaza», hacia el otro.
En el tema 22 cada palabra se convirtió en un vector, su embedding. Pero ese vector es siempre el mismo: «banco» tiene un único vector en las dos frases. Hace falta un mecanismo que deje a cada palabra mirar a las otras y mezclar en su vector lo que le sirve de ellas. Ese mecanismo se llama atención, y es la pieza central de los transformers, la arquitectura detrás de los traductores automáticos, de los modelos de lenguaje como los chatbots y, como verás al final, de muchos modelos que miran imágenes.
En este tema vas a:
- calcular a mano y en código la atención de producto punto escalada, softmax(QKᵀ/√d)·V;
- explicar las consultas, claves y valores con una analogía y con matrices;
- programar en PyTorch la atención con varias cabezas, comprobarla contra
nn.MultiheadAttentiony armar un bloque transformer completo; - explicar la máscara causal, la codificación posicional y la diferencia entre codificador y decodificador;
- entrenar un transformer pequeño que aprende a invertir una secuencia de dígitos y mirar a dónde atiende;
- partir una imagen en parches y tratarlos como palabras, como hace un Vision Transformer.
Necesitas lo de los temas 18 y 19 (tensores, nn.Module, el bucle de entrenamiento, Adam y la normalización por lotes) y lo del tema 22 (embeddings y nn.Embedding). No vamos a usar ningún modelo ya entrenado: todo se construye desde cero.
Actividad: ¿a quién mira cada palabra?
La frase de abajo tiene siete palabras. Cada una tiene dos vectores de juguete de dos números: una consulta (lo que la palabra busca) y una clave (lo que la palabra ofrece). En el plano, la flecha coral es la consulta de la palabra elegida y los puntos son las claves de todas. Cuanto más apunten en la misma dirección la consulta de una palabra y la clave de otra (y cuanto más largas sean), más la mira. Elige una palabra (pasa el cursor, tócala o recórrelas con el teclado): los arcos salen de ella hacia las demás, más gruesos cuanto mayor es el peso de atención, y las barras de abajo dan los porcentajes, que siempre suman 100 %.
¿A quién mira cada palabra?
Este es el estado inicial: los pesos de atención de «banco». Con JavaScript activado puedes elegir otra palabra, arrastrar los vectores, cambiar la temperatura y activar la máscara causal.
Elige una palabra con el cursor, un toque o el teclado; entre las palabras, las flechas izquierda y derecha cambian de palabra. En el plano, la flecha coral es la consulta de la palabra elegida y los puntos son las claves de todas. Con el foco en la consulta o en una clave, las flechas del teclado la mueven; con Mayúsculas, a pasos más largos.
peso de cada palabra = softmax de q · k / (√2 · T), sobre las palabras que se pueden mirar
«banco» mira sobre todo a «plata» (61 %) y después a sí misma (28 %).
Prueba esto, en orden:
- Elige «banco». ¿A qué palabra mira más? Ahora elige «la» y «guardó»: ¿a quién miran?
- Arrastra la consulta de «banco» (la flecha coral) hasta que mire sobre todo a «Ana». Después devuélvela con «Volver al inicio».
- Baja la temperatura al mínimo y súbela al máximo. ¿Qué pasa con los arcos? ¿Hay alguna temperatura en la que todas las palabras reciban lo mismo?
- Elige «el» y activa el interruptor «Causal». ¿A dónde se fue el arco más grueso? ¿Qué palabra puede mirar la primera palabra, «Ana», con la máscara puesta?
- Arrastra la clave de «plata» lejos del centro, en la misma dirección. ¿Por qué ahora casi todas las palabras la miran a ella?
Los vectores de la actividad los elegimos a mano, en dos dimensiones, para que se puedan dibujar. En un transformer de verdad tienen decenas o cientos de números y no los elige nadie: salen de multiplicar el embedding de cada palabra por matrices que se aprenden con el descenso de gradiente.
Leer palabra por palabra no alcanza
Antes de los transformers, los textos se procesaban sobre todo con redes recurrentes (RNN): una red que lee una palabra, actualiza un vector de «memoria» y pasa a la siguiente. No las vamos a programar, pero conviene saber por qué se dejaron de lado:
- Se olvidan. Toda la frase tiene que pasar por un único vector de memoria, palabra tras palabra. Lo que se leyó cincuenta palabras atrás llega muy desgastado.
- Son lentas de entrenar. Para procesar la palabra 100 hay que haber procesado antes la 99, y antes la 98. No se puede repartir el trabajo entre muchos núcleos a la vez.
La atención resuelve las dos cosas: cada palabra mira directamente a cualquier otra, esté a una o a mil posiciones, y todas las palabras hacen sus cuentas al mismo tiempo, con productos de matrices.
La atención es una búsqueda suave
Piensa en un diccionario de Python (tema 2). Le das una clave y te devuelve el valor guardado con esa clave exacta. Si la clave no está, error. La atención es una versión suave de lo mismo:
- Cada palabra hace una consulta (query, q): un vector que describe lo que busca.
- Cada palabra ofrece una clave (key, k): un vector que describe lo que tiene.
- Cada palabra guarda un valor (value, v): el contenido que entrega si la miran.
En lugar de buscar la clave exacta, la consulta se compara con todas las claves con un producto punto (el «parecido» entre vectores del tema 3). Esos parecidos se convierten en pesos que suman 1 con un softmax, y la respuesta es el promedio de los valores, ponderado por esos pesos. Si una clave se parece muchísimo a la consulta, casi todo el peso va a ella y se comporta como el diccionario; si varias se parecen, la respuesta mezcla sus valores.
Con todas las consultas en las filas de una matriz Q, las claves en K y los valores en V, la cuenta completa es una sola fórmula:
- QKᵀ es la tabla de todos los productos punto: en la fila i, columna j, cuánto le interesa la palabra j a la palabra i.
- d es el largo de cada consulta y cada clave; dividir por √d mantiene los puntajes en una escala razonable (lo vemos enseguida).
- El softmax se aplica a cada fila: los pesos de cada palabra suman 1.
- Multiplicar por V hace los promedios ponderados.
A mano, con tres palabras
Tres palabras, cada una con una consulta, una clave y un valor de dos números (d = 2), elegidos a mano para poder seguir las cuentas.
import math
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import LinearSegmentedColormap
import torch
from torch import nn

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

# Una fila por palabra: «Ana», «sacó», «plata»
Q = torch.tensor([[0.0, 1.0],
                  [1.0, 1.0],
                  [2.0, 0.0]])
K = torch.tensor([[0.0, 2.0],
                  [1.0, 0.0],
                  [2.0, 1.0]])
V = torch.tensor([[1.0, 0.0],
                  [0.0, 1.0],
                  [1.0, 1.0]])

puntajes = Q @ K.T / math.sqrt(2)       # (3, 3): cada palabra con cada otra
pesos = torch.softmax(puntajes, dim=-1)  # cada fila suma 1
salida = pesos @ V                       # promedios ponderados de los valores

print("Puntajes:\n", puntajes.round(decimals=2))
print("Pesos:\n", pesos.round(decimals=2))
print("Suma de cada fila:", pesos.sum(dim=-1))
print("Salida:\n", salida.round(decimals=2))
Puntajes:
tensor([[1.4100, 0.0000, 0.7100],
[1.4100, 0.7100, 2.1200],
[0.0000, 1.4100, 2.8300]])
Pesos:
tensor([[0.5800, 0.1400, 0.2800],
[0.2800, 0.1400, 0.5800],
[0.0500, 0.1900, 0.7700]])
Suma de cada fila: tensor([1.0000, 1.0000, 1.0000])
Salida:
tensor([[0.8600, 0.4200],
[0.8600, 0.7200],
[0.8100, 0.9500]])Sigue la primera fila con lápiz. La consulta de «Ana» es (0, 1). Sus productos punto con las tres claves son 0·0 + 1·2 = 2, 0·1 + 1·0 = 0 y 0·2 + 1·1 = 1. Divididos por √2 ≈ 1,41 quedan 1,41, 0 y 0,71. El softmax los convierte en 0,58, 0,14 y 0,28: «Ana» mira sobre todo a la primera palabra (a sí misma). Su salida es 0,58·(1, 0) + 0,14·(0, 1) + 0,28·(1, 1) = (0,86; 0,42). Cada palabra sale de la atención con un vector nuevo, que es una mezcla de los valores de toda la frase.
¿Por qué dividir por √d?
El producto punto suma d productos. Si los números de q y k son al azar, con desviación 1, la suma crece con d: su desviación estándar es √d. Con d = 512, los puntajes serían del orden de 20 o 30, y un softmax con números así de grandes pone casi todo el peso en una sola palabra. Eso es malo para entrenar: el gradiente del softmax casi se anula y la red deja de aprender.
for dim in [2, 64, 512]:
    q = torch.randn(1000, dim)           # 1000 consultas al azar
    k = torch.randn(8, dim)              # 8 claves al azar
    punto = q @ k.T                      # (1000, 8)
    escalado = punto / math.sqrt(dim)
    # El peso más grande de cada fila, en promedio
    p_sin = torch.softmax(punto, dim=-1).max(dim=-1).values.mean()
    p_con = torch.softmax(escalado, dim=-1).max(dim=-1).values.mean()
    print(f"d = {dim:3d}: desviación {punto.std():5.1f} -> "
          f"{escalado.std():.2f}   peso máximo {p_sin:.2f} -> "
          f"{p_con:.2f}")
d = 2: desviación 1.5 -> 1.05 peso máximo 0.40 -> 0.32
d = 64: desviación 8.0 -> 1.00 peso máximo 0.87 -> 0.36
d = 512: desviación 23.3 -> 1.03 peso máximo 0.96 -> 0.37Sin escalar, con d = 512 el softmax le da a una sola clave casi todo el peso, aunque las claves sean puro azar. Al dividir por √d, la desviación vuelve a ser cercana a 1 para cualquier d y el peso máximo queda parecido en los tres casos.
La temperatura
Dividir los puntajes por un número antes del softmax es tan útil que tiene nombre: temperatura T.
Con T chica, las diferencias entre puntajes se agrandan y el softmax enfoca casi todo en el más grande. Con T grande, las diferencias se achican y el softmax reparte. La división por √d de la atención es una temperatura fija, T = √d. En el tema 24 vas a ver la temperatura otra vez, al elegir la siguiente palabra de un modelo de lenguaje.
palabras = ["plata", "sacó", "Ana", "del"]
s = torch.tensor([2.0, 1.0, 0.5, -1.0])   # puntajes de una fila

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8), sharey=True)
for eje, T in zip(ejes.flat, [0.25, 0.5, 1, 4]):
    p = torch.softmax(s / T, dim=0)
    print(f"T = {T}:", np.round(p.numpy(), 2))
    eje.bar(palabras, p, color="C0")
    eje.set_title(f"T = {T}")
    eje.tick_params(axis="x", labelsize=11)
for eje in ejes[:, 0]:
    eje.set_ylabel("Peso")
plt.show()
T = 0.25: [0.98 0.02 0. 0. ]
T = 0.5: [0.84 0.11 0.04 0. ]
T = 1: [0.61 0.22 0.14 0.03]
T = 4: [0.34 0.27 0.23 0.16]
El orden de las palabras nunca cambia: «plata» siempre recibe más que «sacó». La temperatura solo decide qué tan concentrada está la atención. Es el deslizador de la actividad.
La atención en PyTorch
Esta es toda la atención, en una función que sirve para cualquier forma de lote. Lleva un argumento más, la máscara, que explicamos en un momento: marca con True las casillas que no se pueden mirar.
def atencion(Q, K, V, mascara=None):
    """Atención de producto punto escalada.

    Q: (..., Lq, d)   K: (..., Lk, d)   V: (..., Lk, dv)
    mascara: True donde NO se puede mirar (o None).
    Devuelve la salida (..., Lq, dv) y los pesos (..., Lq, Lk).
    """
    d = Q.shape[-1]
    puntajes = Q @ K.transpose(-2, -1) / math.sqrt(d)
    if mascara is not None:
        # -inf: después del softmax, peso exactamente 0
        puntajes = puntajes.masked_fill(mascara, float("-inf"))
    pesos = torch.softmax(puntajes, dim=-1)
    return pesos @ V, pesos

salida_f, pesos_f = atencion(Q, K, V)
print("Igual que a mano:", torch.allclose(salida_f, salida))

# Un lote de 4 frases, 2 «cabezas», 10 palabras, vectores de 8
q = torch.randn(4, 2, 10, 8)
salida_lote, pesos_lote = atencion(q, q, q)
print("Salida:", salida_lote.shape, "  Pesos:", pesos_lote.shape)
Igual que a mano: True
Salida: torch.Size([4, 2, 10, 8]) Pesos: torch.Size([4, 2, 10, 10])K.transpose(-2, -1) traspone solo las dos últimas dimensiones, así que la misma línea funciona para una frase o para un lote de frases con varias cabezas: las dimensiones de adelante se recorren solas (es el broadcasting del tema 3).
Autoatención con varias cabezas
¿De dónde salen Q, K y V? En la autoatención salen de la misma frase. Cada palabra llega con su vector x (su embedding, de largo dmodelo), y tres capas lineales lo convierten en su consulta, su clave y su valor:
Las matrices WQ, WK y WV se aprenden. Así una misma palabra puede buscar una cosa (su consulta) y ofrecer otra (su clave): «banco» puede buscar palabras de dinero o de lugar, mientras ofrece «soy un sustantivo».
Una sola atención solo puede mirar con un criterio a la vez. Por eso se usan varias cabezas: el vector de cada palabra se corta en, por ejemplo, 4 pedazos, y cada pedazo hace su propia atención, con sus propias consultas y claves. Una cabeza puede aprender a mirar el sujeto del verbo; otra, la palabra anterior; otra, el sustantivo al que se refiere un artículo. Al final los pedazos se vuelven a pegar y una última capa lineal los mezcla. Como cada cabeza trabaja con vectores más cortos, el costo total es parecido al de una sola cabeza grande.
class AtencionMulticabeza(nn.Module):
    def __init__(self, d_modelo, cabezas):
        super().__init__()
        assert d_modelo % cabezas == 0, "d_modelo debe dividirse"
        self.cabezas = cabezas
        # Una sola capa calcula Q, K y V juntos: 3 · d_modelo salidas
        self.qkv = nn.Linear(d_modelo, 3 * d_modelo)
        self.salida = nn.Linear(d_modelo, d_modelo)

    def forward(self, x, mascara=None):
        B, L, D = x.shape                 # lote, largo, d_modelo
        q, k, v = self.qkv(x).chunk(3, dim=-1)

        def separar(t):
            # (B, L, D) -> (B, cabezas, L, D / cabezas)
            t = t.view(B, L, self.cabezas, D // self.cabezas)
            return t.transpose(1, 2)

        o, self.pesos = atencion(separar(q), separar(k), separar(v),
                                 mascara)
        # Pegar de nuevo las cabezas: (B, L, D)
        o = o.transpose(1, 2).reshape(B, L, D)
        return self.salida(o)


torch.manual_seed(0)
capa = AtencionMulticabeza(d_modelo=16, cabezas=4)
x = torch.randn(2, 5, 16)                 # 2 frases de 5 palabras
print("Entrada:", x.shape, "  Salida:", capa(x).shape)
print("Pesos guardados:", capa.pesos.shape)
Entrada: torch.Size([2, 5, 16]) Salida: torch.Size([2, 5, 16])
Pesos guardados: torch.Size([2, 4, 5, 5])La salida tiene la misma forma que la entrada: una fila por palabra, del mismo largo. Eso permite apilar muchas capas de atención, una encima de otra. Guardamos los pesos en self.pesos para poder dibujarlos después.
La misma cuenta que PyTorch
PyTorch trae su propia versión, nn.MultiheadAttention. Guarda las tres matrices WQ, WK, WV pegadas en in_proj_weight, en ese orden, como nuestra qkv. Si le copiamos nuestros pesos, tiene que dar exactamente lo mismo:
oficial = nn.MultiheadAttention(16, 4, batch_first=True)
with torch.no_grad():
    oficial.in_proj_weight.copy_(capa.qkv.weight)
    oficial.in_proj_bias.copy_(capa.qkv.bias)
    oficial.out_proj.weight.copy_(capa.salida.weight)
    oficial.out_proj.bias.copy_(capa.salida.bias)

nuestra = capa(x)
# Autoatención: la misma x hace de consultas, claves y valores
suya, pesos_suyos = oficial(x, x, x, average_attn_weights=False)
print("Salidas iguales:", torch.allclose(nuestra, suya, atol=1e-6))
print("Pesos iguales:  ",
      torch.allclose(capa.pesos, pesos_suyos, atol=1e-6))
Salidas iguales: True
Pesos iguales: TrueNuestras veinte líneas hacen lo mismo que la capa de PyTorch. Desde ahora puedes usar cualquiera de las dos sabiendo qué pasa por dentro. (atol=1e-6 acepta diferencias de redondeo en el sexto decimal: las dos versiones suman en distinto orden.)
La máscara causal: no mirar el futuro
Un modelo que escribe texto, palabra por palabra, no puede mirar las palabras que todavía no escribió. Al entrenarlo, sin embargo, le damos la frase entera de una vez. Para que no haga trampa se usa una máscara causal: la palabra i solo puede mirar las palabras 1 a i. En la tabla de puntajes, todo lo que está arriba de la diagonal se reemplaza por −∞ antes del softmax, y su peso queda en 0 exacto.
frase = ["Ana", "sacó", "plata", "del", "banco"]
L = len(frase)
# True arriba de la diagonal: las palabras del futuro
causal = torch.triu(torch.ones(L, L, dtype=torch.bool), diagonal=1)
print(causal.int())

torch.manual_seed(1)
q_frase = torch.randn(L, 8)
k_frase = torch.randn(L, 8)
_, pesos_causal = atencion(q_frase, k_frase, k_frase, causal)
print(pesos_causal.round(decimals=2))
tensor([[0, 1, 1, 1, 1],
[0, 0, 1, 1, 1],
[0, 0, 0, 1, 1],
[0, 0, 0, 0, 1],
[0, 0, 0, 0, 0]], dtype=torch.int32)
tensor([[1.0000, 0.0000, 0.0000, 0.0000, 0.0000],
[0.5300, 0.4700, 0.0000, 0.0000, 0.0000],
[0.1600, 0.6700, 0.1700, 0.0000, 0.0000],
[0.0400, 0.1400, 0.1000, 0.7200, 0.0000],
[0.1300, 0.1900, 0.1000, 0.0500, 0.5300]])La primera palabra solo se puede mirar a sí misma, así que su peso es 1. La última puede mirar a todas. Cada fila sigue sumando 1, porque las casillas tapadas se quedaron afuera del softmax, no se borraron después.
# Blanco para el 0 y tinta para el 1
blanco_tinta = LinearSegmentedColormap.from_list("bt", ["white", "C0"])
# Las casillas del futuro quedan en blanco, sin número
tabla = np.ma.masked_where(causal.numpy(), pesos_causal.numpy())

fig, eje = plt.subplots()
eje.imshow(tabla, cmap=blanco_tinta, vmin=0, vmax=1)
for i in range(L):
    for j in range(i + 1):
        p = pesos_causal[i, j].item()
        eje.text(j, i, f"{p:.2f}", ha="center", va="center",
                 fontsize=11, color="white" if p > 0.5 else "C0")
eje.set_xticks(range(L), frase, rotation=45, ha="right")
eje.set_yticks(range(L), frase)
eje.grid(False)                         # sin rejilla sobre la tabla
eje.set_xlabel("Palabra que se mira")
eje.set_ylabel("Palabra que mira")
eje.set_title("Pesos con máscara causal")
plt.show()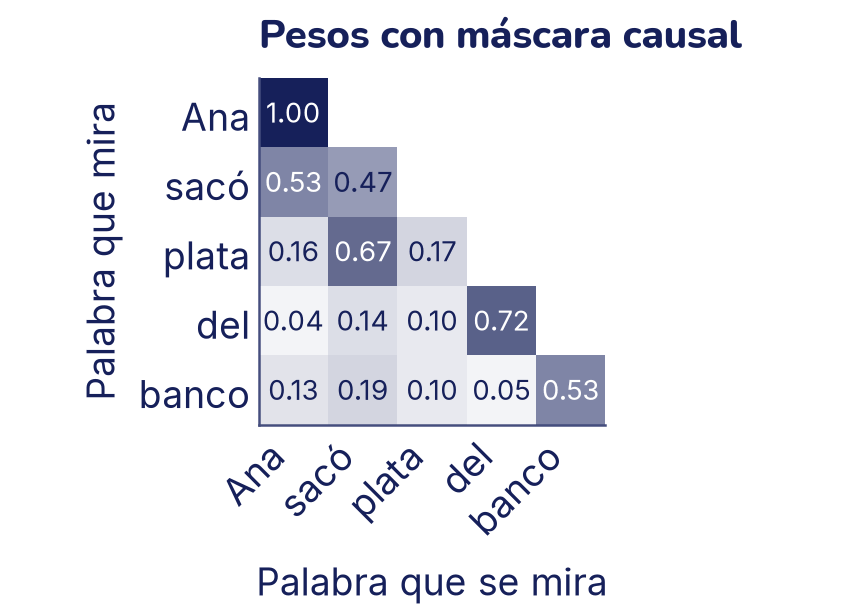
Hay otra máscara que ya conoces del tema 21: la de padding. Cuando un lote junta frases de distinto largo y las de menos palabras se rellenan con un token de relleno, nadie debe mirar esos rellenos: se tapan sus columnas con −∞, igual que acá.
¿Dónde está cada palabra?
La atención tiene una propiedad sorprendente: no sabe en qué orden vienen las palabras. Cada palabra compara su consulta con todas las claves, pero en ninguna parte aparece la posición. Si das vuelta la frase, cada palabra recibe exactamente el mismo resultado que antes, solo que en otro lugar:
torch.manual_seed(0)
x = torch.randn(1, 5, 16)
al_reves = torch.tensor([4, 3, 2, 1, 0])
y = capa(x)
y_de_la_frase_al_reves = capa(x[:, al_reves])
print("Mismo resultado, en otro orden:",
      torch.allclose(y_de_la_frase_al_reves, y[:, al_reves], atol=1e-6))
Mismo resultado, en otro orden: TruePara la atención sola, «el perro persigue al gato» y «el gato persigue al perro» son la misma bolsa de palabras. La solución es sumarle al embedding de cada palabra un vector que diga su posición. Hay dos formas:
- Aprendida: una tabla
nn.Embedding(largo_máximo, d_modelo)con un vector por posición, que se entrena como los embeddings de palabras del tema 22. Es lo que usa nuestro transformer de juguete y los ViT. - Sinusoidal: el artículo original de los transformers usó ondas de seno y coseno de distintas frecuencias, sin nada que aprender:
Es como un reloj con muchas agujas: las primeras columnas giran rápido y distinguen posiciones vecinas; las últimas giran despacio y distinguen el principio del final de un texto largo. Ninguna posición tiene el mismo vector que otra.
def posicion_sinusoidal(largo, d_modelo):
    pos = torch.arange(largo).unsqueeze(1)          # (largo, 1)
    i = torch.arange(0, d_modelo, 2)                # 0, 2, 4, ...
    frecuencia = 1 / 10000 ** (i / d_modelo)        # (d_modelo / 2,)
    pe = torch.zeros(largo, d_modelo)
    pe[:, 0::2] = torch.sin(pos * frecuencia)       # columnas pares
    pe[:, 1::2] = torch.cos(pos * frecuencia)       # columnas impares
    return pe

pe = posicion_sinusoidal(50, 32)
print(pe.shape)
print(pe[:3, :4].round(decimals=2))

plt.imshow(pe.T, cmap=blanco_tinta, aspect="auto")
plt.grid(False)
plt.colorbar(label="Valor (de −1 a 1)")
plt.xlabel("Posición en la frase")
plt.ylabel("Columna del vector")
plt.title("Codificación posicional sinusoidal")
plt.show()
torch.Size([50, 32])
tensor([[ 0.0000, 1.0000, 0.0000, 1.0000],
[ 0.8400, 0.5400, 0.5300, 0.8500],
[ 0.9100, -0.4200, 0.9000, 0.4300]])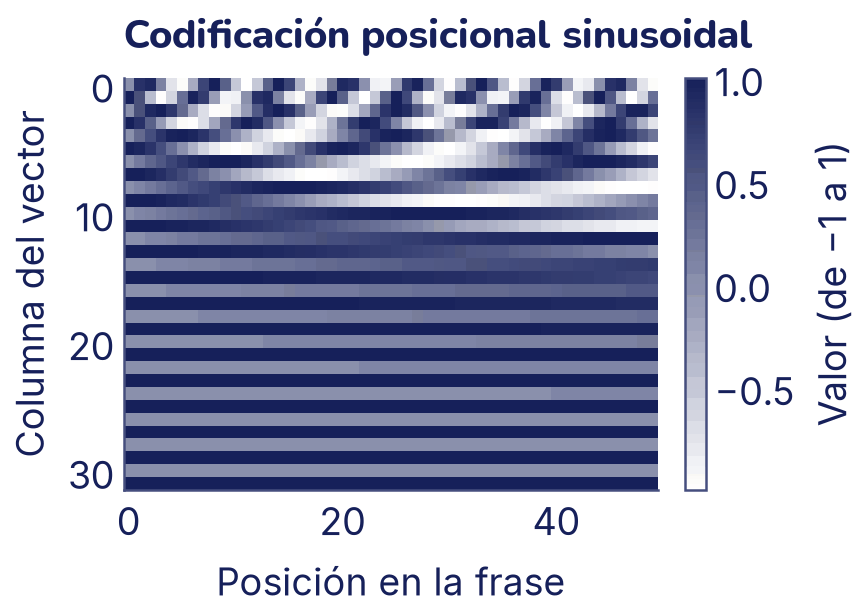
Cada columna de la figura es el vector de una posición: una especie de código de barras único. La posición 0 es (0, 1, 0, 1, …), porque sen 0 = 0 y cos 0 = 1.
El bloque transformer
La atención mezcla información entre palabras. Un transformer la combina con otras tres piezas, y las cuatro juntas forman un bloque que se repite muchas veces, uno encima de otro:
- Atención con varias cabezas: cada palabra recoge información de las demás.
- Un MLP (tema 16) que se aplica a cada palabra por separado: procesa lo que la palabra acaba de recoger. Suele tener una capa oculta 4 veces más ancha que dmodelo.
- Conexiones residuales: la salida de cada pieza se suma a su entrada, x + atención(x), en vez de reemplazarla. Cada capa solo tiene que aprender una corrección, y el gradiente tiene un camino directo hacia las primeras capas. Sin ellas, apilar decenas de bloques no entrena.
- LayerNorm: antes de cada pieza, el vector de cada palabra se normaliza para que tenga media 0 y desviación 1 (y después se escala con dos vectores aprendidos). Se parece a la normalización por lotes del tema 19, pero no promedia a través del lote sino a lo largo del vector de cada palabra: funciona igual con lotes de una sola frase y con frases de cualquier largo.
ln = nn.LayerNorm(4)
palabra = torch.tensor([[1.0, 2.0, 3.0, 4.0]])
print(ln(palabra).detach().round(decimals=2))
tensor([[-1.3400, -0.4500, 0.4500, 1.3400]])El dibujo del bloque, de abajo hacia arriba:
from matplotlib.patches import FancyBboxPatch

fig, eje = plt.subplots(figsize=(4.8, 4.8))
cajas = [  # (texto, centro y), de abajo hacia arriba
    ("Embeddings + posición", 0.5),
    ("LayerNorm", 1.6),
    ("Atención multicabeza", 2.7),
    ("LayerNorm", 4.9),
    ("MLP", 6.0),
    ("Salida: mismo tamaño", 8.2),
]
sumas = [3.8, 7.1]                      # los dos signos +
for texto, y in cajas:
    clave = texto.startswith("Atención")
    eje.add_patch(FancyBboxPatch(
        (0.8, y - 0.3), 2.8, 0.6, boxstyle="round,pad=0.05",
        facecolor="C3", edgecolor="C1" if clave else "C0",
        linewidth=2.5 if clave else 1.2))
    eje.text(2.2, y, texto, ha="center", va="center")
for y in sumas:
    eje.scatter([2.2], [y], s=700, facecolor="white", edgecolor="C0",
                zorder=3)
    eje.text(2.2, y, "+", ha="center", va="center", fontsize=18,
             zorder=4)
# Flechas del camino principal, de centro a centro
centros = sorted([y for _, y in cajas] + sumas)
for y0, y1 in zip(centros[:-1], centros[1:]):
    eje.annotate("", (2.2, y1), (2.2, y0),
                 arrowprops=dict(arrowstyle="->", color="C0",
                                 shrinkA=15, shrinkB=15))
# Los atajos residuales: la entrada de cada parte va directo al +
for y_desde, y_hasta in [(1.05, 3.8), (4.35, 7.1)]:
    eje.plot([2.2, 0.35, 0.35], [y_desde, y_desde, y_hasta],
             color="C2", linewidth=1.2)
    eje.annotate("", (2.2, y_hasta), (0.35, y_hasta),
                 arrowprops=dict(arrowstyle="->", color="C2",
                                 shrinkA=0, shrinkB=14))
    eje.text(0.15, (y_desde + y_hasta) / 2, "residual", rotation=90,
             color="C2", fontsize=12, ha="center", va="center")
eje.set_xlim(-0.1, 3.8)
eje.set_ylim(0, 8.7)
eje.axis("off")
eje.set_title("Un bloque transformer")
plt.show()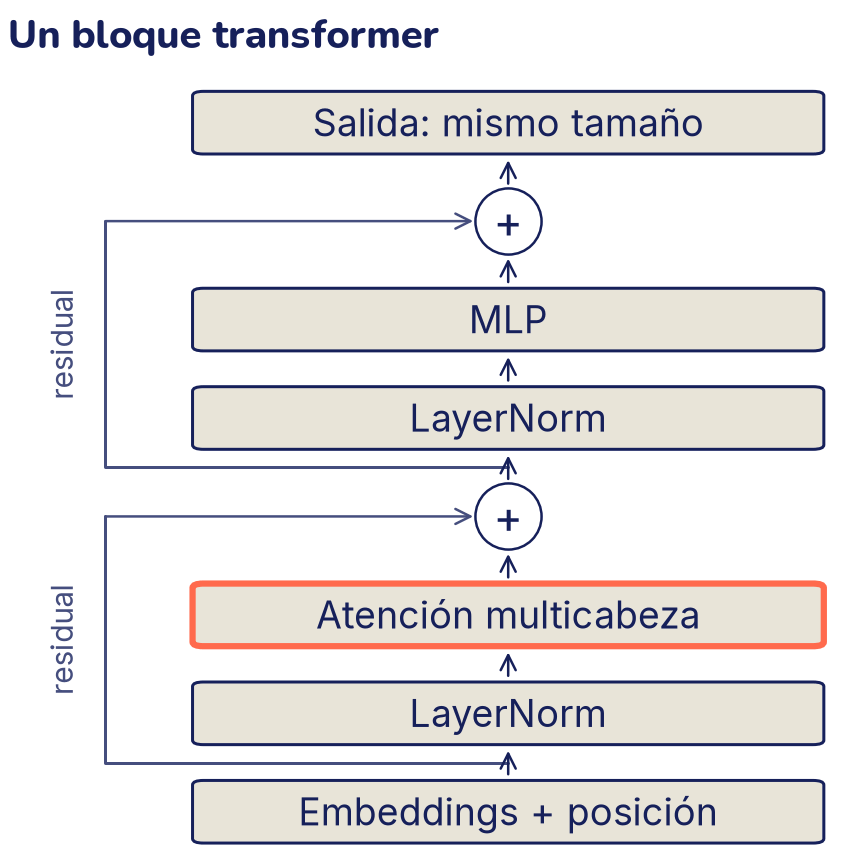
Y en código, con la atención que ya programamos. El orden «primero LayerNorm, después la pieza, después la suma» es el que usan casi todos los modelos actuales (se llama pre-norm; el artículo original normalizaba después de la suma).
class BloqueTransformer(nn.Module):
    def __init__(self, d_modelo, cabezas, d_mlp):
        super().__init__()
        self.norma1 = nn.LayerNorm(d_modelo)
        self.atencion = AtencionMulticabeza(d_modelo, cabezas)
        self.norma2 = nn.LayerNorm(d_modelo)
        self.mlp = nn.Sequential(nn.Linear(d_modelo, d_mlp), nn.ReLU(),
                                 nn.Linear(d_mlp, d_modelo))

    def forward(self, x, mascara=None):
        # Las palabras se miran entre sí, y se suma (residual)
        x = x + self.atencion(self.norma1(x), mascara)
        # Cada palabra se procesa por separado, y se suma
        x = x + self.mlp(self.norma2(x))
        return x


def contar(modelo):
    return sum(p.numel() for p in modelo.parameters())

bloque = BloqueTransformer(d_modelo=64, cabezas=4, d_mlp=256)
print("Forma:", bloque(torch.randn(2, 10, 64)).shape)
print("Parámetros del bloque:", contar(bloque))
print("  atención:", contar(bloque.atencion),
      "  MLP:", contar(bloque.mlp),
      "  LayerNorm:", contar(bloque.norma1) + contar(bloque.norma2))

# El bloque equivalente que trae PyTorch
suyo = nn.TransformerEncoderLayer(64, 4, dim_feedforward=256,
                                  dropout=0.0, batch_first=True,
                                  norm_first=True)
print("Parámetros del de PyTorch:", contar(suyo))
Forma: torch.Size([2, 10, 64])
Parámetros del bloque: 49984
atención: 16640 MLP: 33088 LayerNorm: 256
Parámetros del de PyTorch: 49984Los 49 984 parámetros salen de cuentas que puedes hacer a mano (ejercicio 4). La atención tiene 4 matrices de 64 × 64 (WQ, WK, WV y la de salida) con sus sesgos; el MLP, dos matrices de 64 × 256 con los suyos, y es la parte más grande. Fíjate en que la cantidad de parámetros no depende del largo de la frase: el mismo bloque procesa 10 palabras o 1000.
Codificador, decodificador y los dos juntos
Con bloques como este se arman tres familias de modelos. Cambia sobre todo la máscara:
| Familia | Máscara | Para qué sirve | Ejemplos |
|---|---|---|---|
| Codificador | Ninguna: cada palabra mira a todas | Entender un texto entero: clasificar, buscar, etiquetar palabras | BERT (tema 25), ViT |
| Decodificador | Causal: solo el pasado | Escribir texto palabra por palabra | GPT y los modelos de lenguaje (tema 24) |
| Codificador-decodificador | Codificador sin máscara; decodificador causal y además mira al codificador | Transformar un texto en otro: traducir, resumir | El transformer original, T5 (tema 25) |
En el codificador-decodificador aparece una variante, la atención cruzada: las consultas salen del texto que se está escribiendo y las claves y valores, del texto de entrada. Es la misma función atencion, con Q de un lado y K y V del otro.
El costo cuadrático
La atención tiene un precio: la tabla de pesos tiene una casilla por cada par de palabras. Con L palabras son L² números, por cada cabeza y cada bloque.
for L_texto in [100, 1_000, 10_000, 100_000]:
    casillas = L_texto ** 2
    # 4 bytes por número (float32)
    print(f"{L_texto:>7,} palabras: {casillas:>15,} pesos "
          f"= {casillas * 4 / 1e6:>9,.2f} MB por cabeza")
100 palabras: 10,000 pesos = 0.04 MB por cabeza
1,000 palabras: 1,000,000 pesos = 4.00 MB por cabeza
10,000 palabras: 100,000,000 pesos = 400.00 MB por cabeza
100,000 palabras: 10,000,000,000 pesos = 40,000.00 MB por cabezaDiez veces más palabras significan cien veces más cuentas y memoria. Por eso los modelos tienen un largo máximo de contexto, y por eso hay tanta investigación en atenciones más baratas.
Un transformer de juguete: invertir dígitos
Ahora juntemos todo y entrenemos un transformer de verdad. La tarea: recibir 8 dígitos y devolverlos al revés. Para una persona es trivial; para una red es un buen examen, porque la respuesta en cada posición depende de otra posición. Los datos son sintéticos: secuencias de dígitos al azar.
from torch.utils.data import DataLoader, TensorDataset

LARGO, DIGITOS = 8, 10
g = torch.Generator().manual_seed(0)
X_ent = torch.randint(0, DIGITOS, (20000, LARGO), generator=g)
X_val = torch.randint(0, DIGITOS, (2000, LARGO), generator=g)
# La respuesta: la misma secuencia, al revés
Y_ent, Y_val = X_ent.flip(dims=[1]), X_val.flip(dims=[1])
print("Entrada: ", X_ent[0].tolist())
print("Objetivo:", Y_ent[0].tolist())
Entrada: [4, 9, 3, 0, 3, 9, 7, 3]
Objetivo: [3, 7, 9, 3, 0, 3, 9, 4]El modelo es un codificador: embeddings de los dígitos (una tabla nn.Embedding, como en el tema 22) más embeddings de posición aprendidos, un bloque transformer y una capa lineal que, en cada posición, da 10 logits, uno por dígito.
class TransformerJuguete(nn.Module):
    def __init__(self, d_modelo=32, cabezas=2, bloques=1,
                 con_posicion=True):
        super().__init__()
        self.fichas = nn.Embedding(DIGITOS, d_modelo)
        self.posicion = (nn.Embedding(LARGO, d_modelo)
                         if con_posicion else None)
        self.bloques = nn.ModuleList(
            [BloqueTransformer(d_modelo, cabezas, 4 * d_modelo)
             for _ in range(bloques)])
        self.norma = nn.LayerNorm(d_modelo)
        self.salida = nn.Linear(d_modelo, DIGITOS)

    def forward(self, x):                 # x: (B, L) con dígitos
        z = self.fichas(x)                # (B, L, d_modelo)
        if self.posicion is not None:
            z = z + self.posicion(torch.arange(x.shape[1],
                                               device=x.device))
        for bloque in self.bloques:
            z = bloque(z)
        return self.salida(self.norma(z))  # (B, L, 10)

torch.manual_seed(0)
modelo = TransformerJuguete()
print("Parámetros:", contar(modelo))
Parámetros: 13674Para entrenar no sirve tal cual la función entrenar del tema 18: cuenta una respuesta por ejemplo, y aquí cada ejemplo tiene ocho (un dígito por posición). Escribimos un bucle corto con los mismos pasos de siempre. El único detalle nuevo es que nn.CrossEntropyLoss quiere las clases en la dimensión 1, así que los logits pasan de (B, L, 10) a (B, 10, L) con transpose.
def exactitud(modelo, X, Y):
    """Fracción de dígitos y de secuencias enteras acertados."""
    modelo.eval()
    with torch.no_grad():
        pred = modelo(X.to(device)).argmax(dim=-1).cpu()
    acierto = pred == Y
    por_digito = acierto.float().mean().item()
    por_secuencia = acierto.all(dim=1).float().mean().item()
    return por_digito, por_secuencia


def entrenar_secuencias(modelo, X, Y, X_v, Y_v, epocas, tasa=1e-3):
    cargador = DataLoader(TensorDataset(X, Y), batch_size=64,
                          shuffle=True,
                          generator=torch.Generator().manual_seed(0))
    optimizador = torch.optim.Adam(modelo.parameters(), lr=tasa)
    funcion_perdida = nn.CrossEntropyLoss()
    modelo.to(device)
    for epoca in range(1, epocas + 1):
        modelo.train()
        suma = 0.0
        for x, y in cargador:
            x, y = x.to(device), y.to(device)
            optimizador.zero_grad()
            logits = modelo(x)                         # (B, L, 10)
            perdida = funcion_perdida(logits.transpose(1, 2), y)
            perdida.backward()
            optimizador.step()
            suma += perdida.item() * len(y)
        digitos, secuencias = exactitud(modelo, X_v, Y_v)
        # Exactitud de validación: por dígito y por secuencia entera
        print(f"Época {epoca}: pérdida {suma / len(X):.3f}   "
              f"dígitos {digitos:.1%}   secuencias {secuencias:.1%}")


entrenar_secuencias(modelo, X_ent, Y_ent, X_val, Y_val, epocas=2)
Época 1: pérdida 0.599 dígitos 100.0% secuencias 100.0%
Época 2: pérdida 0.006 dígitos 100.0% secuencias 100.0%Después de una sola época, unos segundos de CPU, el modelo ya invierte el 100 % de las 2000 secuencias de validación, que nunca vio. (Las exactitudes de cada época se miden con esas secuencias de validación.) Miremos cómo lo hace: los pesos de atención de una de sus dos cabezas para una secuencia de validación.
ejemplo = X_val[:1].to(device)
modelo.eval()
with torch.no_grad():
    pred = modelo(ejemplo).argmax(dim=-1)
print("Entrada:   ", ejemplo[0].tolist())
print("Predicción:", pred[0].tolist())

# Los pesos de la cabeza 0 que guardó la última pasada
mapa = modelo.bloques[0].atencion.pesos[0, 0].cpu()
fig, eje = plt.subplots()
eje.imshow(mapa, cmap=blanco_tinta, vmin=0, vmax=1)
eje.grid(False)
entrada = ejemplo[0].tolist()
eje.set_xticks(range(LARGO),
               [f"{d}\n{i}" for i, d in enumerate(entrada)])
eje.set_yticks(range(LARGO),
               [f"{i}: {d}" for i, d in enumerate(pred[0].tolist())])
eje.set_xlabel("Posición que se mira (dígito y posición)")
eje.set_ylabel("Posición que escribe")
eje.set_title("¿A dónde mira cada posición?")
plt.show()
Entrada: [8, 3, 3, 9, 6, 9, 4, 0]
Predicción: [0, 4, 9, 6, 9, 3, 3, 8]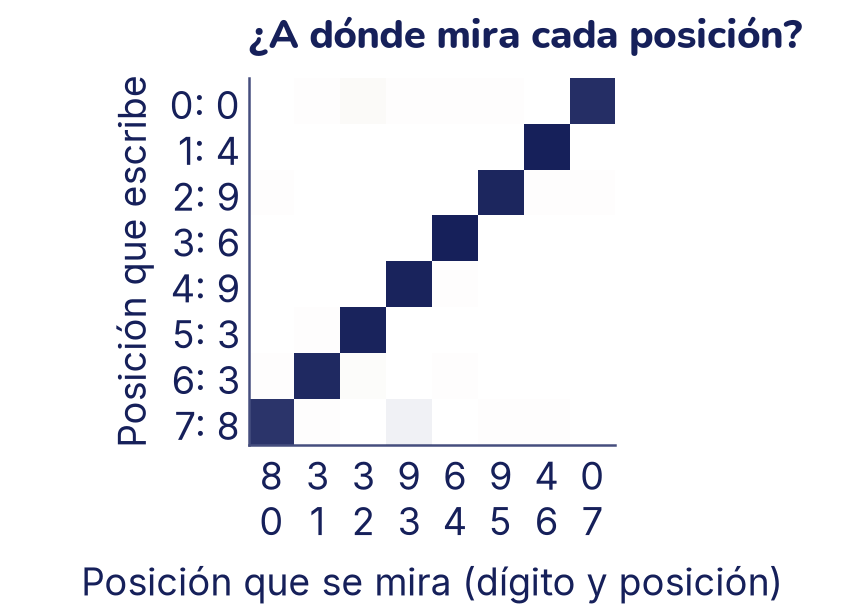
Nadie le dijo al modelo «la posición 0 tiene que mirar a la 7». Lo descubrió solo, con el descenso de gradiente: la diagonal invertida es exactamente la regla de la tarea. Cada posición pone casi todo su peso en la posición espejo y copia su dígito a través del valor.
¿Qué pasa si quitamos los embeddings de posición? Según lo que vimos antes, la atención no sabe el orden, así que no debería poder invertir nada:
torch.manual_seed(0)
sin_posicion = TransformerJuguete(con_posicion=False)
entrenar_secuencias(sin_posicion, X_ent, Y_ent, X_val, Y_val,
                    epocas=2)
Época 1: pérdida 1.867 dígitos 32.1% secuencias 0.1%
Época 2: pérdida 1.680 dígitos 31.8% secuencias 0.0%Sin posición, cada lugar de la salida «ve» la misma bolsa de dígitos y solo distingue el dígito que tiene en su propio lugar. Lo mejor que puede hacer es apostar por dígitos que se repiten en la secuencia: así acierta cerca de un tercio de los dígitos, pero casi ninguna secuencia entera. La posición no es un detalle: es lo que convierte una bolsa de palabras en una frase.
Imágenes como frases: los parches
Un transformer recibe una secuencia de vectores; no le importa si vienen de palabras. El Vision Transformer (ViT) aprovecha eso: corta la imagen en parches cuadrados, aplana cada parche en un vector y trata la lista de parches como una frase. Probemos con la foto del templo que usaste en los temas 3 y 20. Para que los parches se vean grandes en la figura, nos quedamos con uno de cada cuatro píxeles y recortamos 96 × 160 píxeles: salen 6 × 10 = 60 parches de 16 × 16.
tensor.unfold(dim, tamaño, paso) corta una dimensión en ventanas: aplicado al alto y después al ancho, con tamaño y paso 16, da todos los parches sin un solo bucle.
from sklearn.datasets import load_sample_image

foto = load_sample_image("china.jpg")[::4, ::4][:96, :160]
imagen = torch.tensor(foto).permute(2, 0, 1) / 255   # (3, 96, 160)
P = 16                                               # lado del parche
cortes = imagen.unfold(1, P, P).unfold(2, P, P)
print("Después de unfold:", cortes.shape)   # (C, filas, columnas, P, P)
# Una fila por parche, con sus 3 · 16 · 16 números aplanados
parches = cortes.permute(1, 2, 0, 3, 4).reshape(-1, 3 * P * P)
print("Secuencia de parches:", parches.shape)

# El parche 11 es fila 1, columna 1: píxeles 16 a 31 en las dos
igual = torch.equal(parches[11].view(3, P, P),
                    imagen[:, 16:32, 16:32])
print("El parche 11 es el recorte correcto:", igual)

filas, columnas = cortes.shape[1], cortes.shape[2]
fig, eje = plt.subplots()
eje.imshow(foto)
for k in range(filas * columnas):
    f, c = divmod(k, columnas)
    eje.text(c * P + P / 2, f * P + P / 2, str(k), ha="center",
             va="center", fontsize=9, color="white",
             bbox=dict(boxstyle="round,pad=0.15", facecolor="C0",
                       edgecolor="none"))
for f in range(filas + 1):
    eje.axhline(f * P - 0.5, color="white", linewidth=1)
for c in range(columnas + 1):
    eje.axvline(c * P - 0.5, color="white", linewidth=1)
eje.axis("off")
eje.set_title("60 parches de 16 × 16 píxeles")
plt.show()
Después de unfold: torch.Size([3, 6, 10, 16, 16])
Secuencia de parches: torch.Size([60, 768])
El parche 11 es el recorte correcto: True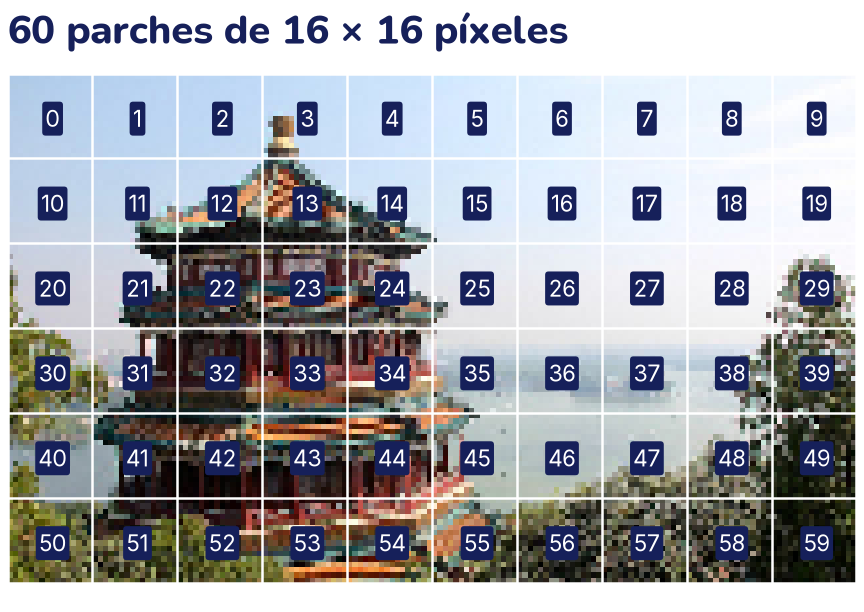
Cada parche es ahora un vector de 768 números, como una palabra lo era en su embedding. El resto es lo que ya sabes: una capa lineal los lleva a dmodelo, se suman embeddings de posición aprendidos (sin ellos, el modelo vería un rompecabezas desarmado) y se pasan por bloques transformer. Un ViT agrega además al principio un vector especial, el token [CLS]: no viene de ningún parche, mira a todos y, al final, su vector resume la imagen para clasificarla.
torch.manual_seed(0)
d_vit = 64
proyeccion = nn.Linear(3 * P * P, d_vit)
cls = nn.Parameter(torch.zeros(1, 1, d_vit))
pos_vit = nn.Parameter(torch.zeros(1, 1 + len(parches), d_vit))

fichas_img = proyeccion(parches.unsqueeze(0))       # (1, 60, 64)
fichas_img = torch.cat([cls, fichas_img], dim=1)    # (1, 61, 64)
z = BloqueTransformer(d_vit, 4, 4 * d_vit)(fichas_img + pos_vit)
print("Tokens de la imagen:", fichas_img.shape)
print("Después del bloque: ", z.shape)
print("Resumen ([CLS]):    ", z[:, 0].shape)
Tokens de la imagen: torch.Size([1, 61, 64])
Después del bloque: torch.Size([1, 61, 64])
Resumen ([CLS]): torch.Size([1, 64])Es exactamente el mismo bloque que usamos para los dígitos. Un ViT real usa fotos de 224 × 224 (196 parches), una docena de bloques y millones de imágenes para entrenarse; en el tema 26 vas a usar uno ya entrenado.
Lo que aprendiste y lo que sigue
- La atención es una búsqueda suave: cada palabra compara su consulta con las claves de todas, convierte los parecidos en pesos con un softmax y se lleva el promedio ponderado de los valores: softmax(QKᵀ/√d)·V.
- Dividir por √d evita que el softmax se sature cuando los vectores son largos. La temperatura decide si la atención se concentra o se reparte.
- En la autoatención, Q, K y V salen de la misma frase con tres capas lineales aprendidas. Con varias cabezas, cada una puede mirar con un criterio distinto. Nuestra versión da lo mismo que
nn.MultiheadAttention. - La máscara causal tapa el futuro con −∞ antes del softmax; la de padding tapa los rellenos.
- La atención no sabe el orden: hay que sumar una codificación posicional, aprendida o sinusoidal. Sin ella, el transformer de juguete no puede invertir los dígitos.
- Un bloque transformer es atención y MLP, cada uno con LayerNorm antes y una suma residual después. Los codificadores, los decodificadores y los codificadores-decodificadores se arman con estos bloques.
- La atención cuesta L² por cabeza: por eso los modelos tienen un largo máximo de contexto.
- Un ViT corta la imagen en parches, los trata como palabras y agrega un token [CLS] para resumir.
En el tema 24 vas a usar un decodificador con máscara causal para generar texto, desde un modelo que predice la siguiente letra hasta un LLM pequeño. En el 25, a reutilizar codificadores ya entrenados como BERT.