Antes de empezar
Varios ejercicios usan las funciones y clases de la teoría: atencion, AtencionMulticabeza, BloqueTransformer, contar, TransformerJuguete, exactitud, entrenar_secuencias y blanco_tinta, además de LARGO y DIGITOS. Abre un cuaderno nuevo en Colab, pega y ejecuta en orden los bloques de la ficha Código y después trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta.
Ejercicios
1. Atención a mano
Tres palabras con vectores de dimensión d = 2:
- consultas: q1 = (1, 1), q2 = (0, 1), q3 = (1, 0);
- claves: k1 = (1, 1), k2 = (1, −1), k3 = (0, 0);
- valores: v1 = (1, 0), v2 = (0, 1), v3 = (0, 0).
Calcula a mano (con calculadora para las exponenciales) los puntajes, los pesos y la salida de la primera palabra. Después calcula las tres filas con la función atencion y comprueba.
Respuesta
Los productos punto de q1 con las claves son 1 + 1 = 2, 1 − 1 = 0 y 0. Divididos por √2 ≈ 1,414: 1,41, 0 y 0. Las exponenciales son e1,41 ≈ 4,11, 1 y 1, que suman 6,11. Los pesos son 4,11/6,11 ≈ 0,67, 1/6,11 ≈ 0,16 y 0,16. La salida es 0,67·(1, 0) + 0,16·(0, 1) + 0,16·(0, 0) = (0,67; 0,16).
Q1 = torch.tensor([[1.0, 1.0], [0.0, 1.0], [1.0, 0.0]])
K1 = torch.tensor([[1.0, 1.0], [1.0, -1.0], [0.0, 0.0]])
V1 = torch.tensor([[1.0, 0.0], [0.0, 1.0], [0.0, 0.0]])
salida1, pesos1 = atencion(Q1, K1, V1)
print("Pesos:\n", pesos1.round(decimals=2))
print("Salida:\n", salida1.round(decimals=2))
Pesos:
tensor([[0.6700, 0.1600, 0.1600],
[0.5800, 0.1400, 0.2800],
[0.4000, 0.4000, 0.2000]])
Salida:
tensor([[0.6700, 0.1600],
[0.5800, 0.1400],
[0.4000, 0.4000]])La primera fila coincide con la cuenta a mano. La segunda palabra mira sobre todo a la 1 y muy poco a la 2, porque su consulta (0, 1) apunta al revés que la segunda coordenada de k2. La tercera reparte por igual entre la 1 y la 2 (0,40 cada una): su consulta (1, 0) se parece lo mismo a las dos claves.
2. Consultas, claves y valores en la vida diaria
Buscas un video en una plataforma escribiendo «cómo hacer api morado». Di qué hace de consulta, qué de claves y qué de valores. ¿En qué se diferencia esa búsqueda de la atención?
Respuesta
- Consulta: lo que escribiste.
- Claves: los títulos y descripciones de los videos, que se comparan con tu consulta.
- Valores: los videos mismos, lo que te llevas.
La plataforma te muestra una lista ordenada y tú eliges uno. La atención no elige: devuelve una mezcla de todos los valores, con más peso para los que más se parecen. Además, en la autoatención cada palabra es a la vez buscador (su consulta) y video (su clave y su valor).
3. Puntajes multiplicados
Toma los puntajes s = torch.tensor([2.0, 1.0, 0.5, -1.0]) de la teoría. Sin calcular, predice qué pasa con los pesos si multiplicas todos los puntajes por 10, y si los multiplicas por 0. ¿Qué temperatura equivale a cada caso? Después compruébalo.
Respuesta
Multiplicar por 10 es lo mismo que una temperatura T = 0,1: casi todo el peso va al puntaje más grande. Multiplicar por 0 es como una temperatura infinita: todos los puntajes quedan en 0 y el softmax reparte por igual, 1/4 para cada uno.
print("× 10:", torch.softmax(s * 10, dim=0).round(decimals=3).tolist())
print("× 0: ", torch.softmax(s * 0, dim=0).tolist())
× 10: [1.0, 0.0, 0.0, 0.0]
× 0: [0.25, 0.25, 0.25, 0.25]Por eso la atención sin escalar se vuelve «dura» con vectores largos (sus puntajes son grandes, como multiplicarlos por un número grande) y por eso, si todas las claves fueran iguales, cada palabra haría un promedio simple de toda la frase.
4. Contar los parámetros de un bloque
Un bloque transformer tiene dmodelo = 128, 8 cabezas y un MLP con dmlp = 512. Cuenta a mano sus parámetros: la atención (cuatro matrices de d × d con sus sesgos), el MLP (dos capas lineales con sus sesgos) y los dos LayerNorm (cada uno tiene un vector de escala y uno de desplazamiento, de largo d). ¿Cambia el total si usas 2 cabezas en lugar de 8? Compruébalo con contar.
Respuesta
- Atención: 4 · 128 · 128 + 4 · 128 = 65 536 + 512 = 66 048.
- MLP: 128 · 512 + 512 + 512 · 128 + 128 = 131 712.
- LayerNorm: 2 · (128 + 128) = 512.
- Total: 198 272.
El número de cabezas no cambia nada: las cabezas solo cortan en pedazos los mismos vectores de Q, K y V; no agregan matrices.
for n_cabezas in [8, 2]:
    b = BloqueTransformer(d_modelo=128, cabezas=n_cabezas, d_mlp=512)
    print(f"{n_cabezas} cabezas: {contar(b):,} parámetros")
8 cabezas: 198,272 parámetros
2 cabezas: 198,272 parámetrosEl MLP tiene el doble de parámetros que la atención. En los modelos de lenguaje grandes pasa lo mismo: la mayor parte de los parámetros está en los MLP.
5. Encuentra el error: una máscara mal aplicada
Un compañero escribió esta atención causal. Los pesos le salen raros. Ejecútala, mira las filas y encuentra los dos errores.
def atencion_causal_mala(Q, K, V):
    L = Q.shape[-2]
    puntajes = Q @ K.transpose(-2, -1) / math.sqrt(Q.shape[-1])
    pesos = torch.softmax(puntajes, dim=-1)
    # Tapar el futuro
    futuro = torch.triu(torch.ones(L, L, dtype=torch.bool), diagonal=0)
    pesos = pesos.masked_fill(futuro, 0.0)
    return pesos @ V, pesos

torch.manual_seed(1)
q4 = torch.randn(4, 8)
_, malos = atencion_causal_mala(q4, q4, q4)
print(malos.round(decimals=2))
print("Suma de cada fila:", malos.sum(dim=-1).round(decimals=2))
tensor([[0.0000, 0.0000, 0.0000, 0.0000],
[0.1200, 0.0000, 0.0000, 0.0000],
[0.1600, 0.1400, 0.0000, 0.0000],
[0.1100, 0.0300, 0.0100, 0.0000]])
Suma de cada fila: tensor([0.0000, 0.1200, 0.3000, 0.1500])Respuesta
- La máscara se aplica después del softmax. Al poner ceros en los pesos ya calculados, las filas dejan de sumar 1: la atención pierde peso en lugar de repartirlo entre las palabras permitidas. Hay que tapar los puntajes con −∞ antes del softmax.
diagonal=0también tapa la diagonal. Así cada palabra no puede mirarse a sí misma, y la primera palabra no puede mirar a nadie: su fila queda toda en cero. Con la máscara bien puesta (antes del softmax) ese error daría una fila de puros −∞ y un softmax denan. Lo correcto esdiagonal=1.
La versión correcta es la función atencion de la teoría con la máscara causal:
causal4 = torch.triu(torch.ones(4, 4, dtype=torch.bool), diagonal=1)
_, buenos = atencion(q4, q4, q4, causal4)
print(buenos.round(decimals=2))
print("Suma de cada fila:", buenos.sum(dim=-1).round(decimals=2))
tensor([[1.0000, 0.0000, 0.0000, 0.0000],
[0.1600, 0.8400, 0.0000, 0.0000],
[0.1700, 0.1500, 0.6800, 0.0000],
[0.1100, 0.0300, 0.0100, 0.8500]])
Suma de cada fila: tensor([1., 1., 1., 1.])6. ¿Necesita posición?
Sin entrenar nada, decide para cada tarea si un transformer sin codificación posicional podría resolverla, y explica por qué:
- Decir si en una secuencia de dígitos aparece el 7.
- Invertir la secuencia.
- Ordenar la secuencia de menor a mayor.
- Copiar la secuencia tal cual.
Respuesta
Sin posición, la atención trata la entrada como una bolsa: cada lugar de la salida sabe qué dígitos hay en total y cuál es el suyo, pero no dónde está cada uno.
- Sí. «¿Hay un 7?» depende solo de qué dígitos hay, no de su orden.
- No. La posición 0 tiene que escribir el dígito de la posición 7, pero no sabe que ella es la 0 ni cuál es la 7. Es lo que viste en la teoría: sin posición no acierta casi ninguna secuencia entera.
- No. La bolsa sí alcanza para saber cuál sería la secuencia ordenada, pero cada lugar de la salida no sabe en qué lugar está, así que no sabe qué elemento de la lista ordenada le toca escribir.
- Sí. Cada lugar copia su propio dígito, que lo tiene gracias a la conexión residual; no necesita saber dónde está.
7. El costo de un texto largo
Un modelo de lenguaje procesa 4096 tokens con 32 bloques de 32 cabezas cada uno, y guarda cada peso de atención en 2 bytes (float16). ¿Cuánta memoria ocuparían todas las tablas de pesos a la vez? ¿Y con el doble de tokens?
Respuesta
Cada tabla tiene 4096² casillas de 2 bytes; hay 32 · 32 = 1024 tablas.
for tokens in [4096, 8192]:
    memoria = tokens ** 2 * 2 * 32 * 32          # bytes
    print(f"{tokens} tokens: {memoria / 1e9:.1f} GB")
4096 tokens: 34.4 GB
8192 tokens: 137.4 GBDuplicar los tokens cuadruplica la memoria. En la práctica los modelos no guardan todas las tablas a la vez: calculan la atención por pedazos, justamente para no pagar este costo.
8. Parches de un ViT de verdad
El ViT más conocido recibe imágenes de 224 × 224 con 3 canales y parches de 16 × 16. ¿Cuántos parches salen? ¿Cuántos números tiene cada parche aplanado? ¿Cuántos tokens recibe el transformer si se agrega el [CLS]? Si la imagen fuera de 384 × 384, ¿cuántas veces más grande sería cada tabla de atención? Compruébalo con unfold sobre una imagen de ceros.
Respuesta
224 / 16 = 14 parches por lado: 14 · 14 = 196 parches, de 3 · 16 · 16 = 768 números, más el [CLS]: 197 tokens. Con 384 × 384 salen 24 · 24 = 576 parches; la tabla de atención crece con el cuadrado: (577 / 197)² ≈ 8,6 veces.
for lado in [224, 384]:
    img = torch.zeros(3, lado, lado)
    p = img.unfold(1, 16, 16).unfold(2, 16, 16)
    p = p.permute(1, 2, 0, 3, 4).reshape(-1, 3 * 16 * 16)
    print(f"{lado} × {lado}: {p.shape[0]} parches de {p.shape[1]}"
          f" números, {p.shape[0] + 1} tokens con [CLS]")
print(f"La tabla crece {(577 / 197) ** 2:.1f} veces")
224 × 224: 196 parches de 768 números, 197 tokens con [CLS]
384 × 384: 576 parches de 768 números, 577 tokens con [CLS]
La tabla crece 8.6 vecesMini-proyecto: un transformer que ordena
Invertir era fácil: cada posición siempre mira al mismo lugar. Ordenar es más difícil, porque a dónde hay que mirar depende de los dígitos. Entrena el transformer de juguete para ordenar 8 dígitos de menor a mayor y muestra los mapas de atención que aprendió.
- Arma los datos con
X_ent.sort(dim=1).valuescomo objetivo (y lo mismo para validación). - Entrena un
TransformerJuguetecon 2 bloques durante 6 épocas. Anota la exactitud por dígito y por secuencia. - Dibuja en una rejilla de 2 × 2 los mapas de las dos cabezas de los dos bloques para una secuencia de validación.
- Describe con tus palabras qué hace cada mapa. ¿Alguno se parece al de invertir? ¿En cuál se ve que el modelo «busca» un dígito concreto?
- Prueba con un solo bloque. ¿Alcanza?
Una solución
Y_ord_ent = X_ent.sort(dim=1).values
Y_ord_val = X_val.sort(dim=1).values

torch.manual_seed(0)
ordenador = TransformerJuguete(bloques=2)
entrenar_secuencias(ordenador, X_ent, Y_ord_ent, X_val, Y_ord_val,
                    epocas=6)

ejemplo = X_val[:1].to(device)
ordenador.eval()
with torch.no_grad():
    pred = ordenador(ejemplo).argmax(dim=-1)
print("Entrada:   ", ejemplo[0].tolist())
print("Predicción:", pred[0].tolist())

entrada = ejemplo[0].tolist()
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for b in range(2):
    pesos_b = ordenador.bloques[b].atencion.pesos[0].cpu()
    for c in range(2):
        eje = ejes[b, c]
        eje.imshow(pesos_b[c], cmap=blanco_tinta, vmin=0, vmax=1)
        eje.grid(False)
        eje.set_title(f"Bloque {b + 1}, cabeza {c + 1}", fontsize=12)
        eje.set_xticks(range(LARGO), entrada, fontsize=10)
        eje.set_yticks(range(LARGO), pred[0].tolist(), fontsize=10)
for eje in ejes[1]:
    eje.set_xlabel("Dígito mirado")
for eje in ejes[:, 0]:
    eje.set_ylabel("Dígito escrito")
plt.show()
Época 1: pérdida 0.704 dígitos 99.6% secuencias 97.1%
Época 2: pérdida 0.025 dígitos 99.9% secuencias 99.6%
Época 3: pérdida 0.007 dígitos 99.9% secuencias 99.7%
Época 4: pérdida 0.025 dígitos 99.2% secuencias 93.9%
Época 5: pérdida 0.003 dígitos 100.0% secuencias 99.9%
Época 6: pérdida 0.001 dígitos 100.0% secuencias 99.9%
Entrada: [8, 3, 3, 9, 6, 9, 4, 0]
Predicción: [0, 3, 3, 4, 6, 8, 9, 9]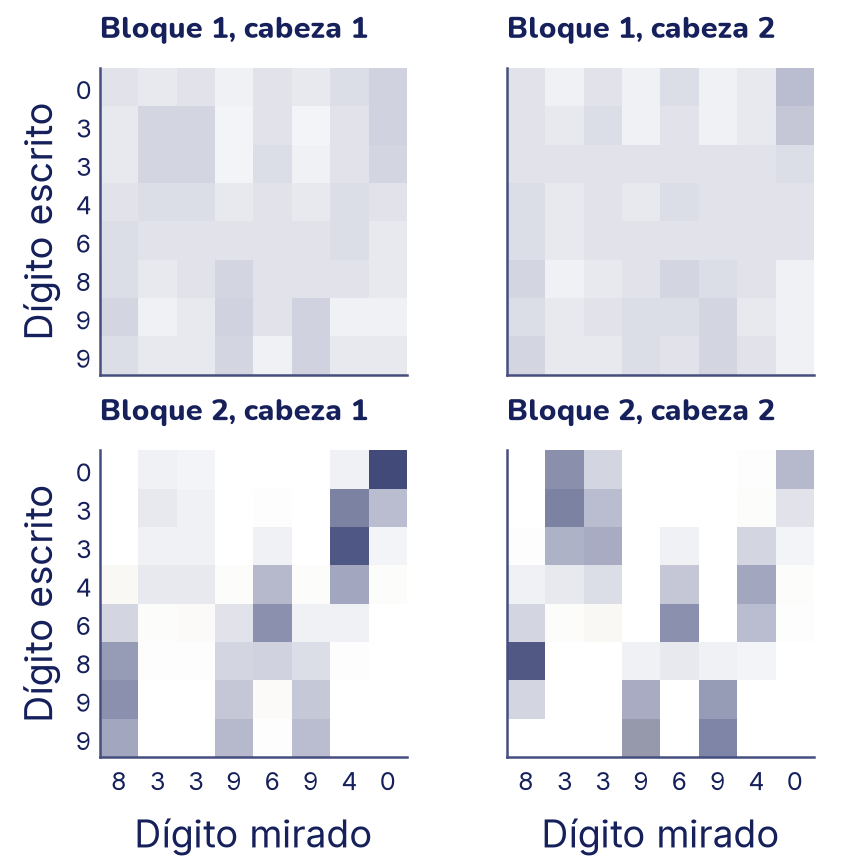
- Con 2 bloques el modelo ordena el 99,9 % de las secuencias de validación en 6 épocas. En la época 4 la exactitud bajó y en la 5 se recuperó: un paso de Adam algo grande puede dar un tropezón pasajero; por eso conviene mirar todas las épocas y no solo la última.
- El primer bloque reparte la atención por toda la secuencia: recoge información de todos los dígitos (cuántos hay de cada uno, más o menos). El segundo es más nítido: las primeras posiciones de la salida miran a los dígitos chicos de la entrada y las últimas, a los grandes. Ahí el modelo «busca» el dígito que le toca escribir: en este ejemplo, la fila que escribe el 8 mira al 8 de la entrada y las que escriben 9 miran a los dos 9. A diferencia de invertir, el lugar que se mira cambia con cada secuencia.
- Con un solo bloque (cambia
bloques=1) también se puede probar; mide la exactitud por secuencia y compárala. Los mapas exactos cambian con la semilla, pero el reparto en el primer bloque y la búsqueda en el segundo suelen repetirse.
Errores comunes
- Olvidar dividir por √d. Con vectores largos, el softmax se satura, los gradientes se apagan y el entrenamiento se estanca.
- Hacer el softmax en la dimensión equivocada. Los pesos de cada palabra (cada fila) tienen que sumar 1:
softmax(dim=-1). - Aplicar la máscara después del softmax, o con 0 en lugar de −∞. Las filas dejan de sumar 1. La máscara va sobre los puntajes, antes del softmax.
- Tapar la diagonal con
triu(..., diagonal=0): la primera palabra queda sin nadie a quien mirar y aparecennan. - Olvidar la codificación posicional. El modelo trata la frase como una bolsa de palabras y no puede aprender nada que dependa del orden.
- Confundir las formas.
nn.MultiheadAttentionespera (L, B, D) salvo que le pasesbatch_first=True;nn.CrossEntropyLossquiere las clases en la dimensión 1, así que los logits (B, L, clases) van contranspose(1, 2). - Usar la función
entrenardel tema 18 sin pensar cuando cada ejemplo tiene varias respuestas: su exactitud cuenta una por ejemplo y daría números sin sentido. - Creer que más cabezas son más parámetros. Las cabezas reparten los mismos vectores; lo que suma parámetros es dmodelo y el ancho del MLP.
- Leer los mapas de atención como una explicación completa. Muestran a dónde mira cada cabeza, pero el resultado también depende de los valores, del MLP y de los demás bloques.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Calcular a mano y en código la atención de producto punto escalada (ejercicios 1 y 3).
- Explicar consultas, claves y valores con una analogía y con matrices (ejercicio 2).
- Programar la atención con varias cabezas, la codificación posicional y un bloque transformer en PyTorch, y contar sus parámetros (ejercicio 4 y mini-proyecto).
- Explicar la máscara causal y la diferencia entre codificador y decodificador (ejercicio 5).
- Explicar por qué un transformer necesita la posición (ejercicio 6) y cuánto cuesta la atención con textos largos (ejercicio 7).
- Explicar cómo un Vision Transformer convierte una imagen en parches y los trata como tokens (ejercicio 8).