Antes de empezar
Varios ejercicios usan lo que se definió en la teoría: la clase Valor, gradiente_numerico, Neurona, Capa, MLP, modelo (la red ya entrenada), X_lunas, y_signo, perdida_y_exactitud y cargar. Abre un cuaderno nuevo en Colab, pega y ejecuta en orden los bloques de la ficha Código y después trabaja debajo. Haz primero las cuentas a mano y recién después abre la respuesta: el objetivo es que el recorrido hacia atrás te salga solo.
Ejercicios
1. Backpropagation a mano
Para cada expresión, dibuja el grafo, calcula hacia adelante el valor de cada caja y después, hacia atrás, el gradiente de cada entrada. Comprueba al final con la clase Valor.
a) f = (x + y) · z, con x = 1, y = 2 y z = −3.
b) f = x · y + x, con x = 3 e y = −2.
c) f = tanh(w · x + b), con w = 0,5, x = 2 y b = −1. Es una neurona con una sola entrada.
Respuesta
a) Hacia adelante: q = x + y = 3 y f = q · z = −9. Hacia atrás: la multiplicación pasa la otra entrada, así que ∂f/∂z = q = 3 y ∂f/∂q = z = −3. La suma copia ese −3 a sus dos entradas: ∂f/∂x = ∂f/∂y = −3.
b) Hacia adelante: p = x · y = −6 y f = p + x = −3. Hacia atrás: la suma copia 1 a p y 1 a x. La multiplicación le pasa a x el valor de y (−2) y a y el valor de x (3). La x recibe por dos caminos y los aportes se suman: ∂f/∂x = −2 + 1 = −1, y ∂f/∂y = 3.
c) Hacia adelante: z = 0,5 · 2 − 1 = 0 y f = tanh(0) = 0. Hacia atrás: el gradiente local de tanh es 1 − tanh² = 1 − 0 = 1, así que a z le llega 1. La suma lo copia: ∂f/∂b = 1. La multiplicación pasa la otra entrada: ∂f/∂w = x = 2 y ∂f/∂x = w = 0,5.
x, y, z = Valor(1.0), Valor(2.0), Valor(-3.0)
f = (x + y) * z
f.retropropagar()
print("a)", f.dato, " grads:", x.grad, y.grad, z.grad)

x, y = Valor(3.0), Valor(-2.0)
f = x * y + x
f.retropropagar()
print("b)", f.dato, " grads:", x.grad, y.grad)

w, x, b = Valor(0.5), Valor(2.0), Valor(-1.0)
f = (w * x + b).tanh()
f.retropropagar()
print("c)", f.dato, " grads:", w.grad, x.grad, b.grad)
a) -9.0 grads: -3.0 -3.0 3.0
b) -3.0 grads: -1.0 3.0
c) 0.0 grads: 2.0 0.5 1.02. Predecir con el gradiente
En el grafo de la teoría, L = (a·b + c)² con a = 2, b = −3 y c = 10, el gradiente de c es 8.
a) Sin calcular L de nuevo, ¿cuánto esperas que cambie L si c sube de 10 a 10,1?
b) Calcula el cambio real. ¿Por qué no coincide exactamente?
c) ¿Y si c sube de 10 a 13?
Respuesta
a) El gradiente dice cuánto cambia L por cada unidad que sube c, cuando el cambio es chico: 8 · 0,1 = 0,8.
b) y c) Con c = 10,1, e = 4,1 y L = 16,81: el cambio real es 0,81, casi lo predicho. Con c = 13, la predicción sería 8 · 3 = 24, pero el cambio real es 33.
for nuevo_c in [10.1, 13.0]:
    cambio = calcular_L(2.0, -3.0, nuevo_c) - calcular_L(2.0, -3.0, 10.0)
    prediccion = 8 * (nuevo_c - 10)
    print(f"c = {nuevo_c}:  cambio real = {cambio:.4f}"
          f"   predicho por el gradiente = {prediccion:.4f}")
c = 10.1: cambio real = 0.8100 predicho por el gradiente = 0.8000
c = 13.0: cambio real = 33.0000 predicho por el gradiente = 24.0000El gradiente es la pendiente en el punto donde estamos, como la recta tangente del tema 5. Para pasos chicos la predicción es muy buena; para pasos grandes, la curva ya se apartó de la tangente. Por eso el descenso de gradiente da pasos pequeños y vuelve a calcular el gradiente en cada uno.
3. Enseñarle al motor exp y la división
Agrega a la clase Valor:
a) un método exp() que calcule ex y su regla local (la derivada de ex es ex);
b) la división x / y. Pista: x / y = x · y−1, y la potencia ya sabe derivarse.
Después arma con ellas la sigmoide, σ(x) = 1 / (1 + e−x), y comprueba en x = 0,5 que el gradiente del motor coincide con la fórmula σ(x)·(1 − σ(x)) y con la derivada numérica. Verifica también la división con x = 3 e y = 2.
Respuesta
En un cuaderno se puede agregar un método a una clase ya creada asignándolo como atributo de la clase. (En tu propio archivo, lo natural es escribirlos dentro de la clase.) Para que funcione 1 / x, donde el número va primero, hace falta también __rtruediv__, igual que __radd__ con la suma.
def exp_valor(self):
    e = math.exp(self.dato)
    salida = Valor(e, (self,), "exp")
    def _atras():
        # La derivada de e^x es e^x
        self.grad += e * salida.grad
    salida._atras = _atras
    return salida

def dividir(self, otro):              # x / y = x · y^(-1)
    otro = otro if isinstance(otro, Valor) else Valor(otro)
    return self * otro ** -1

def dividir_al_reves(self, otro):     # 1 / x, con el número primero
    return Valor(otro) * self ** -1

Valor.exp = exp_valor
Valor.__truediv__ = dividir
Valor.__rtruediv__ = dividir_al_reves

def sigmoide_valor(x):
    return 1 / (1 + (-x).exp())

x = Valor(0.5)
s = sigmoide_valor(x)
s.retropropagar()
print(f"sigmoide(0.5) = {s.dato:.6f}")
print(f"autograd: {x.grad:.6f}   fórmula: {s.dato * (1 - s.dato):.6f}"
      f"   numérico: {gradiente_numerico(sigmoide_valor, [0.5])[0]:.6f}")

x, y = Valor(3.0), Valor(2.0)
(x / y).retropropagar()
print("x / y:  autograd", [x.grad, y.grad],
      "  numérico", [round(g, 6) for g in
                     gradiente_numerico(lambda u, v: u / v, [3.0, 2.0])])
sigmoide(0.5) = 0.622459
autograd: 0.235004 fórmula: 0.235004 numérico: 0.235004
x / y: autograd [0.5, -0.75] numérico [0.5, -0.75]Los tres cálculos coinciden. Para x / y, las derivadas son 1/y = 0,5 y −x/y² = −0,75, y salen solas de la multiplicación y la potencia, sin escribir ninguna regla nueva.
4. Un = donde iba +=
Alguien copió la multiplicación del motor y escribió = en lugar de +=. Corre este código: la derivada de x·x es 2x, que en x = 3 vale 6. ¿Qué da? Explica por qué y di en qué expresiones el error no se notaría.
class ValorConError(Valor):
    def __mul__(self, otro):
        otro = otro if isinstance(otro, Valor) else ValorConError(otro)
        salida = ValorConError(self.dato * otro.dato, (self, otro), "*")
        def _atras():
            self.grad = otro.dato * salida.grad    # = en lugar de +=
            otro.grad = self.dato * salida.grad
        salida._atras = _atras
        return salida

x = ValorConError(3.0)
f = x * x
f.retropropagar()
print("df/dx =", x.grad)
df/dx = 3.0Respuesta
Da 3, la mitad de lo correcto. En x * x, self y otro son el mismo objeto: la x entra a la multiplicación por dos caminos. La primera línea de _atras pone x.grad = 3 y la segunda lo reemplaza por 3 otra vez, en lugar de sumar los dos aportes (3 + 3 = 6).
El error no se nota cuando cada número se usa una sola vez en todo el grafo, como en a·b + c. Por eso es peligroso: las pruebas sencillas pasan y el error aparece recién en una red, donde cada entrada y cada peso se usan muchas veces. La verificación numérica lo habría atrapado enseguida:
print("numérico:", round(gradiente_numerico(lambda v: v * v, [3.0])[0], 4))numérico: 6.0(El mismo problema, con otra cara, es olvidarse de poner los gradientes en cero antes de cada paso: ahí el += suma lo de la época anterior.)
5. Verificar un gradiente de la red
a) Calcula con retropropagar() el gradiente de la pérdida de la red entrenada (modelo) respecto de su primer parámetro, modelo.parametros()[0], y compáralo con la derivada numérica centrada, moviendo ese parámetro ±10⁻⁶.
b) ¿Cuántas veces habría que calcular la pérdida para obtener con la derivada numérica los gradientes de todos los parámetros? ¿Y con backpropagation?
Respuesta
p = modelo.parametros()[0]

# Autograd: gradientes en cero, adelante y atrás
for q in modelo.parametros():
    q.grad = 0.0
perdida, _ = perdida_y_exactitud(modelo, X_lunas, y_signo)
perdida.retropropagar()

# Numérico: mover solo ese parámetro y volver a medir
h = 1e-6
original = p.dato
p.dato = original + h
L_mas = perdida_y_exactitud(modelo, X_lunas, y_signo)[0].dato
p.dato = original - h
L_menos = perdida_y_exactitud(modelo, X_lunas, y_signo)[0].dato
p.dato = original                     # dejarlo como estaba

print(f"autograd: {p.grad:.6e}"
      f"   numérico: {(L_mas - L_menos) / (2 * h):.6e}")
print("Cálculos de la pérdida con la derivada numérica:",
      2 * len(modelo.parametros()))
autograd: 5.941202e-04 numérico: 5.941202e-04
Cálculos de la pérdida con la derivada numérica: 66b) La derivada numérica necesita dos cálculos de la pérdida por parámetro: 66 para esta red de 33. Backpropagation da los 33 gradientes con un cálculo hacia adelante y uno hacia atrás, que cuesta más o menos lo mismo que otro hacia adelante. Con un millón de parámetros, la diferencia es de dos millones de cálculos contra dos.
6. Las formas de una capa densa
Una capa densa recibe un lote de 32 ejemplos con 10 entradas cada uno y tiene 5 neuronas: Z = X W + b. Escribe la forma (shape) de X, W, b, Z, y de los gradientes ∂L/∂W, ∂L/∂b y ∂L/∂X. Compruébalo con NumPy usando las fórmulas de la teoría.
Respuesta
X es (32, 10), W es (10, 5), b es (5,) y Z es (32, 5). Cada gradiente tiene la forma de lo que deriva: ∂L/∂W es (10, 5), ∂L/∂b es (5,) y ∂L/∂X es (32, 10). El gradiente que llega, G, tiene la forma de Z.
X_lote = np.ones((32, 10))
W_lote = np.ones((10, 5))
G = np.ones((32, 5))                  # el gradiente que llega a Z
print("dW:", (X_lote.T @ G).shape)
print("db:", G.sum(axis=0).shape)
print("dX:", (G @ W_lote.T).shape)
dW: (10, 5)
db: (5,)
dX: (32, 10)7. ¿Cuánto gradiente llega?
Una red tiene 30 capas y, en el camino hacia atrás, cada capa multiplica el gradiente por un gradiente local de alrededor de 0,5.
a) ¿Qué fracción del gradiente de la salida llega a la primera capa?
b) ¿Y si cada gradiente local fuera 1,2?
c) ¿Qué problema tiene cada caso para el descenso de gradiente?
Respuesta
print(f"0,5 en 30 capas: {0.5 ** 30:.1e}")
print(f"1,2 en 30 capas: {1.2 ** 30:.1f}")
0,5 en 30 capas: 9.3e-10
1,2 en 30 capas: 237.4a) Menos de una milmillonésima: el gradiente se desvanece. Los pesos de las primeras capas casi no se mueven y esas capas casi no aprenden.
b) Unas 237 veces el gradiente de la salida: el gradiente explota. Un paso con una tasa de aprendizaje normal es enorme para esas capas y la pérdida puede diverger, como con una tasa demasiado alta en el tema 6.
c) En los dos casos, una sola tasa de aprendizaje no sirve para todas las capas a la vez. Por eso importan las activaciones como ReLU, una buena inicialización de los pesos y la normalización (tema 19).
Mini-proyecto: tu propio dataset
Entrena el motor en un dataset 2D distinto de las lunas y grafica la frontera que aprende.
- Elige o arma los datos:
make_circlesde scikit-learn (un círculo dentro de otro),make_blobs, o tus propios puntos escritos a mano en una lista. Usa pocos puntos (30 o 40): el motor es lento. - Pasa las clases a −1 y +1.
- Crea un
MLPconrandom.seedfija y entrénalo con el bucle de la teoría. Empieza con unas 200 o 300 épocas y una tasa de 0,5; si la pérdida sube u oscila, bájala. - Grafica la curva de pérdida y la frontera final con la cuadrícula de la teoría (ajusta los límites a tus datos).
- Prueba una red con menos neuronas ocultas (por ejemplo,
MLP([2, 2, 1])) y otra con dos capas ocultas (MLP([2, 6, 6, 1])). ¿Cuál separa mejor? ¿Cuánto más tarda la más grande?
Resultados de referencia, para comprobar los tuyos
Con make_circles: 30 puntos, una red 2-8-1 y 300 épocas.
from sklearn.datasets import make_circles

X_circ, y_circ = make_circles(n_samples=30, noise=0.08, factor=0.4,
                              random_state=1)
y_circ_signo = 2 * y_circ - 1

random.seed(1)
red = MLP([2, 8, 1])
for epoca in range(301):
    perdida, exactitud = perdida_y_exactitud(red, X_circ, y_circ_signo)
    if epoca % 100 == 0:
        print(f"Época {epoca:3d}:   pérdida = {perdida.dato:.4f}"
              f"   aciertos = {exactitud:.0%}")
    if epoca == 300:
        break
    for p in red.parametros():
        p.grad = 0.0
    perdida.retropropagar()
    for p in red.parametros():
        p.dato -= 0.5 * p.grad

xs = np.linspace(-1.4, 1.4, 25)
A, B = np.meshgrid(xs, xs)
Z = np.array([[red([u, v]).dato for u in xs] for v in xs])
plt.contourf(A, B, Z, levels=[0, 1.1], colors="C3")
plt.contour(A, B, Z, levels=[0], colors="C0", linewidths=1.5)
plt.scatter(*X_circ[y_circ == 0].T, color="C0", marker="o",
            label="Afuera")
plt.scatter(*X_circ[y_circ == 1].T, color="C1", marker="s",
            label="Adentro")
# Espacio arriba para la leyenda
plt.ylim(-1.4, 2.0)
plt.title("El mini-MLP en dos círculos")
plt.legend(loc="upper center", ncol=2)
plt.show()
Época 0: pérdida = 1.4877 aciertos = 47%
Época 100: pérdida = 0.0412 aciertos = 100%
Época 200: pérdida = 0.0135 aciertos = 100%
Época 300: pérdida = 0.0075 aciertos = 100%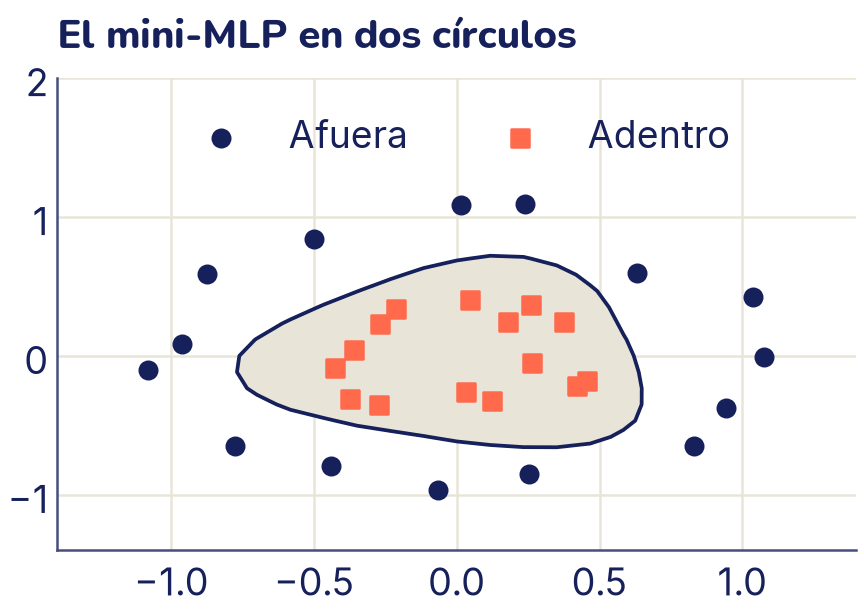
- Una sola capa oculta con 8 neuronas alcanza para encerrar el círculo de adentro: cada neurona oculta traza una recta (tema 16) y la salida las combina en una región cerrada.
- Con
MLP([2, 2, 1]), dos rectas no alcanzan para encerrar una zona: la frontera deja puntos afuera. ConMLP([2, 6, 6, 1])también acierta todos los puntos, pero cada época tarda más, porque el grafo tiene más cajas. Mídelo contime.perf_counter(), como en el tema 3.
Errores comunes
- Olvidar poner los gradientes en cero antes de cada paso. Como cada caja suma con
+=, el gradiente de la época anterior se mezcla con el nuevo y los pasos salen cada vez más grandes y en direcciones equivocadas. En PyTorch es el famosozero_grad(). - Escribir
=en lugar de+=al pasar el gradiente. El gradiente sale mal solo cuando un número se usa por varios caminos, que en una red es siempre. - Recorrer el grafo en cualquier orden. Una caja solo puede pasar su gradiente cuando ya recibió todo lo que le llega. Por eso
retropropagarusa el orden topológico. - Confundir el gradiente local con el que llega. El local solo depende de la operación de la caja (la suma: 1; la multiplicación: la otra entrada); el que llega viene de la derecha. El gradiente de la entrada es su producto.
- En la multiplicación, darle a cada entrada su propio valor. A a le toca el valor de b, y a b el de a.
- Confiar en un gradiente sin verificarlo. Un error en una regla local no produce ningún mensaje: la red simplemente aprende mal o no aprende. La derivada numérica centrada lo detecta en segundos.
- Usar la derivada numérica para entrenar. Sirve para comprobar, no para entrenar: cuesta dos cálculos de la pérdida por cada parámetro.
- Perder la forma de las matrices. Cada gradiente tiene la misma forma que lo que deriva; si XTG no da la forma de W, hay un error.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Dibujar el grafo computacional de una expresión y propagar los valores hacia adelante y los gradientes hacia atrás (la actividad y los ejercicios 1 y 2).
- Programar un mini motor de autograd con suma, multiplicación,
tanhyrelu(la claseValorde la teoría, y los ejercicios 3 y 4). - Entrenar con él un MLP pequeño (el mini-proyecto).
- Verificar gradientes con diferencias finitas (ejercicios 3 y 5).
- Escribir con matrices el paso hacia atrás de una capa densa y reconocer el desvanecimiento y la explosión de los gradientes (ejercicios 6 y 7).