La pregunta
En muchas casas, la luz de la escalera tiene dos interruptores: uno abajo y otro arriba. Puedes prenderla desde abajo y apagarla al llegar arriba. Si anotas la posición de cada interruptor (0 o 1) y si la luz está prendida, sale una tabla de cuatro filas: la luz se prende cuando los dos interruptores están en posiciones distintas. A esa regla se le llama XOR («o exclusivo»).
| Interruptor de abajo | Interruptor de arriba | ¿Luz prendida? |
|---|---|---|
| 0 | 0 | no (0) |
| 0 | 1 | sí (1) |
| 1 | 0 | sí (1) |
| 1 | 1 | no (0) |
Parece el problema de clasificación más fácil del mundo: dos entradas, cuatro ejemplos, ningún ruido. Y sin embargo, la regresión logística del tema 8 no puede aprenderlo, por más que la entrenes. Este tema explica por qué, y cómo lo resuelve una idea muy simple: poner varias neuronas juntas, en capas. Esa idea es la base de todas las redes neuronales.
En este tema vas a:
- calcular a mano la salida de una neurona artificial;
- entrenar un perceptrón con su regla y ver por qué no resuelve XOR;
- comparar las activaciones sigmoide, tanh y ReLU (forma, rango y derivada);
- escribir en NumPy el paso hacia adelante de una red de varias capas (un MLP) y predecir el
shapede cada matriz; - explicar por qué apilar capas sin activación no sirve de nada.
Necesitas lo del tema 8 (la sigmoide, la frontera de decisión y la entropía cruzada) y lo del tema 6 (pesos, sesgo y descenso de gradiente). Cómo se entrena una red de varias capas es el tema 17; aquí los pesos los vas a elegir tú.
Actividad: arma una neurona
Una neurona hace dos cosas: calcula un puntaje con dos pesos y un sesgo, como la logística, y lo pasa por una activación. En la actividad, cada celda del plano se pinta según lo que responde la neurona en ese lugar: coral si dice «1», tinta si dice «0», y más intenso cuanto más segura está. Las cuatro esquinas son los cuatro casos de la tabla de los interruptores (o de otra regla que elijas).
Arma una neurona
Este es el estado inicial: una neurona sigmoide con w₁ = 2, w₂ = 2 y b = −1, frente a la regla Y. Con JavaScript activado puedes mover los pesos, cambiar la activación y armar una red para XOR.
Las conexiones más gruesas son pesos más grandes; las punteadas, pesos negativos. En el plano, la recta continua es donde z = 0 para la oculta 1, y la punteada, para la oculta 2.La recta es donde z = 0.
- (0, 0)
- 0,27 bien
- (0, 1)
- 0,73 mal
- (1, 0)
- 0,73 mal
- (1, 1)
- 0,95 bien
Esquinas bien: 2 de 4
Coral donde la neurona dice 1 (su salida llega a 0,5, o a 0 con tanh) y tinta donde dice 0; más intenso cuanto más lejos del punto medio. Los cuadrados son las esquinas que deberían dar 1 y los círculos, las que deberían dar 0. Un anillo marca cada esquina mal coloreada.
La neurona de salida siempre usa la sigmoide, para dar una probabilidad.
Prueba esto, en orden:
- Con la regla Y (la luz se prende solo si los dos interruptores están en 1), mueve el sesgo b hasta colorear bien las cuatro esquinas. ¿Qué hace b con la recta?
- Cambia a la regla O y vuelve a acertar las cuatro. ¿Qué cambiaste?
- Cambia a la regla XOR. Intenta todo lo que quieras con w₁, w₂, b y las cuatro activaciones. ¿Cuántas esquinas logras acertar como máximo?
- Pasa al modo Red para XOR. Ahora hay dos neuronas ocultas, cada una con su recta, y una neurona de salida que combina lo que dicen. Busca pesos que coloreen bien las cuatro esquinas. Si te rindes, pulsa «Mostrar una solución» y mira qué recta traza cada neurona oculta.
La idea de todo el tema está en ese último paso: cada neurona oculta traza una recta y la salida combina sus respuestas. Con una recta no se puede separar XOR; con dos, sí.
Una neurona
Una neurona artificial recibe varias entradas x₁, x₂, …, multiplica cada una por su peso, suma un sesgo y pasa el resultado por una función llamada activación f:
z es la suma ponderada (el puntaje del tema 8) y a es la salida de la neurona. Si la activación es la sigmoide, una neurona es exactamente una regresión logística: misma fórmula, mismo dibujo, otro nombre. El nombre viene de una analogía vieja y bastante libre con las neuronas del cerebro, que reciben señales de otras y «se disparan» si la suma pasa de un umbral; no te la tomes al pie de la letra.
La activación más antigua es el escalón: da 1 si z es mayor o igual que 0, y 0 si no. Calculemos a mano una neurona con dos entradas, x = (2, −1), pesos w = (0,5; 1,5) y sesgo b = 0,25:
Como z es negativo, el escalón da 0. La sigmoide da un número un poco menor que 0,5. En Python, la suma ponderada es un producto punto (tema 3):
import numpy as np
import matplotlib.pyplot as plt

def escalon(z):
    """1 si z >= 0, y 0 si no."""
    return np.where(z >= 0, 1, 0)

def sigmoide(z):
    """La del tema 8: aplasta cualquier número a un valor entre 0 y 1."""
    return 1 / (1 + np.exp(-z))

def neurona(x, w, b, activacion):
    """Suma ponderada más sesgo, pasada por una activación."""
    z = np.dot(w, x) + b
    return activacion(z)

x = np.array([2.0, -1.0])     # dos entradas
w = np.array([0.5, 1.5])      # un peso por entrada
b = 0.25                      # el sesgo

print("z =", np.dot(w, x) + b)
print("Con escalón: ", neurona(x, w, b, escalon))
print("Con sigmoide:", neurona(x, w, b, sigmoide).round(3))
z = -0.25
Con escalón: 0
Con sigmoide: 0.438Igual que en el tema 8, los puntos donde z = 0 forman una recta en el plano (x₁, x₂). De un lado de la recta la neurona dice 1 y del otro, 0. Los pesos inclinan la recta y el sesgo la corre sin girarla: es lo que viste en la actividad.
El perceptrón
El perceptrón (Frank Rosenblatt, 1958) es una neurona con activación escalón y una regla para aprender sus pesos. La regla es casi de sentido común. Se recorren los ejemplos uno por uno:
- si la neurona acierta, no se cambia nada;
- si dice 0 y era 1, se suma a los pesos un poquito de la entrada, para que z suba la próxima vez;
- si dice 1 y era 0, se resta, para que z baje.
Las tres cosas caben en una fórmula, con ŷ la predicción, y la clase real y η (eta) la tasa de aprendizaje:
Si acierta, y − ŷ vale 0 y nada cambia; si no, vale +1 o −1. Una pasada completa por todos los ejemplos se llama época. Probémoslo con dos grupos de puntos sintéticos que una recta puede separar:
rng = np.random.default_rng(42)

# 50 puntos alrededor de cada centro (datos sintéticos)
X_sep = np.vstack([rng.normal([-1, -1], 0.6, size=(50, 2)),
                   rng.normal([1.2, 1.0], 0.6, size=(50, 2))])
y_sep = np.array([0] * 50 + [1] * 50)
orden = rng.permutation(100)          # mezclamos las dos clases
X_sep, y_sep = X_sep[orden], y_sep[orden]

def entrenar_perceptron(X, y, epocas=15, tasa=0.1):
    """La regla del perceptrón. Devuelve w, b y los errores por época."""
    w = np.zeros(X.shape[1])
    b = 0.0
    errores = []
    for epoca in range(epocas):
        fallos = 0
        for xi, yi in zip(X, y):
            pred = escalon(np.dot(w, xi) + b)
            # Si acierta, yi - pred vale 0 y nada cambia
            w = w + tasa * (yi - pred) * xi
            b = b + tasa * (yi - pred)
            fallos += int(pred != yi)
        errores.append(fallos)
    return w, b, errores

w_sep, b_sep, errores_sep = entrenar_perceptron(X_sep, y_sep)
print("Errores en cada época:", errores_sep)
print("w =", w_sep.round(3), "  b =", round(b_sep, 3))
Errores en cada época: [2, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
w = [0.175 0.141] b = 0.0Desde la segunda época ya no se equivoca con ningún punto, y desde ahí la regla no cambia nada más. Rosenblatt demostró que esto no es suerte: si existe una recta que separa las dos clases, el perceptrón la encuentra en un número finito de pasos. A unos datos así se les dice linealmente separables.
XOR: el problema que una recta no resuelve
Ahora hagamos lo mismo con XOR. Para tener más que cuatro puntos, ponemos 100 puntos sintéticos alrededor de las cuatro esquinas, cada uno con la clase de su esquina:
esquinas = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
clase_xor = np.array([0, 1, 1, 0])    # 1 si los interruptores difieren

cual = rng.integers(0, 4, size=100)   # a qué esquina va cada punto
X_xor = esquinas[cual] + rng.normal(0, 0.15, size=(100, 2))
y_xor = clase_xor[cual]

w_x, b_x, errores_xor = entrenar_perceptron(X_xor, y_xor)
print("Errores en cada época:", errores_xor)
Errores en cada época: [47, 52, 57, 48, 50, 47, 52, 57, 51, 48, 52, 57, 48, 45, 53]Los errores nunca llegan a cero: cada vez que la regla arregla un punto, desarregla otros, y la recta da vueltas sin rumbo. Con 100 puntos, equivocarse en unos 50 es lo mismo que adivinar con una moneda. Miremos las dos situaciones. Las regiones se pintan como en el tema 8: clasificamos cada punto de una cuadrícula fina.
def dibujar_clases(X, y, ax=None, s=30):
    """Clase 0: círculos de color C0. Clase 1: cuadrados de color C1."""
    ax = ax or plt.gca()
    ax.scatter(X[y == 0, 0], X[y == 0, 1], s=s, color="C0",
               marker="o", label="Clase 0")
    ax.scatter(X[y == 1, 0], X[y == 1, 1], s=s, color="C1",
               marker="s", label="Clase 1")

def regiones(ax, predecir, x_lim, y_lim):
    """Pinta de C0 o C1, muy claro, la clase que predice cada lugar."""
    A, B = np.meshgrid(np.linspace(*x_lim, 200), np.linspace(*y_lim, 200))
    zona = predecir(np.column_stack([A.ravel(), B.ravel()]))
    ax.contourf(A, B, zona.reshape(A.shape), levels=[-0.5, 0.5, 1.5],
                colors=["C0", "C1"], alpha=0.2)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
casos = [(X_sep, y_sep, w_sep, b_sep, errores_sep, (-3, 3.2),
          "Separables"),
         (X_xor, y_xor, w_x, b_x, errores_xor, (-0.6, 1.6), "XOR")]
for col, (X_c, y_c, w_c, b_c, err, lim, nombre) in enumerate(casos):
    arriba, abajo = ejes[0, col], ejes[1, col]
    regiones(arriba, lambda P: escalon(P @ w_c + b_c), lim, lim)
    dibujar_clases(X_c, y_c, ax=arriba, s=8)
    arriba.set_title(nombre)
    abajo.plot(range(1, 16), err, color="C0", marker="o", markersize=4)
    abajo.set_ylim(-3, 60)
    abajo.set_xlabel("Época")
ejes[1, 0].set_ylabel("Errores")
plt.show()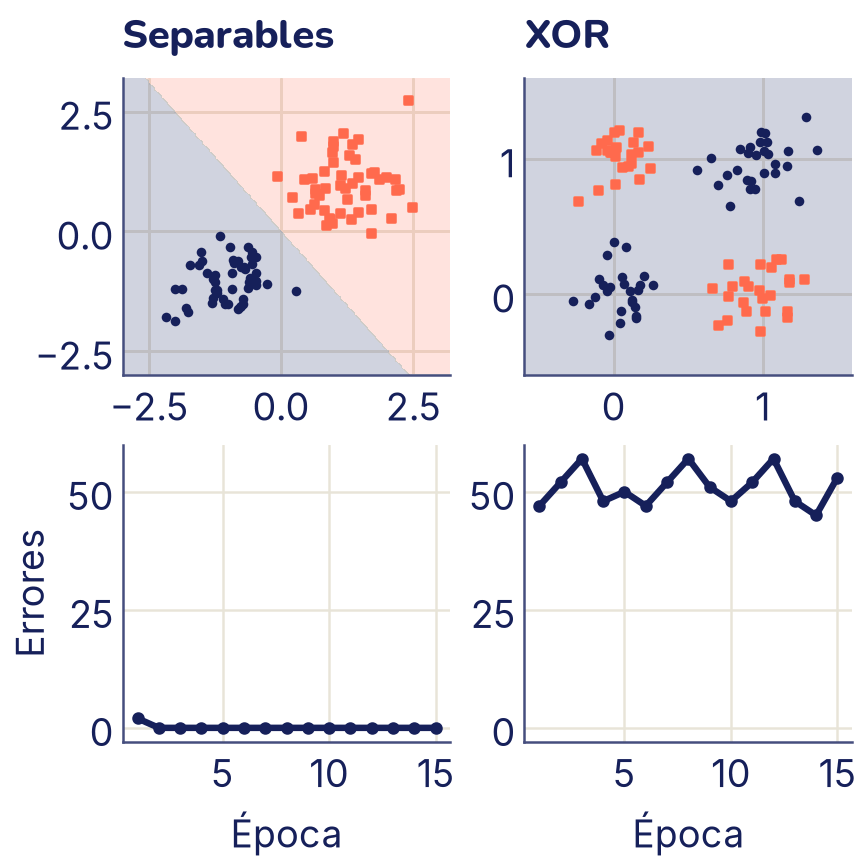
¿Por qué ninguna recta sirve para XOR? En la figura de arriba a la derecha, la última recta que probó el perceptrón ni siquiera cruza los datos: todo el recuadro quedó del lado de la clase 0. Pero no es culpa de la regla. Los círculos están en dos esquinas opuestas, (0, 0) y (1, 1), y los cuadrados en las otras dos. Cualquier recta que deje los dos círculos de un lado deja también, de ese lado, al menos un cuadrado. También se puede ver con números. Para que una neurona escalón acierte XOR haría falta:
- en (0, 0), decir 0: b menor que 0;
- en (0, 1) y en (1, 0), decir 1: w₂ + b ≥ 0 y w₁ + b ≥ 0;
- en (1, 1), decir 0: w₁ + w₂ + b menor que 0.
Sumando las dos del medio, w₁ + w₂ + 2b ≥ 0. Pero la primera y la última dicen que b y w₁ + w₂ + b son negativos, y su suma, que es la misma w₁ + w₂ + 2b, también tendría que ser negativa. Es una contradicción: ningún perceptrón resuelve XOR. Lo mismo vale para la logística y para cualquier modelo cuya frontera sea una recta. En 1969, Marvin Minsky y Seymour Papert publicaron este tipo de límites en un libro que enfrió por años el entusiasmo por las neuronas artificiales. La salida, como viste en la actividad, es usar más de una neurona.
Funciones de activación
Antes de armar redes, conozcamos las activaciones que se usan hoy. El escalón tiene un problema serio: su derivada es 0 en todas partes (salvo en el salto, donde no existe). Como el descenso de gradiente del tema 6 necesita derivadas que digan hacia dónde mover los pesos, con el escalón no hay pista. Por eso las redes usan activaciones suaves:
- Sigmoide, σ(z), la del tema 8: va de 0 a 1.
- Tangente hiperbólica, tanh(z): la misma forma de S, pero de −1 a 1 y centrada en 0.
- ReLU (rectified linear unit): ReLU(z) = máx(0, z). Deja pasar los positivos tal cual y cambia los negativos por 0. Es la más usada en redes modernas.
Sus derivadas, que en el tema 17 serán protagonistas, salen así (la de la ReLU es más simple todavía: vale 1 si z es positivo y 0 si es negativo):
def tanh(z):
    return np.tanh(z)

def relu(z):
    """Los positivos pasan igual; los negativos se vuelven 0."""
    return np.maximum(0, z)

def d_sigmoide(z):
    return sigmoide(z) * (1 - sigmoide(z))

def d_tanh(z):
    return 1 - np.tanh(z) ** 2

def d_relu(z):
    # En z = 0 la derivada no existe; por convención se usa 0
    return np.where(z > 0, 1.0, 0.0)

activaciones = [("sigmoide", sigmoide, d_sigmoide),
                ("tanh", tanh, d_tanh),
                ("ReLU", relu, d_relu)]
for nombre, f, df in activaciones:
    print(f"{nombre:8s} f(-5) = {f(-5.0):5.2f}  f(0) = {f(0.0):.2f}"
          f"  f(5) = {f(5.0):.2f}  f'(0) = {df(0.0):.2f}"
          f"  f'(5) = {df(5.0):.4f}")
sigmoide f(-5) = 0.01 f(0) = 0.50 f(5) = 0.99 f'(0) = 0.25 f'(5) = 0.0066
tanh f(-5) = -1.00 f(0) = 0.00 f(5) = 1.00 f'(0) = 1.00 f'(5) = 0.0002
ReLU f(-5) = 0.00 f(0) = 0.00 f(5) = 5.00 f'(0) = 0.00 f'(5) = 1.0000zs = np.linspace(-5, 5, 400)
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
for eje, (nombre, f, df) in zip(ejes.flat, activaciones):
eje.plot(zs, f(zs), color="C0", label="f(z)")
eje.plot(zs, df(zs), color="C2", linestyle="--", label="derivada")
eje.set_title(nombre)
eje.set_ylim(-1.2, 2.2)
ejes[0, 0].scatter([0], [0.25], color="C1", s=60, zorder=3)
ejes[0, 0].legend(loc="upper left", fontsize=10)
# La derivada de la sigmoide vale como mucho 0,25: tras n capas,
# el gradiente puede quedar multiplicado por 0,25 ** n
capas = np.arange(1, 11)
ejes[1, 1].semilogy(capas, 0.25 ** capas, color="C0", marker="o",
markersize=4)
ejes[1, 1].set_title("0,25 elevado a n")
ejes[1, 1].set_xlabel("Capas n")
plt.show()
print(f"0.25 ** 10 = {0.25 ** 10:.1e}")0.25 ** 10 = 9.5e-07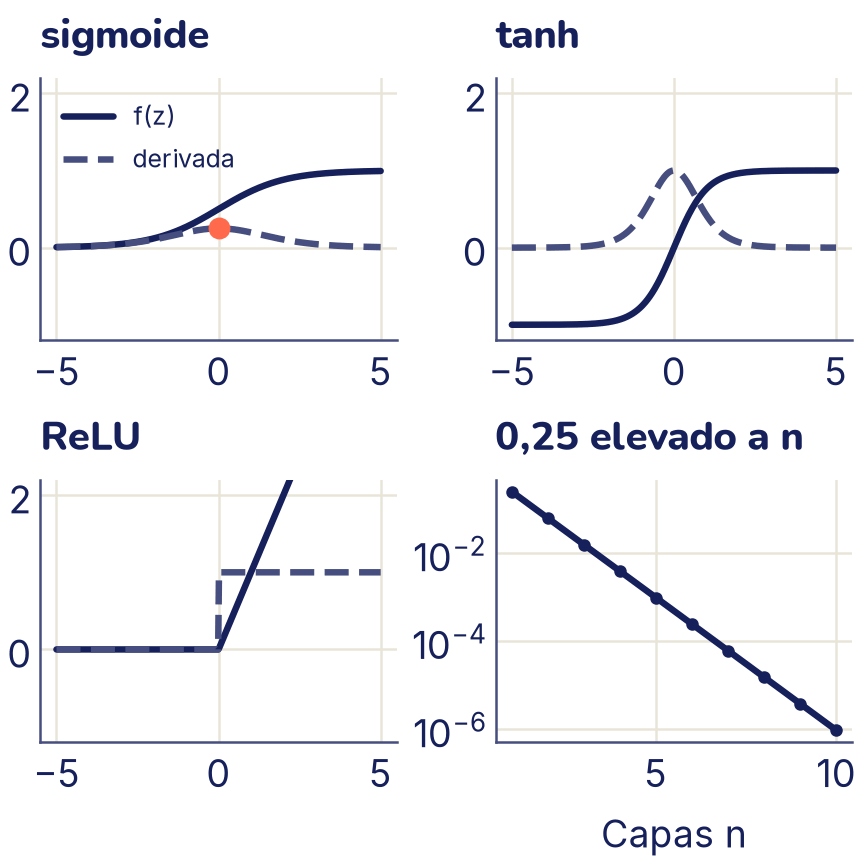
Comparemos:
| Sigmoide | tanh | ReLU | |
|---|---|---|---|
| Rango | de 0 a 1 | de −1 a 1 | de 0 a infinito |
| Derivada máxima | 0,25 | 1 | 1 (en todos los positivos) |
| Derivada lejos del 0 | casi 0 en los dos lados | casi 0 en los dos lados | 1 a la derecha, 0 a la izquierda |
| Uso típico hoy | la salida de una clasificación binaria | algunas redes que procesan secuencias | las capas ocultas de casi todas las redes |
La sigmoide y la tanh se saturan: lejos del 0 son casi planas y su derivada casi se anula. Eso trae un problema que entenderás bien en el tema 17. Allí vas a ver que, para ajustar los pesos de las primeras capas, la red multiplica las derivadas de todas las capas que hay en el camino. Con la sigmoide, cada derivada vale como mucho 0,25, así que con diez capas el producto puede ser menor que una millonésima: las primeras capas casi no reciben señal y aprenden muy lento. Es el desvanecimiento del gradiente. La ReLU tiene derivada 1 en todos los positivos y lo sufre mucho menos; por eso, y porque es muy barata de calcular, es la opción por defecto en las capas ocultas.
De la neurona a la red
Una capa es un grupo de neuronas que reciben las mismas entradas, cada una con sus propios pesos. Un perceptrón multicapa (MLP, por multilayer perceptron) pone capas una detrás de otra: las salidas de una capa son las entradas de la siguiente. Las capas del medio se llaman ocultas porque no vemos sus valores en los datos; solo vemos la entrada y la salida. El número de neuronas de una capa es su ancho y el número de capas es la profundidad. Una red «2-2-1» tiene 2 entradas, una capa oculta de 2 neuronas y 1 neurona de salida. (A pesar del nombre, las neuronas de un MLP casi nunca usan el escalón del perceptrón.)
XOR con pesos elegidos a mano
Construyamos una red 2-2-1 que resuelva XOR. La idea es pensar XOR como «O, pero no Y»: la luz se prende si al menos un interruptor está en 1, salvo que estén los dos.
- La neurona oculta 1 calcula O: con pesos 6 y 6 y sesgo −3, su puntaje es positivo en cuanto una entrada vale 1.
- La neurona oculta 2 calcula Y: con los mismos pesos y sesgo −9, solo es positivo si las dos valen 1.
- La neurona de salida calcula «h₁ y no h₂»: peso 8 para h₁, peso −8 para h₂ y sesgo −4.
Todas usan la sigmoide; los pesos grandes la vuelven casi un escalón, pero suave. Con matrices, una capa entera se calcula de una vez. Si ponemos los cuatro ejemplos como filas de X, de forma (4, 2), y los pesos de cada neurona como una columna de W₁, de forma (2, 2):
H tiene una fila por ejemplo y una columna por neurona oculta. El sesgo se suma a cada fila por broadcasting (tema 3).
X4 = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y4 = np.array([0, 1, 1, 0])           # XOR

# Cada columna de W1 son los pesos de una neurona oculta
W1 = np.array([[6.0, 6.0],
               [6.0, 6.0]])
b1 = np.array([-3.0, -9.0])           # neurona 1: «O»; neurona 2: «Y»
W2 = np.array([[8.0],
               [-8.0]])               # «h1 y no h2»
b2 = np.array([-4.0])

H = sigmoide(X4 @ W1 + b1)            # (4, 2) @ (2, 2) -> (4, 2)
salida = sigmoide(H @ W2 + b2)        # (4, 2) @ (2, 1) -> (4, 1)

print("x1 x2 |   h1    h2  | salida | XOR")
for xi, hi, si, yi in zip(X4, H, salida[:, 0], y4):
    print(f" {xi[0]}  {xi[1]} | {hi[0]:.3f} {hi[1]:.3f} |"
          f"  {si:.3f} |  {yi}")
x1 x2 | h1 h2 | salida | XOR
0 0 | 0.047 0.000 | 0.026 | 0
0 1 | 0.953 0.047 | 0.962 | 1
1 0 | 0.953 0.047 | 0.962 | 1
1 1 | 1.000 0.953 | 0.026 | 0Las cuatro salidas están del lado correcto de 0,5, y bien lejos. Lo interesante es la columna del medio: la capa oculta transformó los datos. En el espacio (h₁, h₂), las esquinas (0, 1) y (1, 0) caen en el mismo lugar, cerca de (0,95; 0,05), y los otros dos casos quedan en (0, 0) y (1; 0,95). Ahí, una sola recta los separa sin problema: la de la neurona de salida. Veamos lo que hace cada neurona en todo el plano. Pintamos su salida en bandas de un solo color por lado: coral donde pasa de 0,5 y tinta donde no, más intenso cuanto más lejos de 0,5.
def pintar_salida(ax, A, B, P):
    """Bandas coral si P >= 0.5 y tinta si no, más fuertes lejos de 0.5."""
    cortes = [0, 0.1, 0.25, 0.4, 0.5, 0.6, 0.75, 0.9, 1]
    for bajo, alto in zip(cortes[:-1], cortes[1:]):
        color = "C1" if bajo >= 0.5 else "C0"
        lejos = max(abs(bajo - 0.5), abs(alto - 0.5))
        ax.contourf(A, B, P, levels=[bajo, alto], colors=color,
                    alpha=0.6 * lejos)

A, B = np.meshgrid(np.linspace(-0.5, 1.5, 200), np.linspace(-0.5, 1.5, 200))
plano = np.column_stack([A.ravel(), B.ravel()])
H_plano = sigmoide(plano @ W1 + b1)
sal_plano = sigmoide(H_plano @ W2 + b2)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
paneles = [(ejes[0, 0], H_plano[:, 0], "Oculta 1: O"),
           (ejes[0, 1], H_plano[:, 1], "Oculta 2: Y"),
           (ejes[1, 1], sal_plano[:, 0], "Salida: XOR")]
for eje, valores, titulo in paneles:
    pintar_salida(eje, A, B, valores.reshape(A.shape))
    dibujar_clases(X4, y4, ax=eje, s=50)
    eje.set_title(titulo)

# Lo que ve la neurona de salida: los cuatro casos en el espacio (h1, h2)
dibujar_clases(H, y4, ax=ejes[1, 0], s=50)
h = np.linspace(-0.1, 1.1, 2)
# Frontera de la salida: 8·h1 - 8·h2 - 4 = 0, o sea h2 = h1 - 0.5
ejes[1, 0].plot(h, h - 0.5, color="C0")
ejes[1, 0].set_xlim(-0.1, 1.1)
ejes[1, 0].set_ylim(-0.1, 1.1)
ejes[1, 0].set_title("Espacio oculto")
ejes[1, 0].set_xlabel("$h_1$")
ejes[1, 0].set_ylabel("$h_2$")
plt.show()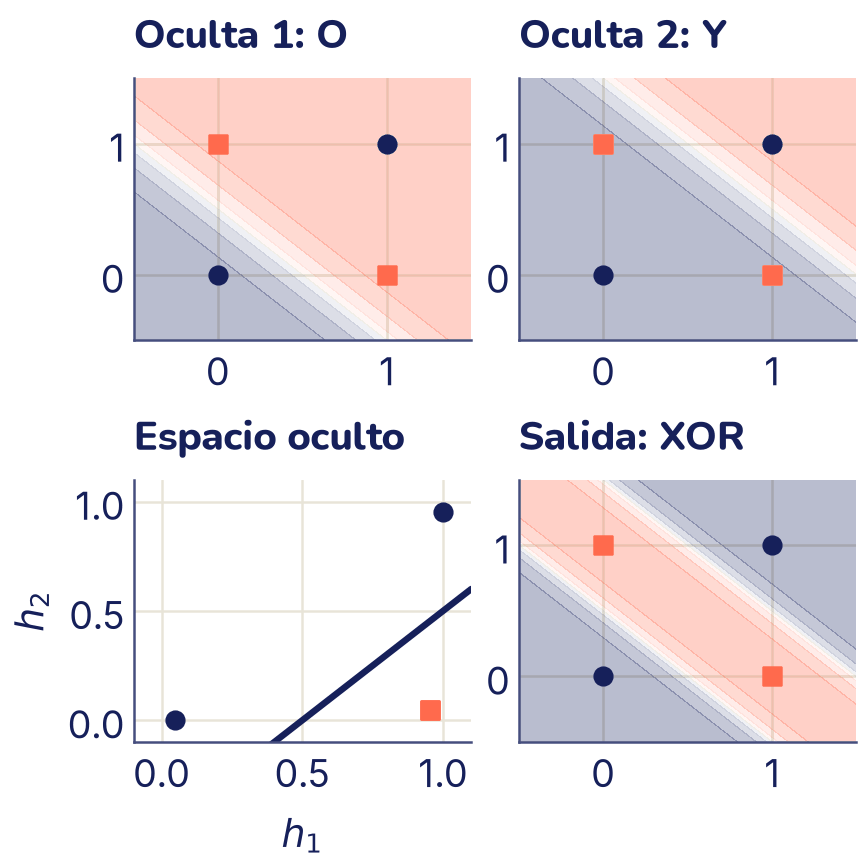
La salida de la red ya no es una recta: es una franja entre dos rectas paralelas, una de cada neurona oculta. Así se construyen fronteras curvas o con forma: cada neurona oculta aporta un corte recto y la capa siguiente los combina. Con más neuronas, más cortes, y la frontera puede tomar casi cualquier forma.
El paso hacia adelante, para cualquier red
Calcular la salida de una red a partir de la entrada se llama paso hacia adelante (en inglés, forward pass). Para cualquier número de capas es el mismo bucle: multiplicar por la matriz de pesos, sumar el sesgo, aplicar la activación y pasar el resultado a la capa siguiente. La última capa no lleva la activación de las ocultas; qué lleva depende de la tarea, como verás más abajo.
Lo más útil para no perderse es seguir el shape de cada matriz. Con n ejemplos y una capa que pasa de a entradas a m neuronas, la cuenta es (n, a) @ (a, m), que da (n, m): el número del medio tiene que coincidir y «desaparece», y el sesgo tiene un número por neurona, de forma (m,).
def adelante(X, capas, activacion=relu, ver=False):
    """Paso hacia adelante de un MLP. capas: una lista de pares (W, b)."""
    A = X
    for i, (W, b) in enumerate(capas):
        Z = A @ W + b
        if ver:
            print(f"Capa {i + 1}: {A.shape} @ {W.shape} + {b.shape}"
                  f" -> {Z.shape}")
        ultima = i == len(capas) - 1
        # Las capas ocultas llevan activación; la última sale tal cual
        A = Z if ultima else activacion(Z)
    return A

rng = np.random.default_rng(0)
# Una red 2-4-1 con pesos al azar: de 2 entradas a 4 ocultas, y a 1
red = [(rng.normal(size=(2, 4)), np.zeros(4)),
       (rng.normal(size=(4, 1)), np.zeros(1))]
X5 = rng.normal(size=(5, 2))          # cinco ejemplos
salida5 = adelante(X5, red, ver=True)

# La misma función, con la red de XOR y sigmoide en la salida
z_xor = adelante(X4, [(W1, b1), (W2, b2)], activacion=sigmoide)
print("XOR:", sigmoide(z_xor).ravel().round(3))
Capa 1: (5, 2) @ (2, 4) + (4,) -> (5, 4)
Capa 2: (5, 4) @ (4, 1) + (1,) -> (5, 1)
XOR: [0.026 0.962 0.962 0.026]Una red así es una composición de funciones: cada capa es una función que recibe lo que devolvió la anterior. Una red con dos capas ocultas calcula f₃(f₂(f₁(x))), donde cada f es «multiplicar, sumar y activar». Las redes enormes de los últimos temas de la ruta son, en el fondo, muchas capas así compuestas.
Contar parámetros
Cada capa que pasa de a entradas a m neuronas tiene una matriz de a × m pesos y m sesgos. Los parámetros de la red son la suma de todas las capas:
def contar_parametros(tamanos):
    """Pesos y sesgos de un MLP con capas de esos tamaños."""
    total = 0
    for a, m in zip(tamanos[:-1], tamanos[1:]):
        total += a * m + m            # matriz (a, m) y un sesgo por neurona
    return total

for tamanos in [[2, 2, 1], [2, 4, 1], [784, 128, 10]]:
    print(tamanos, "->", contar_parametros(tamanos), "parámetros")
[2, 2, 1] -> 9 parámetros
[2, 4, 1] -> 17 parámetros
[784, 128, 10] -> 101770 parámetrosLa red de XOR tiene 9 parámetros: los 9 deslizadores del modo «Red para XOR» de la actividad. La última es una red típica para imágenes de 28 × 28 píxeles (784 entradas) y 10 clases, como las que vas a entrenar en el tema 18: con una sola capa oculta ya pasa de cien mil parámetros. Casi todos están en la primera capa, porque cada píxel se conecta con cada neurona oculta.
¿Y si no hay activación?
Podría parecer que la activación es un detalle. No lo es: sin ella, apilar capas no sirve de nada. Si dos capas solo multiplican y suman, se pueden juntar en una:
Comprobémoslo con números:
rng = np.random.default_rng(1)
V1, c1 = rng.normal(size=(2, 4)), rng.normal(size=4)
V2, c2 = rng.normal(size=(4, 1)), rng.normal(size=1)

dos_capas = (X5 @ V1 + c1) @ V2 + c2  # dos capas, sin activación
V, c = V1 @ V2, c1 @ V2 + c2          # una sola capa equivalente
una_capa = X5 @ V + c

print("Forma de V:", V.shape)
print("¿Dan lo mismo?", np.allclose(dos_capas, una_capa))
Forma de V: (2, 1)
¿Dan lo mismo? TrueDiez capas lineales seguidas siguen siendo una capa lineal, con una frontera recta, y XOR sigue sin resolverse. La activación es lo que «dobla» el espacio entre una capa y la siguiente, como hizo la sigmoide con las esquinas de XOR. Por eso se llama a las activaciones no lineales, y por eso son indispensables.
La salida y la pérdida según la tarea
Las capas ocultas son parecidas en casi todas las redes. Lo que cambia según el problema es la última capa y la pérdida con que se entrena. Son las mismas que ya conoces:
| Tarea | Última capa | Activación de salida | Pérdida |
|---|---|---|---|
| Regresión: predecir un número | 1 neurona | ninguna | MSE (tema 6) |
| Clasificación binaria | 1 neurona | sigmoide | entropía cruzada binaria (tema 8) |
| Clasificación en K clases | K neuronas | softmax | entropía cruzada categórica (tema 8) |
Una regresión lineal es una red sin capas ocultas y sin activación de salida; una regresión logística es una red sin capas ocultas con sigmoide a la salida. Las redes neuronales no reemplazan lo que aprendiste en la fase 2: lo extienden con capas ocultas.
Un adelanto: una red que aprende sola
Elegir pesos a mano funciona con 9 parámetros, no con cien mil. Las redes aprenden sus pesos con descenso de gradiente, como la recta del tema 6 y la logística del tema 8. La parte difícil es calcular el gradiente de la pérdida respecto de cada peso de cada capa; el método para hacerlo, la retropropagación (backpropagation), es el tema 17. Mientras tanto, scikit-learn trae un MLP listo, MLPClassifier, con la misma interfaz fit y predict de siempre.
Volvamos a las dos lunas del tema 8, con la misma división en entrenamiento y validación. Allí, la logística, con su frontera recta, acertaba el 85 % en validación. Probemos un MLP con una capa oculta de 1, 3, 10 y 100 neuronas. Usamos solver="lbfgs", un método de optimización más refinado que el descenso de gradiente básico, que funciona bien con pocos datos; la activación de las capas ocultas es la ReLU, que es la opción por defecto.
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

# Las mismas lunas y la misma división del tema 8
X, y = make_moons(n_samples=200, noise=0.3, random_state=0)
X_entr, X_val, y_entr, y_val = train_test_split(
    X, y, test_size=0.3, random_state=0)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for eje, ocultas in zip(ejes.flat, [1, 3, 10, 100]):
    red_mlp = MLPClassifier(hidden_layer_sizes=(ocultas,),
                            solver="lbfgs", max_iter=2000,
                            random_state=0)
    red_mlp.fit(X_entr, y_entr)
    regiones(eje, red_mlp.predict, (-2, 3), (-1.5, 2))
    dibujar_clases(X_entr, y_entr, ax=eje, s=8)
    eje.set_title(f"Ancho {ocultas}")
    print(f"Ancho {ocultas:3d}:  aciertos al entrenar "
          f"{red_mlp.score(X_entr, y_entr):.2f}"
          f"   en validación {red_mlp.score(X_val, y_val):.2f}")
plt.show()
Ancho 1: aciertos al entrenar 0.83 en validación 0.85
Ancho 3: aciertos al entrenar 0.84 en validación 0.82
Ancho 10: aciertos al entrenar 0.91 en validación 0.97
Ancho 100: aciertos al entrenar 1.00 en validación 0.85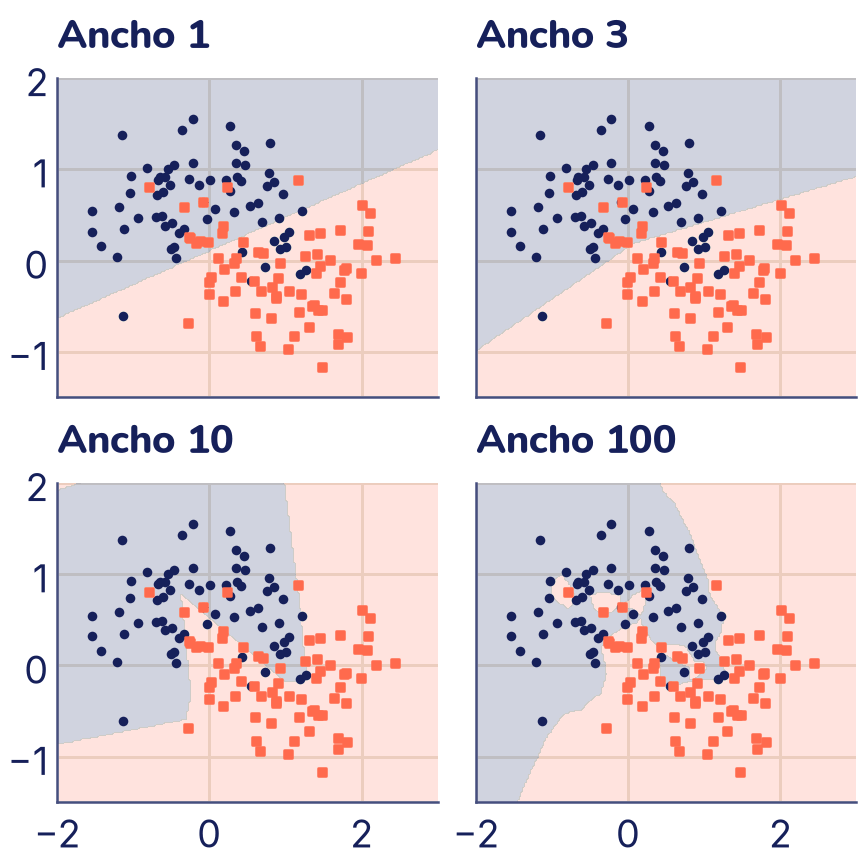
Es la misma historia de los temas 7 y 8, ahora con el ancho de la red:
- Con 1 neurona oculta, la frontera es una recta y le va igual que a la logística (85 % en validación). Tiene sentido: con una sola ReLU, la salida solo puede crecer en una dirección, así que la frontera sigue siendo el corte de una sola recta.
- Con 3, la red puede quebrar un poco la frontera, pero con estos pesos apenas la dobla y no mejora.
- Con 10, la frontera se curva siguiendo las lunas y acierta el 97 % en validación.
- Con 100, acierta todos los puntos de entrenamiento pero solo el 85 % en validación: la frontera se retuerce para rodear puntos sueltos que son ruido. La red memorizó, igual que k-NN con k = 1.
Más neuronas dan más rectas para combinar y fronteras más flexibles, pero también más capacidad para sobreajustar. El ancho y la profundidad son hiperparámetros, y se eligen como siempre: mirando la validación. Lo vas a practicar en el mini-proyecto.
Lo que aprendiste y lo que sigue
- Una neurona calcula una suma ponderada más un sesgo, z = w·x + b, y la pasa por una activación. Con la sigmoide, una neurona es una regresión logística.
- El perceptrón usa el escalón y la regla w ← w + η(y − ŷ)x. Encuentra una recta que separa las clases cuando existe, pero ninguna recta resuelve XOR.
- La sigmoide (de 0 a 1) y la tanh (de −1 a 1) se saturan y su derivada se anula lejos del 0; la de la sigmoide vale como mucho 0,25, lo que provoca el desvanecimiento del gradiente en redes profundas. La ReLU es la opción por defecto en las capas ocultas.
- Un MLP apila capas; cada una calcula f(AW + b). Siguiendo los
shapes, (n, a) @ (a, m) da (n, m). Una capa de a a m tiene a·m + m parámetros. - Sin activación, varias capas equivalen a una sola. Con ella, cada neurona oculta traza una recta y las siguientes las combinan en fronteras con forma.
- La última capa y la pérdida dependen de la tarea: sin activación y MSE para regresión, sigmoide y entropía cruzada para dos clases, softmax y entropía cruzada para varias.
En el tema 17 vas a abrir la caja de fit: programar desde cero cómo una red calcula el gradiente de cada peso con la regla de la cadena, y entrenar con él un MLP pequeño en estas mismas lunas.