La pregunta
Una foto de una cara de 64 × 64 píxeles son 4096 números. Un dígito escrito a mano y escaneado en una cuadrícula de 8 × 8 son 64 números. Para la computadora, cada dígito es un punto en un espacio de 64 dimensiones: uno por píxel. ¿Cómo se mira una nube de 1797 puntos en 64 dimensiones, si nuestros ojos solo ven dos o tres? ¿Y hace falta guardar los 4096 números de cada cara, o con muchos menos se puede reconstruir casi la misma foto?
Piensa en tu sombra. Eres un objeto de tres dimensiones y la sombra en la pared es plana, de dos. Aun así, según cómo pongas la linterna, la sombra te reconoce o no: de perfil se ven tu nariz y tu peinado; desde arriba solo una mancha redonda. Reducir dimensiones es buscar la mejor «linterna»: el ángulo desde el que la sombra de los datos conserva lo más importante.
En este tema vas a:
- entender la proyección de un punto sobre una recta y por qué la mejor recta es la de máxima varianza;
- programar PCA (análisis de componentes principales) desde cero con NumPy y compararlo con scikit-learn;
- elegir cuántas componentes usar con la varianza explicada y usar PCA para comprimir caras;
- dibujar dígitos de 64 dimensiones en un plano con PCA, t-SNE y UMAP, y saber qué no se puede concluir de esos mapas.
Necesitas el producto punto y la multiplicación de matrices del tema 3, y la varianza del tema 5. Del tema «Agrupar sin etiquetas: clustering» sirve la idea de aprendizaje no supervisado: aquí tampoco usamos etiquetas para nada, salvo para colorear los gráficos.
Actividad: gira la sombra
Una nube de puntos en el plano y una recta que pasa por su centro. Cada punto proyecta su sombra sobre la recta: el punto de la recta que le queda más cerca. El segmento entre el punto y su sombra es lo que se pierde al quedarnos solo con la sombra. Gira la recta con el deslizador o arrastrando la bola coral.
Gira la sombra
Esta es la posición inicial, con la recta horizontal. Con JavaScript activado puedes girarla y cambiar de nube.
La varianza total, repartida
sombra 2,61 (69 %)+ error 1,16= total 3,77
Gira la recta: mira cómo la parte oscura de la barra crece cuando la parte clara se achica.
Prueba esto, en orden:
- Gira la recta despacio y mira la barra «La varianza total, repartida»: la parte oscura es la varianza de la sombra (qué tan desparramadas quedan las sombras) y la clara es el error de reconstrucción (el promedio de los segmentos al cuadrado). ¿Cambia el largo total de la barra?
- Busca a mano el ángulo con más varianza. ¿Coincide con el de menos error? Comprueba con «Ir a la mejor recta».
- Cambia a la nube «casi redonda». ¿Qué tan distinta es la mejor recta de la peor?
- Prueba la nube «dos grupos». ¿La mejor recta separa los grupos en la sombra?
Lo que acabas de encontrar es la primera componente principal: la recta donde la sombra conserva la mayor parte de la variación de los datos y, a la vez, donde menos se pierde. El resto del tema le pone fórmula y la lleva a 64 y 4096 dimensiones.
Proyectar: la sombra de un punto
Empecemos en dos dimensiones, donde todo se puede dibujar. Los datos son sintéticos: las notas de Matemática y de Física de 200 estudiantes inventados, con la regla de que a quien le va bien en una tiende a irle bien en la otra. Lo primero es centrar la nube: restar a cada columna su media, para que el centro quede en el origen y las rectas que probemos pasen por él.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(0)
n = 200
# Datos sintéticos: notas de Matemática y de Física de 200 estudiantes
mate = rng.normal(60, 12, size=n)
fisica = 60 + 0.8 * (mate - 60) + rng.normal(0, 6, size=n)
X = np.column_stack([mate, fisica])       # forma (200, 2)

# Centrar: restar la media de cada columna
Xc = X - X.mean(axis=0)
print("Forma:", X.shape)
print("Medias antes:", X.mean(axis=0).round(1))
print("Medias después:", Xc.mean(axis=0).round(1))
Forma: (200, 2)
Medias antes: [60.2 59.6]
Medias después: [0. 0.]Una recta que pasa por el origen se describe con un vector unitario u (de largo 1) que apunta en su dirección; con un ángulo θ, u = (cos θ, sin θ). La sombra de un punto x sobre esa recta se calcula con el producto punto del tema 3:
El número t es la coordenada del punto sobre la recta: cuánto avanza en la dirección de u. Con un solo número por punto, en lugar de dos, ya redujimos de 2 dimensiones a 1. Para volver al plano multiplicamos t por u: eso es la reconstrucción, y lo que le falta para llegar al punto original es el error.
El punto, su sombra y el origen forman un triángulo rectángulo (la sombra es el punto de la recta más cercano, así que el segmento que se pierde es perpendicular a ella). Por Pitágoras:
Promediando sobre todos los puntos, el lado izquierdo es la varianza total de la nube (fija: no depende de la recta); el primer término de la derecha es la varianza de la sombra (como la nube está centrada, las sombras tienen media cero) y el segundo es el error de reconstrucción. Lo que gana uno lo pierde el otro.
def sombra(Xc, angulo):
    """Varianza de la sombra y error de reconstrucción sobre una recta."""
    rad = np.deg2rad(angulo)
    u = np.array([np.cos(rad), np.sin(rad)])  # dirección, de largo 1
    t = Xc @ u                    # la coordenada de cada sombra
    reconstruido = np.outer(t, u)  # la sombra, de vuelta en el plano
    varianza = np.mean(t ** 2)
    error = np.mean(np.sum((Xc - reconstruido) ** 2, axis=1))
    return varianza, error

total = np.mean(np.sum(Xc ** 2, axis=1))   # varianza total de la nube
print(f"Varianza total: {total:.1f}")
for angulo in [0, 45, 90]:
    v, e = sombra(Xc, angulo)
    print(f"{angulo:3d}°:  varianza {v:6.1f}  + error {e:6.1f}"
          f"  = {v + e:.1f}")
Varianza total: 248.7
0°: varianza 133.0 + error 115.6 = 248.7
45°: varianza 226.2 + error 22.5 = 248.7
90°: varianza 115.6 + error 133.0 = 248.7La suma siempre da 248,7, la varianza total. Con la recta horizontal (0°) la sombra es solo la nota de Matemática y conserva 133 de los 248,7; con la vertical (90°), la de Física, 115,6. Con la diagonal (45°) la sombra conserva 226,2 y casi no se pierde nada. Busquemos el mejor ángulo probando los 180 (de 180° en adelante se repiten las mismas rectas):
angulos = np.arange(180)
resultados = np.array([sombra(Xc, a) for a in angulos])
varianzas, errores = resultados[:, 0], resultados[:, 1]
mejor = angulos[np.argmax(varianzas)]
print("Ángulo con más varianza:", mejor, "grados")
print("Ángulo con menos error: ", angulos[np.argmin(errores)], "grados")

plt.plot(angulos, varianzas, color="C0", label="Varianza")
plt.plot(angulos, errores, color="C2", linestyle="--",
         label="Error")
plt.scatter([mejor], [varianzas.max()], color="C1", s=120, zorder=3)
plt.ylim(0, 320)
plt.xlabel("Ángulo de la recta (grados)")
plt.ylabel("Puntos al cuadrado")
plt.title("Girar la recta reparte la varianza")
plt.legend(loc="upper center", ncol=2)
plt.show()
Ángulo con más varianza: 43 grados
Ángulo con menos error: 43 grados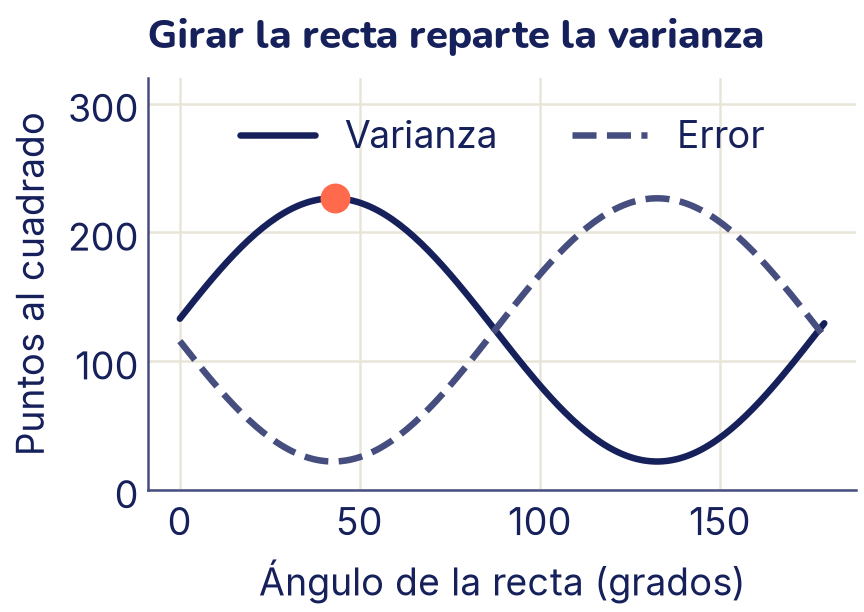
Las dos curvas son una el espejo de la otra: el ángulo de máxima varianza es el mismo que el de mínimo error. Es lo que viste en la actividad. Esa recta, a unos 43°, es la primera componente principal. Tiene sentido: quien saca buena nota en Matemática suele sacar buena nota en Física, así que la dirección «a los dos les va bien o a los dos les va mal» resume casi todo; podríamos llamarla «rendimiento en ciencias».
Covarianza y vectores propios
Probar todos los ángulos funciona en 2 dimensiones, pero en 64 hay demasiadas direcciones para probarlas una por una. Hace falta un atajo, y lo da la matriz de covarianza. En el tema 5 la varianza medía cuánto se desparrama una columna. La covarianza de dos columnas es el promedio de los productos de sus valores centrados: es positiva si suelen subir juntas, negativa si cuando una sube la otra baja, y cercana a cero si no tienen que ver. Todas juntas forman una matriz; con los datos centrados en las filas de X, sale de una sola multiplicación de matrices:
La segunda fórmula dice que la varianza en cualquier dirección u se calcula con C, sin volver a tocar los datos. Y el atajo es este: la dirección que hace máxima esa varianza es el vector propio de C con el valor propio más grande, y ese valor propio es justamente la varianza que conserva. Un vector propio es una dirección que la matriz no gira, solo estira:
No hace falta que sepas calcularlos a mano: NumPy lo hace con np.linalg.eigh, la versión para matrices simétricas como C (devuelve los valores propios de menor a mayor y los vectores en las columnas).
# Matriz de covarianza: (2, 200) @ (200, 2) da (2, 2)
C = Xc.T @ Xc / n
print("Covarianza:\n", C.round(1))

valores, vectores = np.linalg.eigh(C)   # de menor a mayor
print("Valores propios:", valores.round(1))
print("Vectores propios (columnas):\n", vectores.round(3))

u1 = vectores[:, 1]             # el del valor propio más grande
angulo_u1 = np.rad2deg(np.arctan2(u1[1], u1[0])) % 180
print(f"Ángulo de la primera componente: {angulo_u1:.1f}°")
Covarianza:
[[133. 101.8]
[101.8 115.6]]
Valores propios: [ 22.1 226.5]
Vectores propios (columnas):
[[ 0.676 -0.737]
[-0.737 -0.676]]
Ángulo de la primera componente: 42.6°- En la diagonal de C están las varianzas de cada columna: 133 (Matemática) y 115,6 (Física), las mismas que dieron las rectas de 0° y 90°. Fuera de la diagonal está la covarianza, 101,8: positiva y grande, porque las dos notas suben juntas.
- El valor propio grande, 226,5, es la varianza de la sombra sobre la mejor recta, y su vector propio apunta a 42,6°, el mismo ángulo que encontramos probando (allá, de grado en grado, salió 43). El vector sale con los dos signos negativos: apunta hacia abajo a la izquierda, pero es la misma recta. El signo de un vector propio es arbitrario.
- El otro valor propio, 22,1, es la varianza en la dirección perpendicular: la segunda componente principal. Los dos suman 248,6, la varianza total (salvo redondeo).
Dibujemos las dos componentes como flechas desde el centro, cada una de largo dos desviaciones estándar en su dirección:
centro = X.mean(axis=0)
plt.scatter(X[:, 0], X[:, 1], s=14, color="C2", alpha=0.5)
for k, color in [(1, "C1"), (0, "C0")]:
    # Flecha de largo 2 desviaciones estándar en cada dirección;
    # el signo de un vector propio es arbitrario: la giramos hacia +x
    flecha = 2 * np.sqrt(valores[k]) * vectores[:, k]
    flecha = flecha * np.sign(flecha[0])
    plt.annotate("", xy=centro + flecha, xytext=centro,
                 arrowprops=dict(arrowstyle="-|>", color=color, lw=3,
                                 mutation_scale=22))
plt.axis("equal")
plt.xlabel("Matemática")
plt.ylabel("Física")
plt.title("Las dos componentes principales")
plt.show()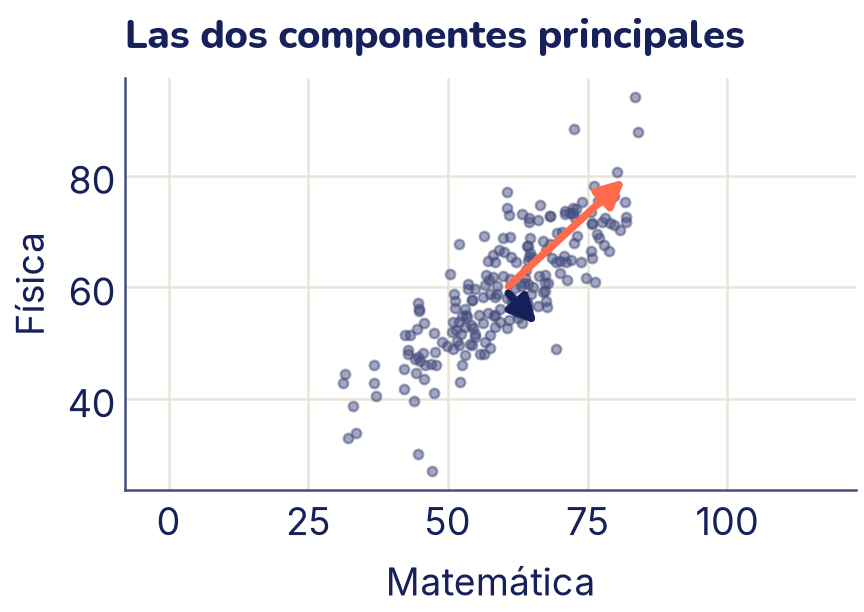
La flecha larga es la primera componente: el eje a lo largo del cual la nube se estira más. La corta es la segunda, perpendicular a la primera. Las componentes principales son un nuevo par de ejes para los mismos datos, girados para alinearse con la forma de la nube. Si guardamos solo la coordenada sobre la flecha larga, perdemos 22,1 de 248,6, menos del 9 % de la varianza.
PCA desde cero
PCA (del inglés principal component analysis) es exactamente esto, en tantas dimensiones como haga falta:
- Centrar los datos.
- Calcular la matriz de covarianza.
- Sacar sus vectores propios y ordenarlos de mayor a menor valor propio: son las componentes principales.
- Quedarse con las k primeras y proyectar los datos sobre ellas: cada punto pasa a tener k coordenadas.
La proporción de la varianza que conserva cada componente es su valor propio dividido entre la suma de todos: la varianza explicada. Probémoslo con los dígitos escritos a mano de scikit-learn (vienen incluidos, sin descarga): 1797 imágenes de 8 × 8 píxeles, cada una aplanada en una fila de 64 números entre 0 y 16.
from sklearn.datasets import load_digits

digitos = load_digits()
Xd, yd = digitos.data, digitos.target
print("Forma de los dígitos:", Xd.shape)

def pca(X, k):
    """PCA desde cero: centrar, covarianza y vectores propios."""
    media = X.mean(axis=0)
    Xc = X - media
    C = Xc.T @ Xc / len(X)
    valores, vectores = np.linalg.eigh(C)
    orden = np.argsort(valores)[::-1]     # de mayor a menor
    valores, vectores = valores[orden], vectores[:, orden]
    componentes = vectores[:, :k].T        # forma (k, columnas)
    Z = Xc @ componentes.T                 # coordenadas nuevas
    return Z, componentes, valores / valores.sum()

Z, comps, proporcion = pca(Xd, 2)
print("Forma de Z:", Z.shape)
print("Proporción de varianza, 5 primeras:", proporcion[:5].round(3))
Forma de los dígitos: (1797, 64)
Forma de Z: (1797, 2)
Proporción de varianza, 5 primeras: [0.149 0.136 0.118 0.084 0.058]La matriz de covarianza ahora es de 64 × 64, pero el código es el mismo de antes. Las primeras componentes conservan el 14,9 %, el 13,6 % y el 11,8 % de la varianza. Ninguna se lleva casi todo, como pasaba con las notas: los dígitos varían de muchas formas distintas. Comparemos con PCA de scikit-learn, que se usa como cualquier modelo: fit aprende las componentes y transform proyecta.
from sklearn.decomposition import PCA

modelo = PCA(n_components=2).fit(Xd)
Z_sk = modelo.transform(Xd)
print("scikit-learn:", modelo.explained_variance_ratio_.round(3))
# Cada componente puede salir con el signo contrario: da igual
print("Mismas direcciones:",
      np.allclose(np.abs(modelo.components_), np.abs(comps)))
print("Mismas coordenadas:", np.allclose(np.abs(Z_sk), np.abs(Z)))
scikit-learn: [0.149 0.136]
Mismas direcciones: True
Mismas coordenadas: TrueLo mismo, salvo el signo de cada componente, que ya sabes que es arbitrario (por eso comparamos los valores absolutos). scikit-learn no usa eigh sino otra factorización, la SVD, más estable con muchos datos; en el ejercicio 2 compruebas que da lo mismo. Lo que aprende queda guardado en el modelo: components_ (las direcciones), mean_ (la media que restó) y explained_variance_ratio_ (la proporción de varianza de cada componente).
La varianza explicada
Con las 64 componentes no se pierde nada: es solo un cambio de ejes. La gracia está en quedarse con menos. Para elegir cuántas, se suma la varianza explicada de la primera, la segunda, y así: la varianza explicada acumulada.
completo = PCA().fit(Xd)                # las 64 componentes
acumulada = np.cumsum(completo.explained_variance_ratio_)
for meta in [0.5, 0.8, 0.9, 0.95]:
    k = np.argmax(acumulada >= meta) + 1  # primera que llega a la meta
    print(f"Para {meta:.0%} de la varianza: {k:2d} componentes")

k90 = np.argmax(acumulada >= 0.9) + 1
plt.plot(np.arange(1, 65), acumulada, color="C0")
plt.axhline(0.9, color="C2", linestyle="--", linewidth=1.5)
plt.scatter([k90], [acumulada[k90 - 1]], color="C1", s=120, zorder=3)
plt.xlabel("Número de componentes")
plt.ylabel("Varianza acumulada")
plt.title("¿Cuántas componentes hacen falta?")
plt.show()
Para 50% de la varianza: 5 componentes
Para 80% de la varianza: 13 componentes
Para 90% de la varianza: 21 componentes
Para 95% de la varianza: 29 componentes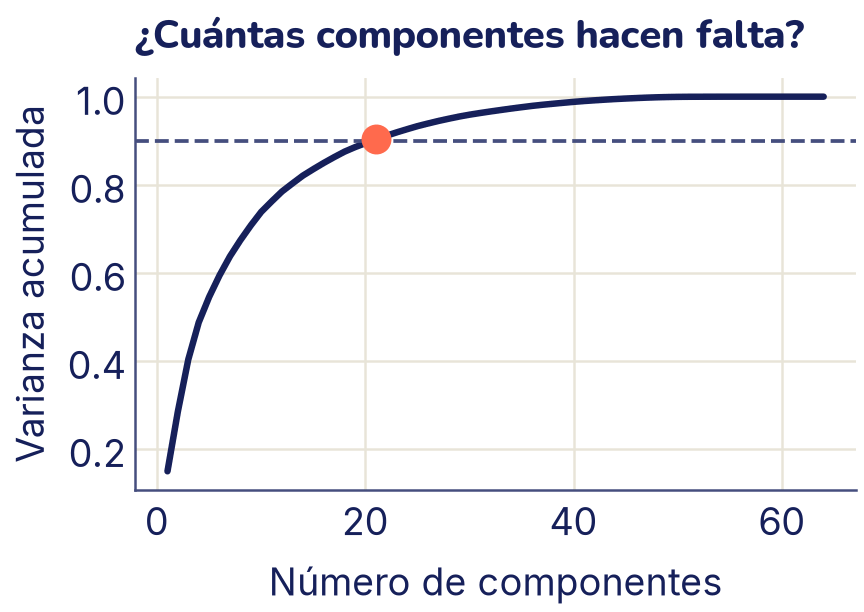
Con 21 de los 64 números de cada dígito se conserva el 90 % de la varianza, y con 29, el 95 %. Las últimas componentes casi no aportan: corresponden sobre todo a detalles chicos y a los píxeles del borde, que casi siempre están vacíos (sin tinta). Una regla habitual es elegir k para llegar al 90 % o al 95 %. Pero lo que más importa es para qué lo vas a usar: si PCA es un paso previo a un clasificador, lo mejor es elegir k según la exactitud del clasificador con datos de validación (ejercicio 4), con PCA dentro del pipeline, como el escalador del tema 10.
Los dígitos en un plano
Para mirar los datos nos quedamos con 2 componentes, aunque solo conserven el 28,5 % de la varianza (14,9 % + 13,6 %). PCA es lineal: la sombra se proyecta siempre sobre un plano recto. Si los grupos de los datos están enredados de una forma que ningún plano recto separa, PCA los va a mostrar encimados. Para eso hay dos métodos no lineales muy usados.
t-SNE (se lee «ti-esne») no busca una buena sombra, sino conservar vecindarios. Primero, para cada punto, mira qué otros puntos tiene cerca en las 64 dimensiones y a cada uno le da una probabilidad de ser «su vecino». Después coloca todos los puntos en un plano, al principio casi al azar, y los va moviendo poco a poco (con descenso de gradiente, como en el tema 6) hasta que los vecinos del plano se parezcan a los de las 64 dimensiones. Su parámetro principal es la perplejidad: más o menos, cuántos vecinos mira cada punto (lo típico es entre 5 y 50; por defecto, 30).
UMAP tiene la misma idea, con otra matemática: arma un grafo que une cada punto con sus vecinos más cercanos (como el grafo de vecinos del clustering espectral del tema de clustering) y busca un dibujo en el plano que respete ese grafo. Sus dos perillas son n_neighbors, cuántos vecinos mira (como la perplejidad), y min_dist, qué tan apretados se permiten los puntos en el dibujo. Suele ser más rápido que t-SNE con muchos datos y, a diferencia de t-SNE, puede ubicar puntos nuevos con transform.
UMAP no viene con scikit-learn: es la librería umap-learn. En Colab, si import umap da ModuleNotFoundError, ejecuta antes en una celda aparte !pip install umap-learn (el signo de exclamación le dice a Colab que es un comando para instalar, no Python). Se instala como umap-learn, pero se importa como umap.
Los dos métodos parten de algo al azar, así que fijamos random_state para que el resultado se repita. En UMAP también pasamos n_jobs=1: con varios hilos de cálculo el resultado podría cambiar un poco de una corrida a otra. Este bloque tarda unos segundos; la primera vez, UMAP tarda un poco más porque prepara su código.
¿Cómo medir si un mapa de 2 dimensiones conserva lo importante? Una forma simple: para cada dígito, buscar su vecino más cercano en el mapa y ver si es el mismo dígito. Las etiquetas no se usaron para hacer el mapa, solo para revisarlo.
from sklearn.manifold import TSNE
from sklearn.neighbors import NearestNeighbors
import umap

tsne = TSNE(n_components=2, perplexity=30, random_state=0)
Z_tsne = tsne.fit_transform(Xd)
reductor = umap.UMAP(n_neighbors=15, min_dist=0.1,
                     random_state=0, n_jobs=1)
Z_umap = reductor.fit_transform(Xd)

def vecino_igual(E, y):
    """Fracción de puntos cuyo vecino más cercano es el mismo dígito."""
    vecinos = NearestNeighbors(n_neighbors=2).fit(E)
    indices = vecinos.kneighbors(E, return_distance=False)[:, 1]
    return np.mean(y[indices] == y)

for nombre, E in [("64 dimensiones", Xd), ("PCA 2D", Z_sk),
                  ("t-SNE 2D", Z_tsne), ("UMAP 2D", Z_umap)]:
    print(f"{nombre:15s} {vecino_igual(E, yd):.1%}")
64 dimensiones 98.8%
PCA 2D 58.7%
t-SNE 2D 98.8%
UMAP 2D 98.0%En las 64 dimensiones originales, el vecino más cercano de un dígito es del mismo dígito el 98,8 % de las veces. El plano de PCA baja eso a 58,7 %: la sombra encima a muchos dígitos distintos. t-SNE conserva el 98,8 % y UMAP el 98,0 %: casi todos los vecindarios sobrevivieron al viaje de 64 a 2 dimensiones. Mirémoslo. En cada mapa, los dígitos son puntos grises con su número encima del centro de su grupo, y los unos van en coral:
def dibujar_mapa(eje, E, titulo, destacado=1):
    """Los puntos en gris, uno de los dígitos en coral y las etiquetas."""
    es = yd == destacado
    eje.scatter(E[~es, 0], E[~es, 1], s=3, color="C2", alpha=0.35,
                edgecolors="none")
    eje.scatter(E[es, 0], E[es, 1], s=4, color="C1", edgecolors="none")
    for d in range(10):
        # La etiqueta va un poco arriba del centro de cada dígito
        centro = np.median(E[yd == d], axis=0)
        eje.annotate(str(d), centro, xytext=(0, 10),
                     textcoords="offset points", ha="center",
                     fontsize=14, fontweight="semibold", color="C0")
    eje.set_title(titulo)
    eje.set_xticks([])
    eje.set_yticks([])

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
dibujar_mapa(ejes[0, 0], Z_sk, "PCA")
dibujar_mapa(ejes[0, 1], Z_tsne, "t-SNE")
dibujar_mapa(ejes[1, 0], Z_umap, "UMAP")
# t-SNE otra vez, ahora mirando solo 5 vecinos
Z_tsne5 = TSNE(n_components=2, perplexity=5,
               random_state=0).fit_transform(Xd)
dibujar_mapa(ejes[1, 1], Z_tsne5, "t-SNE, perplejidad 5")
plt.show()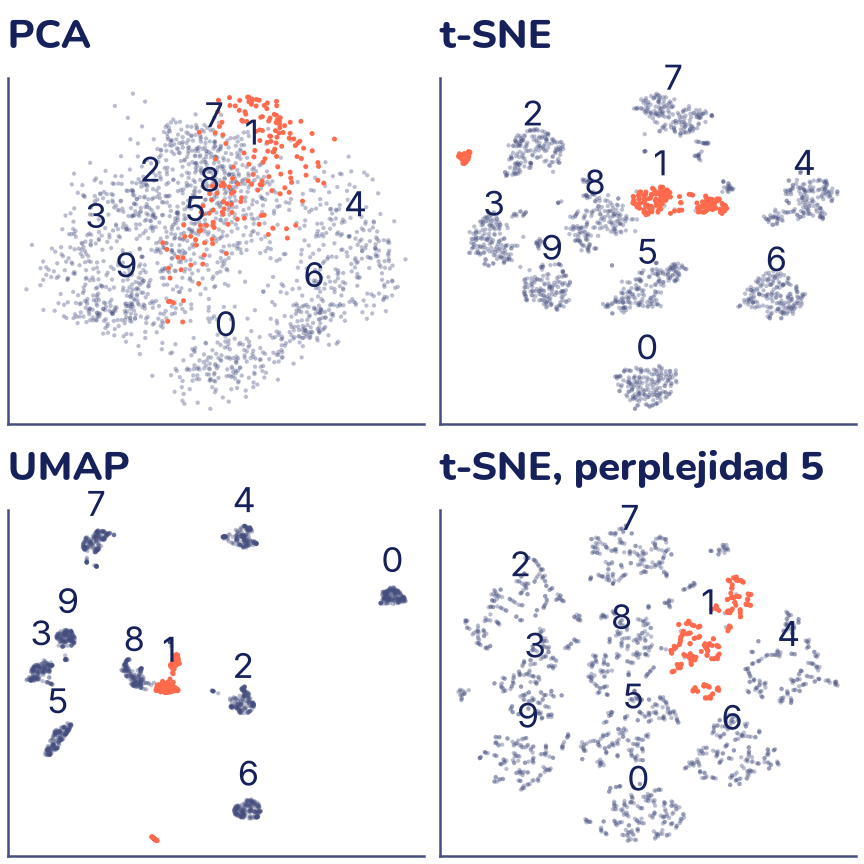
- PCA muestra una sola nube: el 0, el 4 y el 6 se asoman en los bordes, pero en el centro el 1, el 7, el 8 y el 5 se enciman. Sus ejes sí significan algo: son las dos direcciones de más varianza de los píxeles.
- t-SNE separa los diez dígitos en grupos. Los unos coral forman un grupo alargado y además un grupito aparte, junto al 2: hay más de una forma de escribir un 1 (con o sin la rayita de abajo, por ejemplo), y t-SNE lo descubrió sin saber qué es un 1.
- UMAP también separa los diez dígitos, con grupos más apretados (eso lo controla
min_dist) y también con un grupito suelto de unos. - t-SNE con perplejidad 5 mira tan pocos vecinos que los grupos se desarman en hilos y pedazos. No es un mapa «equivocado»: es otra vista, más local, de los mismos datos.
Lo que un mapa no dice
Estos mapas son muy útiles para explorar, pero es fácil leerles más de lo que dicen. Lo que conservan son los vecindarios: qué puntos estaban cerca de cuáles. Casi todo lo demás puede deformarse:
- El tamaño de un grupo no dice cuán variado es. t-SNE tiende a darles a todos los grupos un tamaño parecido.
- La distancia entre dos grupos dice poco. En el mapa de t-SNE el grupo más cercano al 0 es el 5, pero en los píxeles el dígito promedio más parecido al 0 es el 9 (lo compruebas en el ejercicio 5).
- Los ejes no tienen nombre. Girar o reflejar un mapa de t-SNE da un mapa igual de bueno.
- Cada corrida y cada parámetro dan un mapa algo distinto. Confía solo en lo que se repite al cambiar la semilla, la perplejidad o
n_neighbors.
Comprobemos la primera con datos sintéticos que conocemos: dos grupos en 10 dimensiones, uno apretado y otro diez veces más ancho.
rng = np.random.default_rng(1)
# Datos sintéticos en 10 dimensiones: un grupo apretado y uno disperso
apretado = rng.normal(0, 1, size=(200, 10))
disperso = rng.normal(0, 10, size=(200, 10)) + 100
A = np.vstack([apretado, disperso])
E = TSNE(n_components=2, random_state=0).fit_transform(A)

def ancho(P):
    """Distancia promedio de los puntos a su centro."""
    return np.mean(np.linalg.norm(P - P.mean(axis=0), axis=1))

print(f"En 10 dimensiones: el disperso es "
      f"{ancho(A[200:]) / ancho(A[:200]):.1f} veces más ancho")
print(f"En el mapa t-SNE:  el disperso es "
      f"{ancho(E[200:]) / ancho(E[:200]):.1f} veces más ancho")
En 10 dimensiones: el disperso es 10.0 veces más ancho
En el mapa t-SNE: el disperso es 1.0 veces más anchoEn los datos, un grupo es diez veces más ancho que el otro; en el mapa de t-SNE, los dos tienen el mismo ancho. t-SNE se adapta a la densidad de cada zona: dentro de cada grupo reparte los puntos para que los vecinos se vean, y en eso se pierde la escala. Si hubieras visto solo el mapa, habrías concluido que los dos grupos eran igual de variados.
Por eso t-SNE y UMAP se usan para mirar y generar preguntas, y PCA para comprimir y como paso previo de otros modelos: sus componentes son direcciones fijas que se pueden aplicar a cualquier dato nuevo y sus distancias sí se parecen a las originales.
Comprimir caras: las eigencaras
Ahora usemos PCA para lo segundo: guardar menos números. El dataset de caras de Olivetti tiene 400 fotos en escala de grises de 64 × 64 píxeles: 40 personas, 10 fotos de cada una. Viene con scikit-learn, pero hay que descargarlo la primera vez (unos 4 MB, desde el servidor de scikit-learn); después queda guardado en la computadora (en Colab, hasta que se reinicie el entorno).
Para ser honestos con la prueba, apartamos una foto de cada persona: el PCA aprende con 360 fotos y al final probamos con una que no vio. Las componentes son vectores de 4096 números, así que también se pueden mirar como imágenes: se llaman eigencaras (eigen es «propio» en alemán, como en vector propio). Para dibujarlas usamos un mapa de color que va de la tinta al blanco; en Colab puedes usar cmap="gray".
from sklearn.datasets import fetch_olivetti_faces
from matplotlib.colors import LinearSegmentedColormap

caras = fetch_olivetti_faces()       # se descarga la primera vez
Xf = caras.data                      # 400 caras de 64 × 64 = 4096
print("Forma:", Xf.shape)

# Guardamos una foto de cada persona para probar al final
prueba = np.arange(len(Xf)) % 10 == 9
Xf_entr, Xf_prueba = Xf[~prueba], Xf[prueba]
print("Para ajustar:", Xf_entr.shape, "  para probar:", Xf_prueba.shape)

pca_caras = PCA(n_components=200, random_state=0).fit(Xf_entr)
acum = np.cumsum(pca_caras.explained_variance_ratio_)
for k in [5, 20, 100, 200]:
    print(f"{k:3d} componentes: {acum[k - 1]:.1%} de la varianza")

# Un mapa de color de la tinta al blanco (en Colab: "gray")
gris = LinearSegmentedColormap.from_list("gris", ["C0", "white"])
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
imagenes = [pca_caras.mean_] + list(pca_caras.components_[:3])
titulos = ["Cara promedio", "Eigencara 1", "Eigencara 2", "Eigencara 3"]
for eje, img, titulo in zip(ejes.flat, imagenes, titulos):
    eje.imshow(img.reshape(64, 64), cmap=gris)
    eje.set_title(titulo, fontsize=14)
    eje.axis("off")
plt.show()
Forma: (400, 4096)
Para ajustar: (360, 4096) para probar: (40, 4096)
5 componentes: 54.1% de la varianza
20 componentes: 76.5% de la varianza
100 componentes: 93.9% de la varianza
200 componentes: 98.2% de la varianza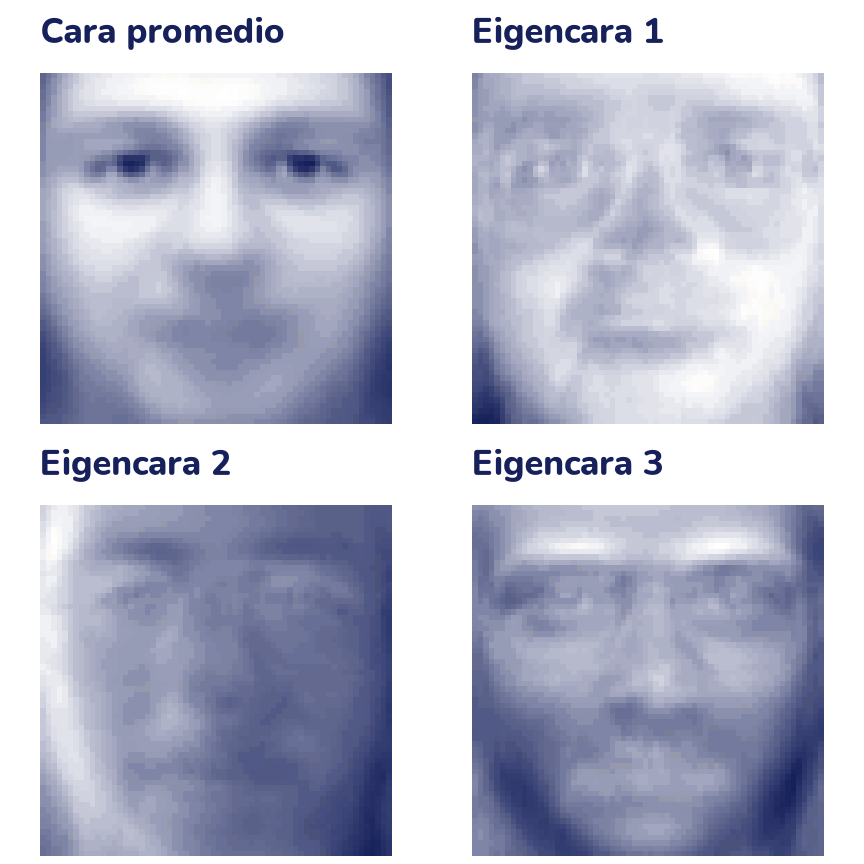
La cara promedio es el centro de la nube: la cara que PCA resta antes de todo. Cada eigencara es una dirección en la que las caras varían mucho: a ojo, la primera tiene que ver sobre todo con la iluminación y la forma general, la segunda con la luz que llega más de un lado que del otro, y la tercera con las cejas, los ojos y el contorno. PCA no sabe nada de caras: estas direcciones salen solo de cómo varían los píxeles. Toda cara se aproxima como la cara promedio más una mezcla de eigencaras:
Los k números z (las coordenadas, con el mismo producto punto de la sombra) son todo lo que hay que guardar de cada cara: la cara promedio y las eigencaras se guardan una sola vez para todas. Con 5 componentes se conserva el 54,1 % de la varianza; con 20, el 76,5 %, y con 100, el 93,9 %. Reconstruyamos la foto que el PCA no vio:
cara = Xf_prueba[[0]]            # una foto que el PCA no vio, forma (1, 4096)
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
ejes[0, 0].imshow(cara.reshape(64, 64), cmap=gris, vmin=0, vmax=1)
ejes[0, 0].set_title("Original: 4096", fontsize=14)
for eje, k in zip([ejes[0, 1], ejes[1, 0], ejes[1, 1]], [5, 20, 100]):
    W = pca_caras.components_[:k]       # las k primeras, forma (k, 4096)
    z = (cara - pca_caras.mean_) @ W.T  # k números por cara
    reconstruida = pca_caras.mean_ + z @ W
    error = np.mean((cara - reconstruida) ** 2)
    print(f"{k:3d} números: error cuadrático medio {error:.4f}")
    eje.imshow(reconstruida.reshape(64, 64), cmap=gris, vmin=0, vmax=1)
    eje.set_title(f"Con {k} números", fontsize=14)
for eje in ejes.flat:
    eje.axis("off")
plt.show()
5 números: error cuadrático medio 0.0141
20 números: error cuadrático medio 0.0078
100 números: error cuadrático medio 0.0044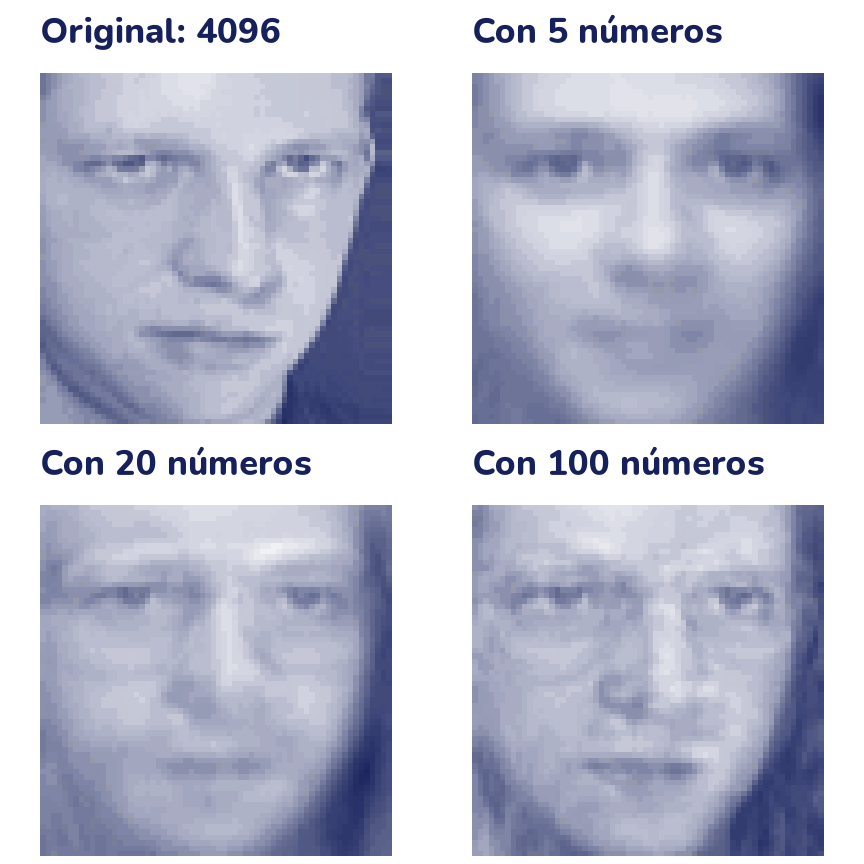
Con 5 números sale una cara cualquiera, casi la promedio. Con 20 ya aparecen los ojos, las cejas y la boca de esta persona, aunque borrosos. Con 100, unas 40 veces menos números que los 4096 píxeles, la persona se reconoce, aunque con ruido. El error cuadrático medio por píxel baja de 0,0141 a 0,0078 y a 0,0044. Y esto con una foto que el PCA nunca vio: aprendió de las otras 360 cómo varían las caras en general.
Lo que aprendiste y lo que sigue
- Proyectar es quedarse con la sombra de los datos sobre una recta o un plano: la coordenada es un producto punto. Por Pitágoras, la varianza de la sombra más el error de reconstrucción es siempre la varianza total, así que máxima varianza y mínimo error son la misma recta.
- Las componentes principales son los vectores propios de la matriz de covarianza, ordenados por su valor propio, que es la varianza que conserva cada una. PCA desde cero son unas diez líneas de NumPy;
PCAde scikit-learn da lo mismo, salvo el signo. - La varianza explicada acumulada ayuda a elegir cuántas componentes guardar. PCA sirve para comprimir (las eigencaras) y como preprocesamiento, dentro del pipeline.
- t-SNE y UMAP dibujan datos de muchas dimensiones en un plano conservando los vecindarios. Sirven para mirar, pero los tamaños de los grupos, las distancias entre grupos y los ejes no se interpretan, y cada corrida puede cambiar.
Las redes neuronales de la fase 4 también aprenden representaciones de pocas dimensiones, pero no lineales; en el tema 22 vas a ver embeddings de palabras y vas a usar estos mismos mapas para mirarlos, y en el tema 29 un autoencoder, que es como un PCA hecho con una red.