La pregunta
Una tienda en línea recibe miles de reseñas por día: «Me encantó, llegó rápido», «Se rompió a la semana, no lo compren». Quieren separar automáticamente las contentas de las enojadas. En el tema 8 aprendiste a clasificar con regresión logística, pero la logística solo sabe multiplicar números por pesos. Una reseña no es una tabla de números: es una fila de letras de largo variable.
¿Cómo se convierte un texto en números que un modelo pueda usar? Esa es la pregunta de este tema, y la respuesta tiene varias capas: cortar el texto en pedazos (tokens), darle un número a cada pedazo (el vocabulario), y después contar, ponderar o rellenar esos números según lo que el modelo necesite. Todo lo que viene en la ruta (embeddings, transformers, los modelos de lenguaje grandes) empieza exactamente aquí.
En este tema vas a:
- normalizar un texto y partirlo en tokens por palabras, por caracteres y por subpalabras con un BPE programado por ti;
- construir un vocabulario con un token para las palabras desconocidas,
<UNK>; - ver la ley de Zipf en un libro entero: pocas palabras lo llenan casi todo;
- comparar tu tokenizador con los de GPT-2 y DistilBERT;
- construir un modelo de lenguaje de n-gramas y medirlo con la perplejidad;
- representar textos con bolsa de palabras y TF-IDF, programar un clasificador Naive Bayes y compararlo con la regresión logística para clasificar reseñas;
- armar lotes de frases de distinto largo con padding y máscara.
Necesitas lo del tema 2 (diccionarios y contar palabras), el tema 5 (la regla de Bayes y los logaritmos), el tema 8 (regresión logística), el tema 9 (exactitud y matriz de confusión), el tema 10 (pipelines) y el tema 18 (tensores de PyTorch).
Actividad: taller de tokens
Escribe una frase en español. El taller la parte de tres maneras: en palabras, en caracteres y con BPE, un método que aprende pedazos de palabras a partir de un texto. Este BPE se entrenó en tu navegador con el comienzo del Quijote («En un lugar de la Mancha…»). El deslizador elige cuántas fusiones usa: cada fusión junta los dos pedazos vecinos que más se repiten en ese texto y crea un token nuevo. El token que creó la última fusión aparece con borde coral si está en tu frase. El «_» marca el final de una palabra.
Abajo ves la bolsa de palabras de tus dos frases (cuántas veces aparece cada palabra en cada una) y el lote: las dos frases como listas de números, rellenadas con ceros para que tengan el mismo largo, con su máscara.
Taller de tokens
Así se ven las frases de ejemplo con 40 fusiones. Con JavaScript activado puedes escribir tus frases y mover el número de fusiones.
vocabulario de BPE: 73 tokensfrase 1 con BPE: 20 tokens
Tres maneras de partir la frase 1
Palabras 7
Caracteres 36
BPE 20
Últimas fusiones aprendidas
Bolsa de palabras
| palabra | frase 1 | frase 2 |
|---|---|---|
| casa | 1 | 0 |
| comió | 0 | 1 |
| en | 1 | 0 |
| hidalgos | 1 | 0 |
| leían | 1 | 0 |
| libros | 1 | 0 |
| los | 1 | 0 |
| pan | 0 | 1 |
| sancho | 0 | 1 |
| su | 1 | 0 |
El lote: IDs de BPE con padding
En cada casilla, el ID, su token y abajo la máscara: 1 si es un token real, 0 si es relleno.
Frase 1: 20 tokens + 0 de relleno
Frase 2: 13 tokens + 7 de relleno
Con 40 fusiones, el vocabulario de BPE tiene 73 tokens y la frase se parte en 20 tokens de BPE (7 palabras, 36 caracteres).
Prueba esto, en orden:
- Pon las fusiones en 0. ¿En qué se parecen los tokens de BPE a los caracteres? ¿En qué se diferencian?
- Sube las fusiones de a poco y mira «Últimas fusiones aprendidas». ¿Qué pedazos aparecen primero? ¿Te suenan a terminaciones del español?
- Con 150 fusiones, ¿cuántos tokens tiene la frase? ¿Y el vocabulario? Anota los dos números con 0, 50 y 150 fusiones.
- Escribe una palabra que no esté en el texto de entrenamiento, como «computadora». ¿Cómo la parte el BPE? Ahora escribe «kiwi»: la k y la w nunca aparecieron en ese texto, así que quedan como desconocidas (con borde punteado) y su número en el lote es 1, el de
<unk>(el mismo token desconocido que más abajo escribimos<UNK>). - Escribe en la frase 2 las mismas palabras de la frase 1, pero en otro orden. ¿Cambia la bolsa de palabras?
- Alarga o acorta la frase 2. ¿Qué le pasa al relleno y a la máscara?
La idea central: con más fusiones, cada frase se parte en menos tokens, pero el vocabulario crece. Palabras y caracteres son los dos extremos de esa balanza, y BPE te deja elegir un punto intermedio.
El texto: Don Quijote
Para estudiar cómo se comportan las palabras necesitamos mucho texto. Usaremos El ingenioso hidalgo don Quijote de la Mancha, de Miguel de Cervantes, que es de dominio público. Lo descargamos del Proyecto Gutenberg (libro n.º 2000) una sola vez. Gutenberg pone al principio y al final del archivo una cabecera y un pie en inglés con su licencia; el libro está entre dos marcas, así que cortamos ahí. Por favor, no automatices descargas masivas de Gutenberg: una descarga y guardarla, como aquí, es lo correcto.
import re
import urllib.request
from collections import Counter
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np

# Don Quijote en el Proyecto Gutenberg (libro n.º 2000, dominio público).
# Se baja una sola vez y queda guardado en la carpeta «datos».
URL = "https://www.gutenberg.org/cache/epub/2000/pg2000.txt"
archivo = Path("datos/quijote-pg2000.txt")
if not archivo.exists():
    archivo.parent.mkdir(exist_ok=True)
    urllib.request.urlretrieve(URL, archivo)

crudo = archivo.read_text(encoding="utf-8")
# El libro está entre dos marcas: se quitan la cabecera y el pie
marca = crudo.index("*** START OF THE PROJECT GUTENBERG EBOOK")
inicio = crudo.index("\n", marca) + 1
fin = crudo.index("*** END OF")
quijote = crudo[inicio:fin].strip()

print(f"{len(crudo):,} caracteres con cabecera y pie")
print(f"{len(quijote):,} caracteres del libro")
k = quijote.index("En un lugar de la Mancha")
print(quijote[k:k + 70].replace("\n", " "))
2,130,057 caracteres con cabecera y pie
2,110,726 caracteres del libro
En un lugar de la Mancha, de cuyo nombre no quiero acordarme, no ha muMás de dos millones de caracteres: es un libro largo. Para la computadora, quijote es por ahora una sola cadena de texto, y nuestro trabajo es partirla.
Normalizar y partir en palabras
La forma más natural de partir un texto es en palabras. Antes conviene normalizar: decidir qué diferencias no importan. En el tema 2 pasaste todo a minúsculas y quitaste la puntuación, para que «Pan», «pan,» y «pan» contaran como lo mismo. Ahora lo hacemos con una expresión regular: \w+ significa «una o más letras o números seguidos». En Python, \w reconoce también las letras con tilde y la ñ, así que «mañana» queda entera.
def palabras(texto):
    """Pasa a minúsculas y devuelve la lista de palabras."""
    return re.findall(r"\w+", texto.lower())

todas = palabras(quijote)
conteo = Counter(todas)
print(f"{len(todas):,} palabras, {len(conteo):,} distintas")
print(conteo.most_common(5))
383,640 palabras, 22,950 distintas
[('que', 20769), ('de', 18410), ('y', 18272), ('la', 10492), ('a', 9876)]Cada pedazo en que partimos el texto se llama token, y el proceso, tokenización. Aquí los tokens son palabras: hay 383 640 en el libro, pero solo 22 950 distintas. El Counter del módulo collections es el diccionario palabra → cuenta del tema 2, ya hecho.
¿Quitar las tildes?
Otra normalización posible es quitar las tildes. En inglés casi no hay, pero en español una tilde puede cambiar la palabra:
def sin_tildes(palabra):
    """Quita las tildes (pero no la ñ)."""
    return palabra.translate(str.maketrans("áéíóúü", "aeiouu"))

conteo_sin = Counter(sin_tildes(p) for p in todas)
print(f"Distintas con tildes: {len(conteo):,}   sin tildes: "
      f"{len(conteo_sin):,}")
for a, b in [("el", "él"), ("si", "sí"), ("mas", "más"),
             ("esta", "está")]:
    print(f"{a:<5} {conteo[a]:>5} veces   {b:<5} {conteo[b]:>5} veces")
Distintas con tildes: 22,950 sin tildes: 22,504
el 8265 veces él 1282 veces
si 1968 veces sí 346 veces
mas 240 veces más 2055 veces
esta 631 veces está 442 vecesSin tildes se pierden 446 palabras distintas: algunas eran la misma palabra mal escrita, pero otras eran palabras diferentes que ahora se confunden. «El» es un artículo y «él» un pronombre; «si» es condicional y «sí» afirma; «más» es cantidad y «mas» (en el castellano del Quijote) significa «pero». Por eso, en español, las tildes casi siempre se quedan. Se quitan solo cuando el texto viene muy mal escrito (por ejemplo, mensajes de chat sin tildes) y es más importante juntar variantes que distinguir significados. Como verás más abajo, algunos tokenizadores famosos las quitan sin preguntar.
La ley de Zipf
¿Qué tan repartidas están las palabras? Ordenemos las 22 950 de la más frecuente a la menos frecuente y grafiquemos cuántas veces aparece cada una frente a su puesto, su rango:
frecuencias = np.array(sorted(conteo.values(), reverse=True))
rangos = np.arange(1, len(frecuencias) + 1)

print("Las 10 más frecuentes cubren el "
      f"{frecuencias[:10].sum() / len(todas):.0%} del texto")
print("Las 100 más frecuentes cubren el "
      f"{frecuencias[:100].sum() / len(todas):.0%} del texto")
una_vez = (frecuencias == 1).sum()
print(f"Aparecen una sola vez: {una_vez:,} palabras "
      f"({una_vez / len(conteo):.0%} del vocabulario)")

plt.loglog(rangos, frecuencias, color="C0", label="Don Quijote")
plt.loglog(rangos, frecuencias[0] / rangos, color="C2",
           linestyle="--", label="Zipf: $f_1$ / rango")
plt.xlabel("Rango (1 = la más frecuente)")
plt.ylabel("Veces que aparece")
plt.title("La ley de Zipf en el Quijote")
plt.legend()
plt.show()
Las 10 más frecuentes cubren el 29% del texto
Las 100 más frecuentes cubren el 55% del texto
Aparecen una sola vez: 11,158 palabras (49% del vocabulario)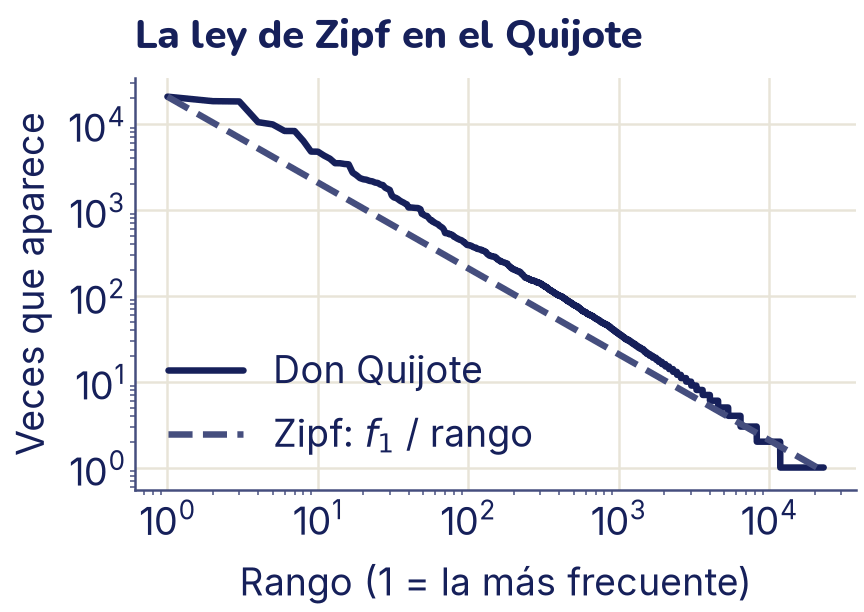
En escala logarítmica la curva es casi una recta: la palabra del puesto 10 aparece más o menos la décima parte de veces que la primera, y la del puesto 100, la centésima parte. Es la ley de Zipf, y se cumple de forma parecida en casi cualquier idioma y cualquier texto largo. Tiene dos consecuencias prácticas:
- Unas pocas palabras llenan casi todo. Las 10 más frecuentes («que», «de», «y», «la»…) son el 29 % del texto, y las 100 primeras, más de la mitad. Casi no dicen nada del tema del texto: por eso más adelante TF-IDF les baja el peso.
- Hay una cola larguísima de palabras raras. Casi la mitad de las palabras distintas (11 158) aparecen una sola vez. Por más texto que juntes, siempre aparecerán palabras nuevas.
El vocabulario y el token desconocido
Un modelo no trabaja con palabras sino con números. El vocabulario es el diccionario que le da a cada token un número entero, su ID. Como hay palabras rarísimas, se suele dejar fuera a las que aparecen muy poco y reemplazarlas por un token especial, <UNK> (de unknown, desconocido). Así el vocabulario es más chico y el modelo no tiene que aprender algo de palabras que vio una sola vez. Reservamos también el número 0 para <PAD>, el relleno, que usaremos al final.
def construir_vocabulario(conteo, minimo=2):
    """Diccionario palabra -> número, con las palabras frecuentes."""
    vocab = {"<PAD>": 0, "<UNK>": 1}
    for palabra, n in conteo.most_common():
        if n >= minimo:
            vocab[palabra] = len(vocab)
    return vocab

def codificar(tokens, vocab):
    """Cambia cada token por su número; los desconocidos, por <UNK>."""
    return [vocab.get(t, vocab["<UNK>"]) for t in tokens]

vocab = construir_vocabulario(conteo)
print(f"Vocabulario: {len(vocab):,} tokens")
frase = "Don Quijote vio un dinosaurio en la computadora"
ids = codificar(palabras(frase), vocab)
print(palabras(frase))
print(ids)
Vocabulario: 11,794 tokens
['don', 'quijote', 'vio', 'un', 'dinosaurio', 'en', 'la', 'computadora']
[18, 22, 166, 28, 1, 7, 5, 1]Dejando solo las palabras que aparecen al menos dos veces, el vocabulario baja de casi 23 000 a 11 794 tokens. «Dinosaurio» y «computadora» no están en el Quijote: las dos reciben el número 1, el de <UNK>. Para el modelo, ambas son la misma palabra desconocida. Ese es el problema de tokenizar por palabras: toda palabra nueva se pierde, y en español, con tantas conjugaciones («comí», «comieron», «comeríamos»), aparecen palabras nuevas todo el tiempo.
Caracteres: el otro extremo
El remedio opuesto es partir en caracteres. El vocabulario es diminuto y nunca hay desconocidos (salvo símbolos rarísimos):
letras = sorted(set(quijote.lower()))
print(f"Caracteres distintos: {len(letras)}")
print("".join(letras[22:]))
print(len(palabras(frase)), "palabras y", len(frase), "caracteres")
Caracteres distintos: 62
abcdefghijlmnopqrstuvwxyz¡«»¿àáéíïñóùúü—
8 palabras y 47 caracteresCon solo 62 caracteres distintos (letras, tildes, números y signos) se puede escribir cualquier palabra del libro, incluso las que todavía no existen. El precio: la misma frase pasa de 8 tokens a 47. Las secuencias se vuelven mucho más largas, y cada token, por sí solo, casi no significa nada: una «e» puede estar en cualquier palabra.
Subpalabras: BPE
Entre palabras y caracteres hay un punto intermedio: subpalabras. La idea de BPE (byte pair encoding, codificación por pares) es empezar con caracteres e ir juntando los pares que más se repiten:
- Parte cada palabra en caracteres y agrega un «_» al final, para saber dónde termina.
- Cuenta todos los pares de piezas vecinas en todo el texto.
- Junta el par más frecuente en una pieza nueva (una fusión) y anótala.
- Repite los pasos 2 y 3 tantas veces como fusiones quieras.
Las palabras frecuentes terminan siendo un solo token; las raras quedan partidas en pedazos conocidos. Así no hay palabras desconocidas y las secuencias no son tan largas. Este es el BPE completo, en Python puro. Para ir rápido, no recorre el texto entero en cada paso: trabaja con el conteo de palabras distintas, y cada par vale tantas veces como aparece su palabra.
def contar_pares(partes):
    """Cuántas veces aparece cada par de piezas vecinas."""
    pares = Counter()
    for piezas, n in partes.items():
        for par in zip(piezas, piezas[1:]):
            pares[par] += n
    return pares

def fusionar(piezas, par):
    """Junta en una sola pieza cada aparición del par."""
    nuevas, i = [], 0
    while i < len(piezas):
        if i + 1 < len(piezas) and (piezas[i], piezas[i + 1]) == par:
            nuevas.append(piezas[i] + piezas[i + 1])
            i += 2
        else:
            nuevas.append(piezas[i])
            i += 1
    return tuple(nuevas)

def entrenar_bpe(conteo, n_fusiones):
    """Aprende las fusiones de BPE a partir de un conteo de palabras."""
    # Cada palabra empieza partida en letras, con «_» al final
    partes = {tuple(p) + ("_",): n for p, n in conteo.items()}
    fusiones, tokens = [], []
    for _ in range(n_fusiones):
        pares = contar_pares(partes)
        if not pares:
            break
        mejor = max(pares, key=pares.get)       # el par más frecuente
        fusiones.append(mejor)
        partes = {fusionar(p, mejor): n for p, n in partes.items()}
        tokens.append(sum(len(p) * n for p, n in partes.items()))
    return fusiones, tokens

def tokenizar_bpe(palabra, fusiones):
    """Parte una palabra aplicando las fusiones en el orden aprendido."""
    piezas = tuple(palabra) + ("_",)
    for par in fusiones:
        piezas = fusionar(piezas, par)
    return list(piezas)
entrenar_bpe devuelve la lista de fusiones en orden, y además, después de cada fusión, cuántos tokens tendría todo el libro. Entrenemos 300 fusiones con el conteo del Quijote (tarda unos segundos):
fusiones, tokens_bpe = entrenar_bpe(conteo, 300)
print("Primeras fusiones:")
print(["".join(par) for par in fusiones[:12]])
for p in ["quijote", "molinos", "computadora", "boliviano"]:
    print(f"{p:>12} -> {tokenizar_bpe(p, fusiones)}")
Primeras fusiones:
['e_', 'a_', 'o_', 's_', 'n_', 'qu', 'er', 'que_', 'es', 'en', 'de_', 'os_']
quijote -> ['quijote_']
molinos -> ['m', 'ol', 'in', 'os_']
computadora -> ['com', 'pu', 't', 'ad', 'ora_']
boliviano -> ['b', 'o', 'li', 'vi', 'an', 'o_']Las primeras fusiones son terminaciones: «e_», «a_», «o_», «s_» son letras al final de una palabra. Después llegan «qu», «que_» (la palabra más frecuente), «de_» y «os_», el plural masculino. Nadie le enseñó gramática al algoritmo: las encontró contando. «Quijote» aparece tantas veces que se volvió un solo token. «Computadora» y «boliviano» nunca aparecen en el libro, pero el BPE las arma con pedazos que sí conoce, sin perderlas como <UNK>.
¿Cuánto se acorta el texto con cada fusión? tokens_bpe lo anotó:
letras_texto = sum(len(p) + 1 for p in todas)    # letras más el «_»
por_palabra = np.array([letras_texto] + tokens_bpe) / len(todas)
print(f"Sin fusiones: {por_palabra[0]:.2f} tokens por palabra")
print(f"Con 300: {por_palabra[-1]:.2f} tokens por palabra")

plt.plot(range(len(por_palabra)), por_palabra, color="C0")
plt.xlabel("Número de fusiones")
plt.ylabel("Tokens por palabra")
plt.title("Más fusiones, menos tokens")
plt.show()
Sin fusiones: 5.30 tokens por palabra
Con 300: 2.08 tokens por palabra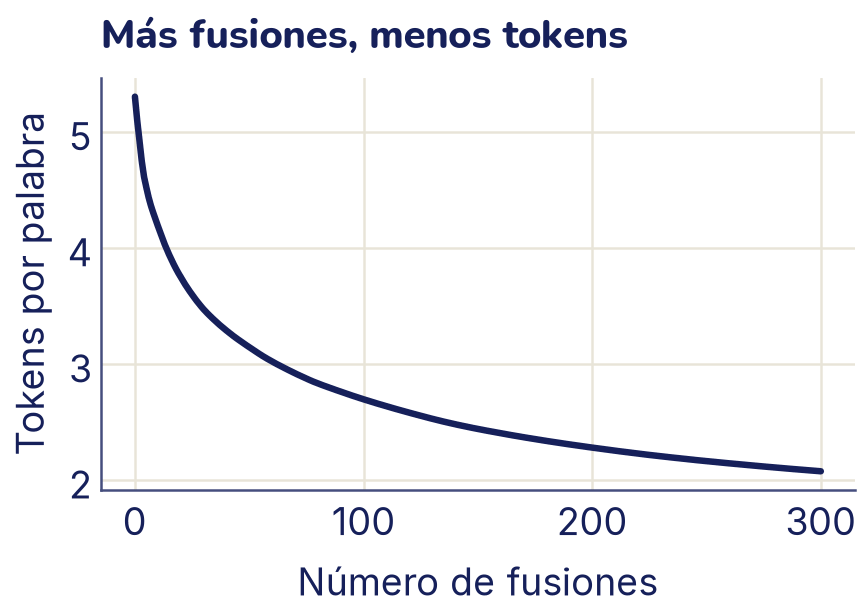
Sin fusiones, cada palabra ocupa 5,3 tokens (sus letras más el «_»). Las primeras fusiones acortan mucho el texto porque juntan los pares más comunes; las siguientes ayudan cada vez menos. Cada fusión agrega un token al vocabulario: es la misma balanza de la actividad. Los tokenizadores de los modelos reales hacen decenas de miles de fusiones sobre textos enormes.
Tokenizadores de verdad
Los modelos de lenguaje traen su propio tokenizador, entrenado junto con el modelo. Hugging Face es un sitio que reúne miles de modelos y datasets públicos; cada uno tiene un nombre de la forma «usuario/modelo», como openai-community/gpt2. Su librería transformers los carga con from_pretrained, que la primera vez los descarga de internet y los guarda en la computadora, y las siguientes los lee de ahí. Los tokenizadores se cargan con AutoTokenizer.
En Colab, transformers ya viene instalada, pero puede ser una versión anterior a la 5, que es la que usa esta ruta desde aquí hasta el tema 25. En una celda aparte, al principio del cuaderno, ejecuta !pip install -U "transformers>=5" (-U actualiza lo que ya está instalado). Si ya habías importado transformers, reinicia la sesión del cuaderno. Para ver qué versión tienes: import transformers y print(transformers.__version__). Comparemos dos: el de GPT-2 (un BPE; licencia MIT) y el de DistilBERT (WordPiece, una variante parecida; licencia Apache-2.0). Solo se descarga el tokenizador, que pesa menos de 2 MB.
from transformers import AutoTokenizer

tok_gpt2 = AutoTokenizer.from_pretrained("openai-community/gpt2")
tok_bert = AutoTokenizer.from_pretrained(
    "distilbert/distilbert-base-uncased")
print(f"Vocabulario de GPT-2: {len(tok_gpt2):,}   "
      f"de DistilBERT: {len(tok_bert):,}")

es = "Mañana iré a la panadería con mi hermano."
print(" ".join(tok_gpt2.tokenize(es)))
print(" ".join(tok_bert.tokenize(es)))
ids = tok_gpt2(es)["input_ids"]
print(ids[:6])
print([tok_gpt2.decode([i]) for i in ids[:6]])
Vocabulario de GPT-2: 50,257 de DistilBERT: 30,522
Ma ñ ana Ġir é Ġa Ġla Ġpan ader ÃŃa Ġcon Ġmi Ġher man o .
mana ##na ir ##e a la pan ##ade ##ria con mi herman ##o .
[21467, 12654, 2271, 4173, 2634, 257]
['Ma', 'ñ', 'ana', ' ir', 'é', ' a']Hay mucho que leer en esas dos líneas:
- GPT-2 marca con «Ġ» el espacio que va antes de una palabra. Además trabaja con bytes, no con letras. La computadora guarda cada carácter como uno o más bytes (números de 0 a 255); la forma más común de hacerlo se llama UTF-8 (la del
encoding="utf-8"del tema 2). En UTF-8, las letras del inglés ocupan 1 byte, y la «ñ» y las letras con tilde ocupan 2. GPT-2 muestra cada byte por separado, y por eso la «ñ» y la «é» se ven como «Ã±» y «Ã©»: no es un error. Al decodificar cada ID se recupera el texto normal: «Ma», «ñ», «ana». Gracias a los bytes, GPT-2 nunca tiene un token desconocido. - DistilBERT (la versión uncased) pasa todo a minúsculas y quita las tildes: «mañana» se volvió «mana» + «##na» e «iré», «ir» + «##e». Los «##» marcan un pedazo que continúa la palabra anterior. Para el inglés da lo mismo, pero en español ese tokenizador ya no distingue «él» de «el».
- Los dos se entrenaron sobre todo con texto en inglés, así que parten las palabras españolas en muchos pedazos: «panadería» son tres tokens.
Contemos los tokens de la misma frase en español y su traducción al inglés con los cinco tokenizadores que tenemos:
en = "Tomorrow I will go to the bakery with my brother."
nombres = ["Palabras", "Caracteres", "Nuestro BPE", "GPT-2",
           "DistilBERT"]

def contar_tokens(texto):
    """Cuántos tokens da cada tokenizador para un texto."""
    bpe = sum(len(tokenizar_bpe(p, fusiones)) for p in palabras(texto))
    return [len(palabras(texto)), len(texto), bpe,
            len(tok_gpt2.tokenize(texto)), len(tok_bert.tokenize(texto))]

n_es, n_en = contar_tokens(es), contar_tokens(en)
for nombre, a, b in zip(nombres, n_es, n_en):
    print(f"{nombre:<12} español: {a:>3}   inglés: {b:>3}")

# Solo para dibujar: barras de los dos idiomas, una al lado de la otra
y = np.arange(len(nombres))
plt.barh(y - 0.2, n_es, height=0.4, color="C0", label="Español")
plt.barh(y + 0.2, n_en, height=0.4, color="C2", label="Inglés")
plt.yticks(y, nombres)
plt.gca().invert_yaxis()
plt.xlabel("Número de tokens")
plt.title("Cinco tokenizadores")
plt.legend()
plt.show()
Palabras español: 8 inglés: 10
Caracteres español: 41 inglés: 49
Nuestro BPE español: 19 inglés: 33
GPT-2 español: 16 inglés: 11
DistilBERT español: 14 inglés: 11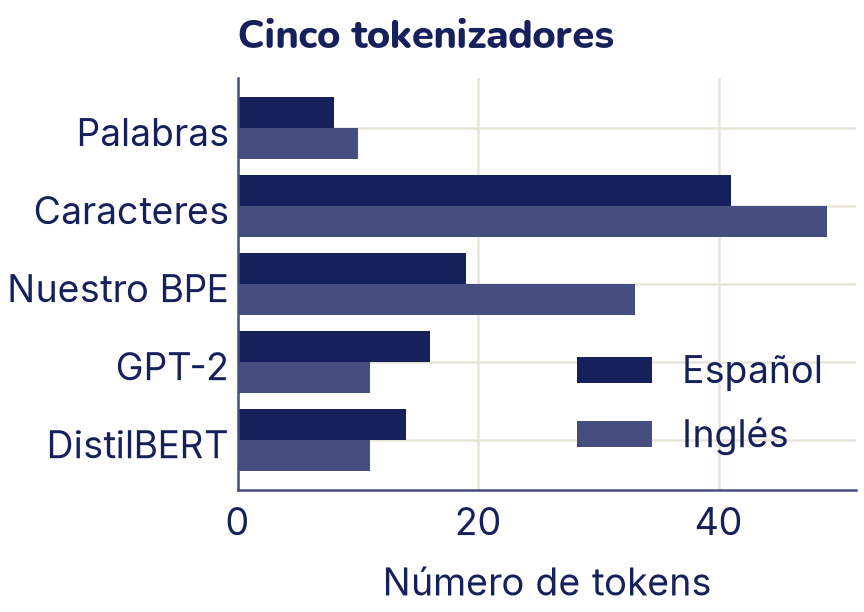
Cada tokenizador funciona mejor en el idioma con que se entrenó. Nuestro BPE, que solo vio el Quijote, parte la frase en inglés en 33 tokens y la española en 19. GPT-2 y DistilBERT, que aprendieron de textos sobre todo en inglés, hacen lo contrario. Esto importa: un modelo tiene un largo máximo de tokens y cobra (en tiempo o en dinero) por token, así que el mismo texto en español le sale más caro.
Un modelo de lenguaje con n-gramas
Un modelo de lenguaje asigna probabilidades a la palabra que viene: después de «don», ¿qué es más probable, «Quijote» o «pescado»? Es la idea detrás de los LLM del tema 24, pero empezamos con la versión más simple: contar.
Un n-grama es una secuencia de n tokens seguidos. Un modelo de bigramas (n = 2) estima la probabilidad de una palabra mirando solo la anterior:
Para medir el modelo de forma honesta separamos el libro en tres partes, como en el tema 7: entrenamos con el primer 80 %, usamos el 10 % siguiente como validación (para comparar modelos y elegir hiperparámetros) y guardamos el último 10 % como prueba, para una sola medición final. Las palabras que aparecen menos de dos veces en el entrenamiento pasan a ser <UNK>:
corte_ent = int(0.8 * len(todas))
corte_val = int(0.9 * len(todas))
entren = todas[:corte_ent]
valid = todas[corte_ent:corte_val]
prueba = todas[corte_val:]
vocab_ng = {p for p, n in Counter(entren).items() if n >= 2}

def con_unk(tokens):
    return [t if t in vocab_ng else "<UNK>" for t in tokens]

entren, valid, prueba = con_unk(entren), con_unk(valid), con_unk(prueba)
V = len(vocab_ng) + 1
print(f"Vocabulario: {V:,}   desconocidas en la validación: "
      f"{valid.count('<UNK>') / len(valid):.1%}")
Vocabulario: 10,207 desconocidas en la validación: 6.3%Hay un problema: muchos bigramas de la validación nunca aparecieron en el entrenamiento, y la fórmula les daría probabilidad 0. Un modelo que dice «imposible» ante algo que sí pasa es infinitamente malo (más abajo verás por qué). La solución que usamos es mezclar: la probabilidad final es un 60 % la del bigrama y un 40 % la de la palabra sola (el unigrama, que solo cuenta cuántas veces aparece la palabra en todo el entrenamiento). A cada palabra sola le sumamos 1 a su cuenta, para que ninguna quede en cero. Ese 0,6 es un hiperparámetro, lam en el código (por λ, lambda).
Por ejemplo, para «quijote» después de «don»: el bigrama da la proporción de veces que a «don» le sigue «quijote», y el unigrama, la proporción de todas las palabras del entrenamiento que son «quijote». La mezcla es 0,6 × bigrama + 0,4 × unigrama:
def contar_ngramas(tokens, n):
    """Cuenta los n-gramas y sus contextos (los n - 1 tokens de antes)."""
    ngramas = Counter(tuple(tokens[i:i + n])
                      for i in range(len(tokens) - n + 1))
    contextos = Counter()
    for ng, c in ngramas.items():
        contextos[ng[:-1]] += c
    return ngramas, contextos

cuentas = {n: contar_ngramas(entren, n) for n in (1, 2, 3)}

def probabilidad(contexto, palabra, lam=0.6):
    """P(palabra | contexto), mezclando con un contexto más corto."""
    if not contexto:
        ngramas, _ = cuentas[1]
        return (ngramas[(palabra,)] + 1) / (len(entren) + V)
    ngramas, contextos = cuentas[len(contexto) + 1]
    c = contextos[contexto]
    directa = ngramas[contexto + (palabra,)] / c if c else 0
    # Aquí la función se llama a sí misma, con una palabra menos
    return (lam * directa
            + (1 - lam) * probabilidad(contexto[1:], palabra, lam))

ngramas2, contextos2 = cuentas[2]
bigrama = ngramas2[("don", "quijote")] / contextos2[("don",)]
unigrama = probabilidad((), "quijote")
print(f"bigrama {bigrama:.3f}   unigrama {unigrama:.4f}")
print(f"mezcla: {probabilidad(('don',), 'quijote'):.3f}")
bigrama 0.838 unigrama 0.0054
mezcla: 0.505Después de «don», el bigrama da 0,838: casi siempre viene «quijote». El unigrama da apenas 0,0054, porque «quijote» es una entre muchísimas palabras del libro. La mezcla es 0,6 × 0,838 + 0,4 × 0,0054 ≈ 0,505.
probabilidad recibe el contexto como una tupla de palabras: ("don",) para un bigrama, () (vacía) para el unigrama. Fíjate en la última línea de la función: probabilidad se llama a sí misma, con el contexto una palabra más corto (contexto[1:] quita la primera). A eso se le llama recursión. Para un bigrama, el contexto ("don",) se acorta a (), y con el contexto vacío la función ya no se llama otra vez: devuelve la probabilidad del unigrama y ahí termina. Para un trigrama pasa lo mismo con un paso más: mezcla con el bigrama, que a su vez mezcla con el unigrama. Así, la misma función sirve para cualquier n.
¿Cómo se mide si un modelo de lenguaje es bueno? Con lo sorprendido que queda con cada palabra del texto que no vio. Si el modelo le daba a la palabra que vino probabilidad P, su sorpresa es −ln P: vale 0 si estaba seguro (P = 1) y crece mientras menos la esperaba. Por ejemplo, si a tres palabras les daba 0,5, 0,1 y 0,01, sus sorpresas son 0,69, 2,30 y 4,61; el promedio es 2,53, y e2,53 ≈ 12,6. Esa última cuenta, la exponencial del promedio de las sorpresas, es la perplejidad:
Es la entropía cruzada del tema 8, promediada sobre las palabras, con una exponencial al final. Se interpreta así: una perplejidad de 200 significa que el modelo duda, en promedio, como si tuviera que elegir entre 200 palabras igual de probables (en el ejemplo, como entre unas 13). Más baja es mejor. Un modelo que no sabe nada y reparte la probabilidad por igual entre las 10 207 palabras tiene perplejidad 10 207. Y si el modelo diera P = 0 a una sola palabra que sí aparece, ln 0 = −∞: la sorpresa sería infinita y arruinaría el promedio. Por eso nunca se puede dar probabilidad 0, y por eso mezclamos. En el código, np.log es el logaritmo natural, el que en el colegio se escribe ln, y np.exp(x) es ex.
Comparemos el unigrama y el bigrama en la validación:
def perplejidad(tokens, n, lam=0.6):
    log_total = 0
    for i in range(n - 1, len(tokens)):
        contexto = tuple(tokens[i - n + 1:i])
        log_total += np.log(probabilidad(contexto, tokens[i], lam))
    return np.exp(-log_total / (len(tokens) - n + 1))

for n in (1, 2):
    print(f"n = {n}: perplejidad {perplejidad(valid, n):.0f}")
n = 1: perplejidad 469
n = 2: perplejidad 210Mirar solo la palabra anterior baja la perplejidad de 469 a 210: el contexto ayuda muchísimo. Elegimos el bigrama, y recién ahora lo medimos, una sola vez, en la prueba:
print(f"Bigrama en la prueba: perplejidad {perplejidad(prueba, 2):.0f}")Bigrama en la prueba: perplejidad 207En la prueba da 207, casi lo mismo que en la validación: es lo que se puede esperar del modelo con texto que nunca vio.
¿Qué aprendió el modelo? Veamos las palabras más probables después de «don» y de «sancho», contando en el entrenamiento:
for previa in ["don", "sancho"]:
    siguientes = Counter({ng[1]: c for ng, c in ngramas2.items()
                          if ng[0] == previa})
    total = contextos2[(previa,)]
    print(previa, "->", [(p, round(c / total, 2))
                         for p, c in siguientes.most_common(4)])
don -> [('quijote', 0.84), ('fernando', 0.06), ('luis', 0.02), ('diego', 0.01)]
sancho -> [('que', 0.14), ('panza', 0.13), ('y', 0.08), ('dijo', 0.05)]Después de «don», el 84 % de las veces viene «quijote». Después de «sancho», «que» (14 %) y «panza» (13 %) casi empatan: mirando una sola palabra, el modelo no sabe si viene el apellido o el resto de la frase. Con estas probabilidades el modelo puede generar texto: se elige la siguiente palabra al azar según sus probabilidades, se agrega, y se repite.
rng = np.random.default_rng(0)
texto = ["dijo"]
for _ in range(14):
    siguientes = [(ng[1], c) for ng, c in ngramas2.items()
                  if ng[0] == texto[-1]]
    opciones = [p for p, c in siguientes]
    pesos = np.array([c for p, c in siguientes], dtype=float)
    texto.append(rng.choice(opciones, p=pesos / pesos.sum()))
print(" ".join(texto))
dijo sancho y de la dura la tenía las espaldas subamos donde se quiebre puesCada par de palabras vecinas tiene sentido, pero la frase entera no: el modelo solo recuerda una palabra hacia atrás. En el ejercicio 4 vas a probar con trigramas y verás por qué recordar más no es tan fácil con un solo libro. Los modelos del tema 24 resuelven ese problema con redes neuronales y la atención del tema 23.
Bolsa de palabras y TF-IDF
Volvamos a la pregunta del principio: clasificar textos. La regresión logística necesita que cada texto sea un vector del mismo largo, pero los textos tienen largos distintos. La bolsa de palabras resuelve esto así: una columna por cada palabra del vocabulario, y en cada fila, cuántas veces aparece esa palabra en ese texto. El orden se pierde; es como vaciar las palabras en una bolsa y contarlas. CountVectorizer de scikit-learn lo hace en una línea (también pasa a minúsculas y parte en palabras por su cuenta):
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

frases = ["el perro come pan",
          "el gato come pescado",
          "el perro y el gato duermen"]
bolsa = CountVectorizer()
X_bolsa = bolsa.fit_transform(frases)
print(pd.DataFrame(X_bolsa.toarray(),
                   columns=bolsa.get_feature_names_out()))
come duermen el gato pan perro pescado
0 1 0 1 0 1 1 0
1 1 0 1 1 0 0 1
2 0 1 2 1 0 1 0Cada frase es ahora una fila de 7 números. En un corpus (una colección grande de textos) real hay miles de columnas, casi todas en cero para cada texto; scikit-learn guarda esas tablas en un formato disperso (sparse) que solo anota los valores que no son cero, y toarray() las convierte en una tabla normal para mirarlas.
El problema de contar es que «el» aparece en todas las frases y pesa tanto como «pescado», que es mucho más informativa. TF-IDF corrige eso: multiplica la frecuencia de la palabra en el texto (TF, term frequency) por un factor que es mayor cuanto menos documentos la contienen (IDF, inverse document frequency). Con n documentos, de los cuales df(t) contienen la palabra t, scikit-learn usa:
Después divide cada fila por su norma (la longitud del vector, √(suma de cuadrados), del tema 3), para que todas midan 1 y un texto largo no gane solo por tener más palabras.
from sklearn.feature_extraction.text import TfidfVectorizer

tfidf = TfidfVectorizer()
X_tfidf = tfidf.fit_transform(frases)
print(pd.DataFrame(X_tfidf.toarray(),
                   columns=tfidf.get_feature_names_out()).round(2))
come duermen el gato pan perro pescado
0 0.48 0.00 0.37 0.00 0.63 0.48 0.00
1 0.48 0.00 0.37 0.48 0.00 0.00 0.63
2 0.00 0.53 0.63 0.40 0.00 0.40 0.00En la primera frase las cuatro palabras aparecen una vez, pero no pesan lo mismo: «pan», que está en un solo documento, pesa 0,63; «come» y «perro», que están en dos, 0,48; y «el», que está en los tres, 0,37. En la tercera, «el» aparece dos veces y pesa 0,63, apenas más que «duermen» (0,53), que aparece una sola vez pero solo en esa frase.
Naive Bayes: contar palabras con la regla de Bayes
Antes de llevar estos vectores a la regresión logística, probemos un clasificador que no necesita descenso de gradiente: solo cuenta. Se llama Naive Bayes (en español, Bayes ingenuo) y es la regla de Bayes del tema 5 aplicada a palabras.
Queremos P(positiva | texto): la probabilidad de que una reseña sea positiva sabiendo qué palabras tiene. La regla de Bayes la calcula a partir de la probabilidad «al revés», la del texto sabiendo la clase:
- P(clase) es la probabilidad previa (en inglés, prior): qué fracción de los textos de entrenamiento es de esa clase.
- P(texto | clase) dice qué tan probable es ese texto entre los textos de esa clase.
- P(texto) es el mismo número para las dos clases. Para saber cuál gana basta comparar los numeradores; si queremos probabilidades, al final se divide cada numerador entre la suma de los dos, para que sumen 1.
El problema es P(texto | clase): esa reseña exacta casi seguro nunca apareció en el entrenamiento, así que no se puede contar. Aquí entra la suposición ingenua: dentro de cada clase, cada palabra aparece independiente de las demás. Entonces la probabilidad del texto es el producto de las probabilidades de sus palabras: P(«buena comida» | positiva) ≈ P(buena | positiva) · P(comida | positiva). La suposición es falsa (waste y money suelen ir juntas, y not cambia el sentido de la palabra que le sigue), pero para decidir entre dos clases funciona sorprendentemente bien. Como en la bolsa de palabras, el orden no importa: Naive Bayes usa justamente las cuentas de CountVectorizer.
P(palabra | clase) sí se puede contar: de todas las palabras de los textos de esa clase, qué fracción es esa palabra. Pero si una palabra nunca apareció en una clase, su probabilidad sería 0, y un solo 0 en el producto anula el texto entero. Es el mismo problema del modelo de n-gramas, y la solución es la que usamos ahí con el unigrama: sumar 1 a cada cuenta, y sumar V (el tamaño del vocabulario) al total, para que las probabilidades de todas las palabras sigan sumando 1. Ese «sumar 1» se llama suavizado de Laplace:
Aquí cuenta(w, c) es cuántas veces aparece la palabra w en todos los textos de la clase c, y total(c) cuántas palabras tienen esos textos en total.
Falta un detalle. Un texto largo multiplica cientos de probabilidades pequeñas, y el producto se vuelve tan chico que la computadora lo redondea a 0 (lo viste en el tema 5). Por eso se trabaja con logaritmos, que convierten el producto en una suma. El puntaje de cada clase es:
donde xw es cuántas veces aparece la palabra w en el texto, es decir, la fila del texto en la bolsa de palabras: una palabra que aparece dos veces suma dos veces. Gana la clase con el puntaje más alto.
Probémoslo con seis opiniones cortas de un restaurante, escritas para este ejemplo: tres positivas (1) y tres negativas (0). Con la bolsa de palabras en una matriz X (una fila por texto) y las clases en y, entrenar es contar:
mini = ["muy buena la comida", "buena atención y buena comida",
        "excelente lugar, muy limpio", "comida fría y mala atención",
        "muy caro y sucio", "mala comida, nunca más"]
y_mini = np.array([1, 1, 1, 0, 0, 0])
cv_mini = CountVectorizer()
X_mini = cv_mini.fit_transform(mini).toarray()

def entrenar_nb(X, y, alpha=1):
    """Devuelve ln P(clase) y ln P(palabra | clase) para las clases 0 y 1."""
    # (y == c) vale 1 en las filas de la clase c y 0 en las demás: el
    # producto X.T @ (y == c) suma la columna de cada palabra en esas filas
    cuentas = np.array([X.T @ (y == c) for c in (0, 1)])
    # keepdims=True deja el resultado como columna, de forma (2, 1)
    totales = cuentas.sum(axis=1, keepdims=True)
    log_p_palabra = np.log((cuentas + alpha)
                           / (totales + alpha * X.shape[1]))
    # np.bincount(y) cuenta cuántas veces aparece 0, 1, ... en y
    log_prior = np.log(np.bincount(y) / len(y))
    return log_prior, log_p_palabra

def puntajes_nb(X, log_prior, log_p_palabra):
    """Una fila por texto y una columna por clase."""
    return log_prior + X @ log_p_palabra.T

prior_mini, log_p_mini = entrenar_nb(X_mini, y_mini)
print("Vocabulario:", X_mini.shape[1], "palabras")
for p in ["buena", "mala", "caro", "comida"]:
    neg, pos = np.exp(log_p_mini[:, cv_mini.vocabulary_[p]])
    print(f"{p:<7} P(· | negativa) = {neg:.3f}   "
          f"P(· | positiva) = {pos:.3f}")
Vocabulario: 14 palabras
buena P(· | negativa) = 0.040 P(· | positiva) = 0.154
mala P(· | negativa) = 0.120 P(· | positiva) = 0.038
caro P(· | negativa) = 0.080 P(· | positiva) = 0.038
comida P(· | negativa) = 0.120 P(· | positiva) = 0.115alpha es lo que se suma a cada cuenta: con alpha=1, el suavizado de Laplace. Como en el tema 5, np.log es el logaritmo natural, ln, y np.exp lo deshace. CountVectorizer ignora las palabras de una sola letra, como «y», así que las tres negativas suman 11 palabras y las tres positivas 12. «buena» aparece 3 veces en las positivas: (3 + 1)/(12 + 14) ≈ 0,154. En las negativas no aparece nunca, pero gracias al suavizado no queda en 0: (0 + 1)/(11 + 14) = 0,04. «comida», que está en los dos lados, tiene casi la misma probabilidad en ambos: no ayuda a decidir.
Ahora clasifiquemos una opinión nueva, y comparemos con MultinomialNB de scikit-learn, que es este mismo modelo (con alpha=1 por defecto):
from sklearn.naive_bayes import MultinomialNB

nueva = cv_mini.transform(["buena comida pero caro"]).toarray()
puntajes = puntajes_nb(nueva, prior_mini, log_p_mini)[0]
print("Puntajes (negativa, positiva):", puntajes.round(2))
prob = np.exp(puntajes) / np.exp(puntajes).sum()
print("Nuestro Naive Bayes:", prob.round(3))

nb_mini = MultinomialNB(alpha=1).fit(X_mini, y_mini)
print("MultinomialNB:      ", nb_mini.predict_proba(nueva)[0].round(3))
print("¿Mismas ln P(palabra | clase)?",
      np.allclose(nb_mini.feature_log_prob_, log_p_mini))
Puntajes (negativa, positiva): [-8.56 -7.98]
Nuestro Naive Bayes: [0.36 0.64]
MultinomialNB: [0.36 0.64]
¿Mismas ln P(palabra | clase)? True«pero» no está en el vocabulario, así que no cuenta. «buena» empuja hacia positiva, «caro» hacia negativa y «comida» casi no mueve nada; gana positiva con 0,64. Los puntajes son logaritmos de números muy chicos (por eso son negativos); np.exp los devuelve a probabilidades y dividir entre la suma es el paso de dividir entre P(texto). MultinomialNB da exactamente lo mismo: por dentro guarda feature_log_prob_, las mismas ln P(palabra | clase) que calculamos nosotros. Se llama «multinomial» porque modela las cuentas de cada palabra.
Naive Bayes entrena en un instante y casi no tiene nada que ajustar. Por eso es una buena línea base (en inglés, baseline): el modelo simple contra el que se compara cualquier modelo más elaborado. Si un modelo complicado no le gana a la línea base, no vale la pena. En la sección siguiente lo ponemos frente a la regresión logística con reseñas reales.
Clasificar reseñas
Ahora sí, con datos reales. Usamos Amazon Polarity (fancyzhx/amazon_polarity en Hugging Face; licencia Apache-2.0 según su ficha; armado por Zhang, Zhao y LeCun en 2015 a partir de reseñas recopiladas por McAuley y Leskovec en 2013). Son reseñas reales de productos de Amazon, cada una marcada como positiva (1) o negativa (0). Están en inglés: no encontramos un conjunto de reseñas en español con una licencia clara para usarlo aquí. Como son reales, alguna puede tener lenguaje ofensivo.
Bajamos solo el archivo de prueba del dataset (400 000 reseñas, unos 117 MB) y tomamos al azar 6000, para que todo corra en segundos. hf_hub_download baja un archivo de Hugging Face y devuelve dónde lo guardó. El archivo está en formato parquet, una tabla comprimida, como un CSV más eficiente, y load_dataset lo lee:
from datasets import load_dataset
from huggingface_hub import hf_hub_download

ruta = hf_hub_download("fancyzhx/amazon_polarity",
                       "amazon_polarity/test-00000-of-00001.parquet",
                       repo_type="dataset")
# split="train" es solo el nombre que load_dataset le da a un archivo
# suelto: nosotros mismos lo dividimos después en entrenamiento y prueba
resenas = load_dataset("parquet", data_files=ruta, split="train")
muestra = resenas.shuffle(seed=0).select(range(6000))

textos = [f"{t}. {c}" for t, c in zip(muestra["title"],
                                      muestra["content"])]
etiquetas = np.array(muestra["label"])
print(f"{len(resenas):,} reseñas; usamos {len(textos):,}")
print("Positivas:", etiquetas.sum(), "  negativas:",
      (etiquetas == 0).sum())
print(etiquetas[0], textos[0][:70])
400,000 reseñas; usamos 6,000
Positivas: 2965 negativas: 3035
1 Very Awesome!. My son is very happy to have this game! It was used butJuntamos el título y el texto de cada reseña. Como en el tema 7, primero separamos un 20 % como prueba, que no se toca hasta el final, y del resto apartamos otro 20 % como validación, para comparar modelos. Hay dos candidatos, cada uno en un Pipeline del tema 10: Naive Bayes con las cuentas de CountVectorizer, como línea base, y la regresión logística con TfidfVectorizer. Los dos usan min_df=2, que ignora las palabras que aparecen en un solo documento, como el minimo de nuestro vocabulario. Cada pipeline aprende el vocabulario (y los IDF) solo con los textos que recibe en fit: así no hay fuga de datos.
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline

X_ent, X_pru, y_ent, y_pru = train_test_split(
    textos, etiquetas, test_size=0.2, random_state=0, stratify=etiquetas)
X_sub, X_val, y_sub, y_val = train_test_split(
    X_ent, y_ent, test_size=0.2, random_state=0, stratify=y_ent)
print(f"Entrenamiento: {len(X_sub)}   validación: {len(X_val)}   "
      f"prueba: {len(X_pru)}")

candidatos = {
    "Naive Bayes": make_pipeline(CountVectorizer(min_df=2),
                                 MultinomialNB()),
    "Logística": make_pipeline(TfidfVectorizer(min_df=2),
                               LogisticRegression(max_iter=1000)),
}
for nombre, m in candidatos.items():
    m.fit(X_sub, y_sub)
    print(f"{nombre:<12} exactitud en la validación "
          f"{m.score(X_val, y_val):.3f}")
Entrenamiento: 3840 validación: 960 prueba: 1200
Naive Bayes exactitud en la validación 0.830
Logística exactitud en la validación 0.847La línea base, que solo cuenta, ya acierta el 83,0 % de las 960 reseñas de validación; la logística llega al 84,7 %. Una razón de la diferencia: la logística ajusta todos los pesos a la vez, así que si dos palabras casi siempre van juntas, como waste y money, puede repartir el peso entre ellas. Naive Bayes, en cambio, las cree independientes y cuenta dos veces la misma evidencia.
¿Nuestro Naive Bayes de NumPy hace lo mismo con 3840 reseñas? Usamos las cuentas que aprendió el primer paso del pipeline:
# nb_pipe[0] es el primer paso del pipeline (CountVectorizer)
nb_pipe = candidatos["Naive Bayes"]
C_sub = nb_pipe[0].transform(X_sub)
C_val = nb_pipe[0].transform(X_val)
prior_res, log_p_res = entrenar_nb(C_sub, y_sub)
# argmax(axis=1): en cada fila, la columna (la clase) de mayor puntaje
nuestras = puntajes_nb(C_val, prior_res, log_p_res).argmax(axis=1)
print("¿Las mismas predicciones que MultinomialNB?",
      (nuestras == nb_pipe.predict(X_val)).all())
¿Las mismas predicciones que MultinomialNB? TrueLas mismas 960 predicciones: MultinomialNB es contar, sumar 1 y sumar logaritmos.
Elegimos la logística. Recién ahora la entrenamos con todo el entrenamiento (las 4800 reseñas, validación incluida) y la medimos, una sola vez, en la prueba:
from sklearn.metrics import confusion_matrix

modelo = make_pipeline(TfidfVectorizer(min_df=2),
                       LogisticRegression(max_iter=1000))
modelo.fit(X_ent, y_ent)
# modelo[0] es el primer paso del pipeline (TF-IDF); modelo[1], la logística
print(f"Vocabulario aprendido: {len(modelo[0].vocabulary_):,} palabras")
print(f"Exactitud en la prueba: {modelo.score(X_pru, y_pru):.3f}")
print(confusion_matrix(y_pru, modelo.predict(X_pru)))
Vocabulario aprendido: 10,508 palabras
Exactitud en la prueba: 0.854
[[531 76]
[ 99 494]]Con 4800 reseñas de entrenamiento, el modelo acierta el 85,4 % de las 1200 de prueba. Como las clases están equilibradas, un modelo que adivina siempre lo mismo acertaría alrededor del 50 %. La matriz de confusión (filas: la clase real; columnas: la predicha, como en el tema 9) muestra errores parecidos en las dos direcciones: 76 negativas tomadas por positivas y 99 positivas tomadas por negativas.
Una ventaja de la regresión logística es que se puede leer. Cada palabra del vocabulario tiene un peso: si es positivo, la palabra empuja hacia «reseña positiva»; si es negativo, hacia «negativa».
pesos = modelo[1].coef_[0]
vocab_tfidf = modelo[0].get_feature_names_out()
orden = np.argsort(pesos)
elegidas = np.concatenate([orden[:6], orden[-6:]])
print("Más negativas:", list(vocab_tfidf[orden[:6]]))
print("Más positivas:", list(vocab_tfidf[orden[-6:][::-1]]))

# Tinta para las negativas y coral para las positivas
colores = ["C0"] * 6 + ["C1"] * 6
# Una figura más alta, para que las 12 palabras no se encimen
plt.figure(figsize=(4.8, 4.6))
plt.barh(range(12), pesos[elegidas], color=colores)
plt.yticks(range(12), vocab_tfidf[elegidas])
plt.axvline(0, color="C2", linewidth=1)
plt.xlabel("Peso en la regresión logística")
plt.title("Las palabras que más pesan")
plt.show()
Más negativas: ['not', 'waste', 'money', 'boring', 'poor', 'worst']
Más positivas: ['great', 'excellent', 'easy', 'best', 'and', 'perfect']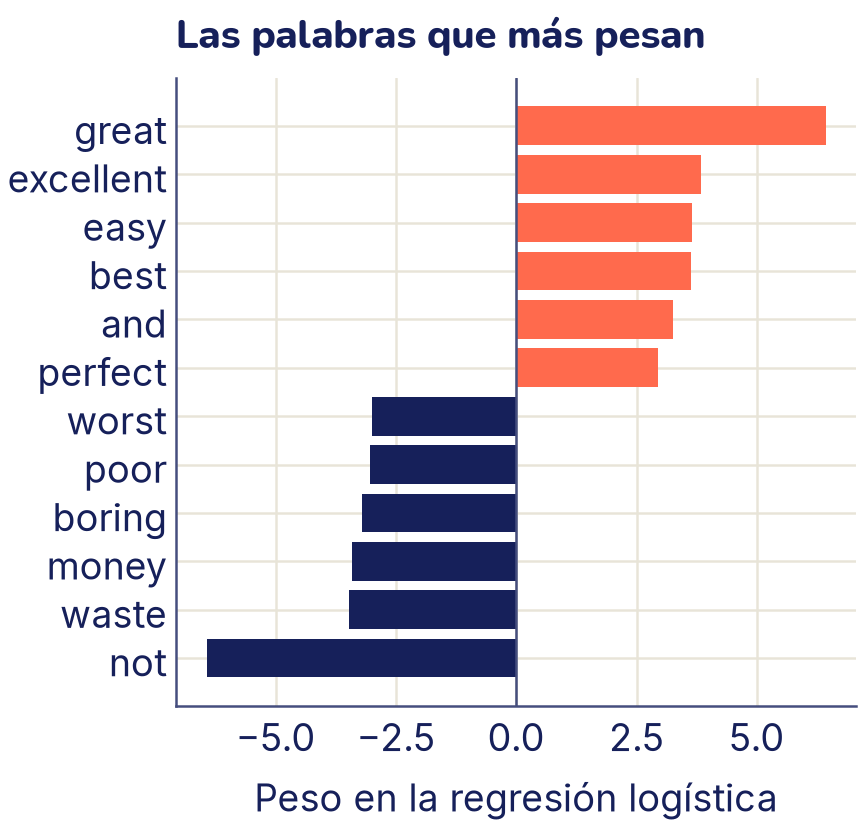
Las palabras están en inglés porque las reseñas lo están: el modelo solo puede aprender pesos para las palabras que vio. Great (genial), excellent (excelente), best (lo mejor) y perfect (perfecto) empujan hacia positiva; waste (desperdicio), boring (aburrido), poor (malo) y worst (lo peor) hacia negativa. Money aparece por frases como waste of money (plata tirada). Not (no) es la más negativa de todas: las quejas suelen negar («not worth it», «does not work»). Pero ojo: en una bolsa de palabras, «not bad» (nada mal) también suma el peso negativo de not. Y and (y), que no significa nada bueno ni malo, recibe un peso positivo: el modelo no entiende significados, solo encontró que en estas reseñas esa palabra ayuda a separar las clases.
¿Qué pasa con textos nuevos?
nuevas = ["Great book, I loved every page.",
          "It broke after two days. Waste of money.",
          "Me encantó, es un libro excelente."]
for texto, p in zip(nuevas, modelo.predict_proba(nuevas)[:, 1]):
    # .nnz cuenta los valores que no son cero: las palabras conocidas
    conocidas = modelo[0].transform([texto]).nnz
    print(f"P(positiva) = {p:.2f}   conocidas: {conocidas:>2}   {texto}")
P(positiva) = 0.96 conocidas: 5 Great book, I loved every page.
P(positiva) = 0.03 conocidas: 8 It broke after two days. Waste of money.
P(positiva) = 0.43 conocidas: 3 Me encantó, es un libro excelente.Las dos reseñas en inglés se clasifican bien y con seguridad. La reseña en español es claramente positiva, pero el modelo solo reconoce 3 de sus palabras y responde 0,43, cerca del 50 %: no tiene idea. Un clasificador de bolsa de palabras solo sabe del idioma y del vocabulario con que se entrenó. Para clasificar en español habría que entrenarlo con reseñas en español; en el tema 25 verás modelos preentrenados que llegan con más idioma aprendido.
Lotes de largo variable: padding y máscara
TF-IDF convierte cada texto en un vector del mismo largo, pero pierde el orden. Las redes neuronales de los temas que siguen leen el texto en orden, como una secuencia de IDs. Y en PyTorch se entrena por lotes (tema 18): un lote es un tensor, y un tensor tiene que ser rectangular. Si las frases tienen largos distintos, no se pueden apilar:
import torch
from torch.nn.utils.rnn import pad_sequence

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

lote_frases = ["En un lugar de la Mancha",
               "Sancho comió pan",
               "Don Quijote vio molinos de viento"]
secuencias = [torch.tensor(codificar(palabras(f), vocab))
              for f in lote_frases]
print([len(s) for s in secuencias])
torch.stack(secuencias)
[6, 3, 6]
Traceback (most recent call last):
...
RuntimeError: stack expects each tensor to be equal size, but got [6] at entry 0 and [3] at entry 1La solución es el padding (relleno): alargar las secuencias cortas con un token de relleno, <PAD>, hasta el largo de la más larga. Por eso reservamos el ID 0 para él. pad_sequence de PyTorch lo hace por nosotros. Además se arma una máscara: un tensor del mismo tamaño con 1 (o True) donde hay un token real y 0 donde hay relleno, para que el modelo sepa qué posiciones ignorar.
lote = pad_sequence(secuencias, batch_first=True,
                    padding_value=vocab["<PAD>"]).to(device)
mascara = lote != vocab["<PAD>"]
print(lote.shape)
print(lote.tolist())
print(mascara.int().tolist())
torch.Size([3, 6])
[[7, 28, 122, 3, 5, 223], [23, 6350, 588, 0, 0, 0], [18, 22, 166, 2290, 3, 816]]
[[1, 1, 1, 1, 1, 1], [1, 1, 1, 0, 0, 0], [1, 1, 1, 1, 1, 1]]# Solo para dibujar: el lote y la máscara como dos tablas
from matplotlib.colors import ListedColormap
inverso = {i: p for p, i in vocab.items()}
# Papel para el relleno y tinta para los tokens reales
papel_tinta = ListedColormap(["C3", "C0"])
fig, (arriba, abajo) = plt.subplots(2, 1)
for eje, valores in [(arriba, lote), (abajo, mascara.int())]:
eje.imshow(mascara.cpu(), cmap=papel_tinta, aspect="auto")
for i in range(lote.shape[0]):
for j in range(lote.shape[1]):
v = valores[i, j].item()
txt = inverso[v] if eje is arriba else str(v)
eje.text(j, i, txt, ha="center", va="center", fontsize=12,
color="white" if mascara[i, j] else "C0")
eje.set_xticks([])
eje.set_yticks([])
eje.grid(False)
arriba.set_title("El lote con padding")
abajo.set_title("Máscara: 1 = real, 0 = relleno")
plt.show()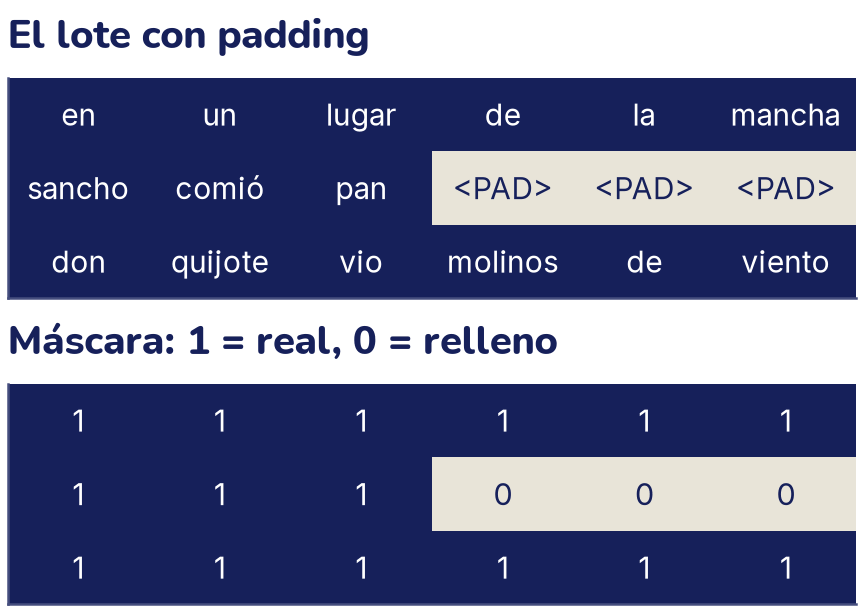
El lote tiene forma (3, 6): 3 frases de 6 tokens. La máscara es lo que permite, por ejemplo, promediar solo los tokens reales (tema 22) o que la atención no mire el relleno (tema 23). Si una frase es demasiado larga, se hace lo contrario: se trunca, cortándola en un largo máximo.
Los tokenizadores de Hugging Face hacen todo esto de una vez. Con padding=True rellenan, con truncation=True y max_length truncan, y devuelven la máscara con el nombre attention_mask:
x_bert = tok_bert(lote_frases, padding=True, truncation=True,
                  max_length=8, return_tensors="pt")
print(x_bert["input_ids"].shape)
for fila, mask in zip(x_bert["input_ids"], x_bert["attention_mask"]):
    print(" ".join(tok_bert.convert_ids_to_tokens(fila)))
    print(mask.tolist())
torch.Size([3, 8])
[CLS] en un lu ##gar de la [SEP]
[1, 1, 1, 1, 1, 1, 1, 1]
[CLS] san ##cho com ##io pan [SEP] [PAD]
[1, 1, 1, 1, 1, 1, 1, 0]
[CLS] don qui ##jo ##te vi ##o [SEP]
[1, 1, 1, 1, 1, 1, 1, 1]DistilBERT agrega sus tokens especiales: [CLS] al principio, [SEP] al final y [PAD] como relleno. Con max_length=8, la primera y la tercera frase se truncaron (se perdieron «mancha» y el final de la tercera), y la segunda recibió un relleno, marcado con 0 en su máscara.
Lo que aprendiste y lo que sigue
- Tokenizar es partir el texto en pedazos. Por palabras, las secuencias son cortas pero el vocabulario es enorme y las palabras nuevas se pierden como
<UNK>. Por caracteres, nunca hay desconocidos pero las secuencias son largas. BPE junta los pares más frecuentes y queda en el medio: más fusiones, menos tokens y más vocabulario. - Normalizar (minúsculas, tildes, puntuación) es una decisión: en español, quitar las tildes confunde palabras distintas.
- La ley de Zipf: pocas palabras llenan la mayor parte del texto y casi la mitad del vocabulario aparece una sola vez.
- Un modelo de lenguaje da probabilidades a la palabra siguiente. Los n-gramas las estiman contando, y la perplejidad mide qué tan sorprendido queda el modelo con texto nuevo.
- Naive Bayes aplica la regla de Bayes suponiendo que las palabras son independientes dentro de cada clase: basta contar, sumar 1 (suavizado de Laplace) y sumar logaritmos. Es una buena línea base.
- La bolsa de palabras y TF-IDF convierten cada texto en un vector del mismo largo, y con regresión logística clasifican reseñas con 85 % de exactitud. Los pesos se pueden leer, y solo valen para el idioma con que se entrenó.
- Para pasar secuencias a una red, se rellenan con padding hasta el mismo largo y se acompañan de una máscara.
En el tema 22 los IDs dejan de ser simples números: cada token se convierte en un vector aprendido, un embedding, donde las palabras parecidas quedan cerca.