La pregunta
Dos estudiantes se preparan para el mismo examen con la misma lista de 50 problemas resueltos. Una se aprende de memoria las 50 respuestas. El otro entiende cómo se resuelve cada tipo de problema. Si el examen trae exactamente esos 50 problemas, a los dos les va perfecto. Pero el examen trae problemas nuevos. ¿A quién le va mejor?
Con los modelos pasa lo mismo. En el tema 6 mediste el error del modelo de diabetes con los mismos pacientes con que lo entrenaste, y avisamos que eso era hacerse trampa: es corregir el examen con las preguntas que el modelo ya vio resueltas. Un modelo sirve si acierta en datos que nunca vio. A eso se le llama generalizar, y este tema trata de cómo medirlo y cómo lograrlo.
En este tema vas a:
- dividir los datos en entrenamiento, validación y prueba, y saber para qué sirve cada parte;
- reconocer el subajuste y el sobreajuste en las curvas de error;
- aplicar la validación cruzada k-fold para elegir un modelo sin depender de la suerte de una sola división;
- usar Ridge (L2) y Lasso (L1), y explicar por qué Lasso deja coeficientes exactamente en cero.
Necesitas lo del tema 6: el modelo ŷ = w·x + b, el MSE, la interfaz fit y predict de scikit-learn y la estandarización.
Actividad: ¿memoriza o aprende?
Los puntos llenos son los datos de entrenamiento: con ellos se ajusta la curva. Los puntos huecos son datos de validación: salen de la misma regla, pero el modelo no los ve al entrenar. La curva es un polinomio: con grado 1 es una recta, con grado 2 una parábola, y con grados más altos puede doblarse más veces. Las dos barras miden el error (el MSE) con cada grupo de puntos.
¿Memoriza o aprende?
Este es el estado inicial (grado 1, sin castigo). Con JavaScript activado puedes cambiar el grado, λ y los datos.
Grado 1, sin castigo. Error de entrenamiento 0,218, error de validación 0,336.
Prueba esto, en orden:
- Empieza en grado 1. ¿La recta sigue la forma de los puntos? ¿Las dos barras son altas o bajas?
- Sube el grado de a uno hasta 15. Mira la barra de entrenamiento: ¿alguna vez sube? Mira la de validación: ¿qué hace al principio y qué hace al final?
- Con grado 15, pulsa «Nuevos datos» varias veces. Las curvas claras son los ajustes con los datos anteriores. ¿Cuánto cambia la curva de un sorteo a otro? Haz lo mismo con grado 3.
- Deja el grado en 15 y sube λ (lambda) poco a poco. ¿Qué le pasa a la curva y a la barra de validación? ¿Y si subes λ al máximo?
- Activa «Ver la regla verdadera». ¿Qué grado y qué λ la imitan mejor?
Acabas de ver la idea central del tema: que un modelo se equivoque poco con los datos que vio no prueba que haya aprendido; puede haberlos memorizado. El error que importa es el de los datos nuevos, y hay dos perillas para controlarlo: la complejidad del modelo (el grado) y la regularización (λ).
Datos de una regla conocida
Como en el tema 6, empezamos con datos sintéticos: los fabricamos con una regla conocida, una onda y = sen(x), más un ruido al azar. Así podemos comparar lo que aprende el modelo con la verdad.
Y desde el principio, antes de entrenar nada, separamos los datos en tres grupos:
| Grupo | Para qué sirve | Cuándo se usa |
|---|---|---|
| Entrenamiento | Ajustar los parámetros del modelo (con fit) |
Siempre que se entrena |
| Validación | Comparar modelos y elegir sus perillas (el grado, λ) | Muchas veces, mientras se decide |
| Prueba | Estimar cómo le irá al modelo elegido con datos nuevos | Una sola vez, al final |
train_test_split de scikit-learn mezcla los datos al azar y los parte en dos. Lo usamos dos veces: primero apartamos la prueba, y del resto sacamos la validación. Su argumento random_state es la semilla de la mezcla: con la misma semilla, la misma división.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split

# Semilla fija: cada vez que corras esto saldrán los mismos datos
rng = np.random.default_rng(1)
n = 40
x = rng.uniform(-3, 3, size=n)
# La regla «secreta»: una onda, más un ruido que nadie puede predecir
y = np.sin(x) + rng.normal(0, 0.3, size=n)
X = x.reshape(-1, 1)                  # scikit-learn quiere una tabla

# Primero se aparta la prueba (10 puntos): no se toca hasta el final
X_resto, X_prueba, y_resto, y_prueba = train_test_split(
    X, y, test_size=10, random_state=0)
# Del resto, 10 puntos para validación y 20 para entrenar
X_ent, X_val, y_ent, y_val = train_test_split(
    X_resto, y_resto, test_size=10, random_state=0)

print("Entrenamiento:", len(X_ent), "  validación:", len(X_val),
      "  prueba:", len(X_prueba))
Entrenamiento: 20 validación: 10 prueba: 10¿Por qué tres grupos y no dos? Porque cada vez que miras el error de validación para decidir algo, ese grupo deja de ser del todo «nuevo»: lo estás usando para elegir. Si eliges entre muchos modelos, alguno va a tener suerte con esos diez puntos. La prueba queda guardada para el final, para tener una medida honesta del modelo que elegiste.
Polinomios: una perilla de complejidad
Una recta no puede seguir una onda. Para doblar la curva usamos un polinomio de grado g:
El truco es que esto sigue siendo una regresión lineal: es lineal en los parámetros w. Basta con inventar columnas nuevas, x², x³, …, y dárselas a LinearRegression como si fueran características distintas. PolynomialFeatures hace exactamente eso:
from sklearn.preprocessing import PolynomialFeatures

# Las potencias de x, de 1 a 3, para x = 2 y x = 3
potencias = PolynomialFeatures(degree=3, include_bias=False)
print(potencias.fit_transform([[2], [3]]))
[[ 2. 4. 8.]
[ 3. 9. 27.]]Con x = 3 y grado 15, la última columna vale 3¹⁵, más de 14 millones, mientras que la primera vale 3. Columnas con escalas tan distintas son un problema: lo viste en el tema 6 con el valle alargado, y aquí además hacen inexactas las cuentas de la computadora. Por eso, después de calcular las potencias, las estandarizamos con StandardScaler (media 0 y desviación 1, como en los temas 5 y 6).
Para no repetir los tres pasos cada vez, los encadenamos con make_pipeline. El resultado se usa como cualquier modelo: fit calcula las potencias, aprende la media y la desviación de cada columna con los datos de entrenamiento y ajusta la regresión; predict aplica los mismos pasos a datos nuevos. (En el tema 10 vas a ver los pipelines con más detalle.)
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.metrics import mean_squared_error

def polinomio(grado):
    """Regresión polinomial: potencias de x, estandarizar, recta."""
    return make_pipeline(PolynomialFeatures(grado, include_bias=False),
                         StandardScaler(), LinearRegression())

# Una cuadrícula fina de x para dibujar las curvas
x_dib = np.linspace(-3, 3, 300).reshape(-1, 1)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for eje, grado in zip(ejes.flat, [1, 3, 9, 15]):
    modelo = polinomio(grado).fit(X_ent, y_ent)
    e_ent = mean_squared_error(y_ent, modelo.predict(X_ent))
    e_val = mean_squared_error(y_val, modelo.predict(X_val))
    print(f"Grado {grado:2d}:  MSE entrenamiento = {e_ent:.3f}"
          f"   MSE validación = {e_val:.3f}")
    # Solo el grado que mejor generaliza va resaltado (color "C1")
    color = "C1" if grado == 3 else "C0"
    eje.scatter(X_ent, y_ent, s=14, color="C0")
    eje.scatter(X_val, y_val, s=14, facecolors="none", edgecolors="C2")
    eje.plot(x_dib, modelo.predict(x_dib), color=color)
    eje.set_title(f"Grado {grado}")
    eje.set_ylim(-2, 2)
for eje in ejes[1]:
    eje.set_xlabel("x")
for eje in ejes[:, 0]:
    eje.set_ylabel("y")
plt.show()
Grado 1: MSE entrenamiento = 0.232 MSE validación = 0.292
Grado 3: MSE entrenamiento = 0.037 MSE validación = 0.029
Grado 9: MSE entrenamiento = 0.031 MSE validación = 0.059
Grado 15: MSE entrenamiento = 0.014 MSE validación = 1.253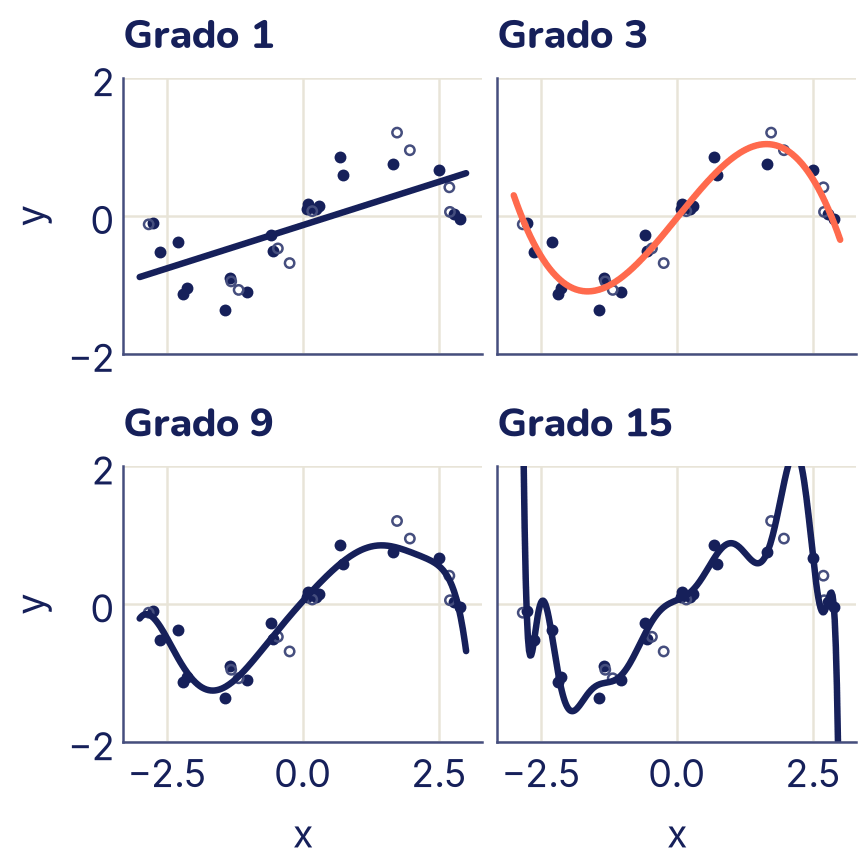
Los números y los dibujos cuentan la misma historia:
- Grado 1, subajuste. La recta es demasiado simple para una onda. Se equivoca mucho con los dos grupos de puntos: no le alcanza ni para los datos que vio. Se dice que el modelo tiene sesgo alto (ojo: es otro sentido de la palabra, no el intercepto b del tema 6; aquí «sesgo» es un error sistemático por usar un modelo demasiado rígido).
- Grado 3, buen ajuste. Sigue la forma de la onda y se equivoca parecido con los puntos que vio y con los nuevos.
- Grado 15, sobreajuste. Tiene el error más chico con los puntos de entrenamiento, pero el más grande con los de validación. Se retorció para pasar cerca de cada punto lleno, incluido su ruido. Memorizó en lugar de aprender la forma.
La curva en forma de U
Probemos todos los grados del 1 al 15 y guardemos los dos errores:
grados = range(1, 16)
err_ent, err_val = [], []
for grado in grados:
    modelo = polinomio(grado).fit(X_ent, y_ent)
    err_ent.append(mean_squared_error(y_ent, modelo.predict(X_ent)))
    err_val.append(mean_squared_error(y_val, modelo.predict(X_val)))

mejor = grados[np.argmin(err_val)]
print("Grado con menor error de validación:", mejor)
for grado in [1, 3, 6, 12, 15]:
    print(f"Grado {grado:2d}:  entrenamiento {err_ent[grado - 1]:.3f}"
          f"   validación {err_val[grado - 1]:.3f}")

plt.plot(grados, err_ent, color="C2", marker="o")
plt.plot(grados, err_val, color="C0", marker="o")
plt.scatter([mejor], [min(err_val)], color="C1", s=160, zorder=3)
plt.yscale("log")
plt.ylim(0.006, 4)
# Nombres escritos junto a cada curva, en lugar de una leyenda
plt.text(15, 1.8, "Validación", ha="right")
plt.text(15, 0.008, "Entrenamiento", ha="right", color="C2")
plt.text(3.4, 0.016, "el mejor grado")
plt.xlabel("Grado del polinomio")
plt.ylabel("MSE (escala logarítmica)")
plt.title("Error según la complejidad")
plt.show()
Grado con menor error de validación: 3
Grado 1: entrenamiento 0.232 validación 0.292
Grado 3: entrenamiento 0.037 validación 0.029
Grado 6: entrenamiento 0.031 validación 0.054
Grado 12: entrenamiento 0.016 validación 0.951
Grado 15: entrenamiento 0.014 validación 1.253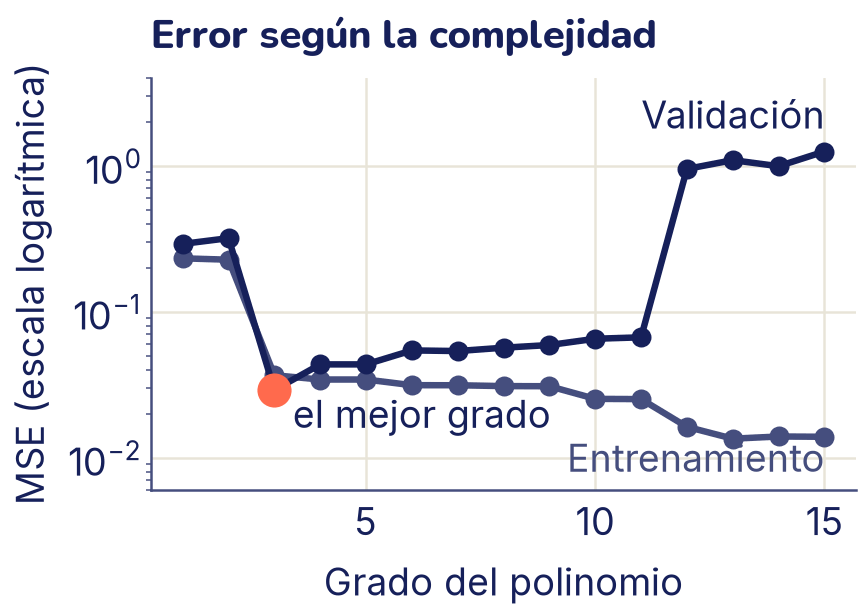
Esta es la figura más importante del tema. Fíjate en tres cosas:
- El error de entrenamiento casi no deja de bajar. Cada grado nuevo agrega una perilla, y con más perillas siempre se puede pasar igual o más cerca de los puntos que se ven. Por eso el error de entrenamiento no sirve para elegir el grado: siempre elegiría el más alto.
- El error de validación forma una U. A la izquierda, el modelo es demasiado simple (subajuste). A la derecha, es tan flexible que memoriza el ruido (sobreajuste). El fondo de la U es el mejor equilibrio.
- La distancia entre las dos curvas es el síntoma del sobreajuste. Si el error de entrenamiento es mucho menor que el de validación, el modelo se está aprendiendo los datos de memoria.
Una curva de validación es justamente esto: el error de entrenamiento y el de validación frente a una perilla del modelo. scikit-learn la calcula con validation_curve; aquí la programamos con un bucle para ver cada paso.
Sesgo y varianza
El botón «Nuevos datos» de la actividad mostraba otra cara del sobreajuste: el modelo de grado 15 cambiaba muchísimo de un sorteo de datos a otro. Midámoslo. Vamos a sacar 200 muestras distintas de 20 puntos de la misma regla, a entrenar con cada una y a mirar qué predice cada modelo en x = 2, donde la verdad es sen(2) ≈ 0,91.
def nuevos_datos(semilla, n=20):
    """Otra muestra de la misma regla: sen(x) más ruido."""
    r = np.random.default_rng(semilla)
    x_n = r.uniform(-3, 3, size=n)
    return x_n.reshape(-1, 1), np.sin(x_n) + r.normal(0, 0.3, size=n)

x0 = [[2.0]]                          # el punto donde miramos
for grado in [1, 3, 15]:
    preds = []
    for semilla in range(200):
        X_n, y_n = nuevos_datos(semilla)
        modelo = polinomio(grado).fit(X_n, y_n)
        preds.append(modelo.predict(x0)[0])
    preds = np.array(preds)
    print(f"Grado {grado:2d}:  mediana {np.median(preds):5.2f}"
          f"   la mitad central entre {np.percentile(preds, 25):5.2f}"
          f" y {np.percentile(preds, 75):5.2f}")
Grado 1: mediana 0.69 la mitad central entre 0.57 y 0.81
Grado 3: mediana 0.98 la mitad central entre 0.89 y 1.04
Grado 15: mediana 0.95 la mitad central entre 0.54 y 1.29Usamos la mediana y la «mitad central» (del percentil 25 al 75) en lugar de la media y la desviación estándar, porque unas pocas predicciones del grado 15 son tan disparatadas que arruinarían el promedio. Esos números muestran las dos formas de equivocarse:
- Sesgo: el grado 1 se equivoca de forma sistemática. Sea cual sea la muestra, predice algo lejos de 0,91: una recta no puede imitar una onda. Más datos no lo arreglan.
- Varianza: el grado 15 tiene la mediana cerca de la verdad, pero cada muestra lo lleva a un lugar distinto. Su predicción depende tanto de los puntos que le tocaron que no se puede confiar en ninguna en particular.
- El grado 3 tiene poco de los dos.
Un modelo demasiado simple tiene sesgo alto; uno demasiado flexible para la cantidad de datos que tiene, varianza alta. Bajar uno suele subir el otro: es el equilibrio entre sesgo y varianza, y el fondo de la U es donde está mejor repartido. Más datos ayudan con la varianza (lo verás en la curva de aprendizaje); el sesgo solo se arregla con un modelo más flexible.
Validación cruzada k-fold
Nuestro conjunto de validación tiene solo 10 puntos. Si la división al azar hubiera sido otra, el error de validación habría salido distinto, y quizás hasta otro grado ganador. Veámoslo con el grado 3 y cinco semillas de división:
for semilla in range(5):
    Xe, Xv, ye, yv = train_test_split(X_resto, y_resto, test_size=10,
                                      random_state=semilla)
    modelo = polinomio(3).fit(Xe, ye)
    print(f"random_state={semilla}:  MSE de validación = "
          f"{mean_squared_error(yv, modelo.predict(Xv)):.3f}")
random_state=0: MSE de validación = 0.029
random_state=1: MSE de validación = 0.061
random_state=2: MSE de validación = 0.055
random_state=3: MSE de validación = 0.027
random_state=4: MSE de validación = 0.047El mismo modelo, con los mismos datos, recibe una nota u otra según la suerte de la división: la peor es más del doble de la mejor. La validación cruzada k-fold reparte esa suerte:
- Se parten los datos (sin la prueba) en k grupos del mismo tamaño, llamados folds.
- Se entrena k veces: cada vez, un grupo distinto hace de validación y los otros k − 1 de entrenamiento.
- Se promedian los k errores de validación.
Así cada punto se usa una vez para validar y el resultado ya no depende de una sola división. Lo más común es k = 5 o k = 10. El precio es entrenar k veces.
KFold define los grupos (con shuffle=True los mezcla antes, con su propia semilla) y cross_val_score hace todo el ciclo. Por una convención de scikit-learn, siempre maximiza sus puntajes, así que el MSE viene con el signo cambiado: "neg_mean_squared_error". Le volvemos a cambiar el signo para leerlo.
from sklearn.model_selection import KFold, cross_val_score

cinco = KFold(n_splits=5, shuffle=True, random_state=0)

resultados = []
for grado in grados:
    puntajes = cross_val_score(polinomio(grado), X_resto, y_resto,
                               cv=cinco, scoring="neg_mean_squared_error")
    resultados.append(-puntajes.mean())     # el MSE, con su signo

grado_cv = grados[np.argmin(resultados)]
for grado in [1, 2, 3, 4, 8, 15]:
    print(f"Grado {grado:2d}:  MSE de validación cruzada = "
          f"{resultados[grado - 1]:.3f}")
print("Grado elegido por validación cruzada:", grado_cv)
Grado 1: MSE de validación cruzada = 0.296
Grado 2: MSE de validación cruzada = 0.307
Grado 3: MSE de validación cruzada = 0.045
Grado 4: MSE de validación cruzada = 0.048
Grado 8: MSE de validación cruzada = 0.069
Grado 15: MSE de validación cruzada = 20.008
Grado elegido por validación cruzada: 3La validación cruzada usó los 30 puntos que no son de prueba, en cinco rondas de 24 para entrenar y 6 para validar. Elige el grado 3, el mismo que eligió nuestra validación de 10 puntos, pero ahora con más respaldo.
Recién ahora, con el grado decidido, usamos la prueba, una sola vez. Entrenamos el modelo elegido con todos los datos que no son de prueba y medimos:
final = polinomio(grado_cv).fit(X_resto, y_resto)
error_prueba = mean_squared_error(y_prueba, final.predict(X_prueba))
print(f"Grado {grado_cv}, MSE con los datos de prueba: {error_prueba:.3f}")
# El MSE de la regla verdadera, sen(x), con estos mismos 10 puntos
print(f"MSE de sen(x) con los datos de prueba: "
      f"{mean_squared_error(y_prueba, np.sin(X_prueba[:, 0])):.3f}")
Grado 3, MSE con los datos de prueba: 0.044
MSE de sen(x) con los datos de prueba: 0.055Para comparar, calculamos también el error de la regla verdadera, sen(x), que conocemos solo porque fabricamos los datos. Ni ella llega a cero: el ruido no se puede predecir. Como el ruido tiene una desviación de 0,3, ningún modelo puede bajar, en promedio y con muchos datos nuevos, de un MSE de 0,3² = 0,09. Ese piso se llama error irreducible. Aquí los dos números salieron por debajo de 0,09, y el polinomio hasta le ganó por poco a la regla verdadera: con solo diez puntos de prueba, también hay suerte. Lo que sí dicen es que el grado 3 se equivoca con datos nuevos tanto como la verdad misma, que es lo mejor que se puede pedir.
Regularización: castigar los pesos grandes
Elegir un grado bajo es una forma de evitar el sobreajuste. Hay otra que permite usar un modelo flexible sin que se descontrole: la regularización. La idea es cambiar lo que el entrenamiento minimiza. Además de equivocarse poco, le pedimos al modelo que sus pesos sean chicos:
Esto se llama Ridge o regularización L2 (por la suma de cuadrados de los pesos). El número λ (lambda) dice cuánto pesa el castigo: con λ = 0 es la regresión de siempre; con λ muy grande, lo más barato es dejar todos los pesos casi en cero, y la curva se vuelve casi plana. El intercepto b no se castiga: solo mueve la curva arriba o abajo y no la hace más retorcida.
¿Por qué pesos chicos dan curvas más suaves? La curva de grado 15 sin regularizar logra pasar cerca de cada punto sumando potencias con pesos enormes, de signos opuestos, que casi se cancelan; donde dejan de cancelarse, la curva se dispara. Con el castigo, esos pesos enormes salen caros.
En scikit-learn el modelo se llama Ridge y λ se llama alpha. (scikit-learn escribe la pérdida con constantes un poco distintas, así que el valor de alpha no es exactamente el mismo λ; la idea es la misma.)
from sklearn.linear_model import Ridge

def polinomio_ridge(grado, alpha):
    """Como polinomio(), pero con Ridge en lugar de LinearRegression."""
    return make_pipeline(PolynomialFeatures(grado, include_bias=False),
                         StandardScaler(), Ridge(alpha=alpha))

for alpha in [0.001, 0.01, 0.1, 1, 10, 100]:
    modelo = polinomio_ridge(15, alpha).fit(X_ent, y_ent)
    e_ent = mean_squared_error(y_ent, modelo.predict(X_ent))
    e_val = mean_squared_error(y_val, modelo.predict(X_val))
    print(f"alpha = {alpha:7}:  entrenamiento {e_ent:.3f}"
          f"   validación {e_val:.3f}")

sin_reg = polinomio(15).fit(X_ent, y_ent)
con_reg = polinomio_ridge(15, 0.1).fit(X_ent, y_ent)
plt.scatter(X_ent, y_ent, s=18, color="C0")
plt.scatter(X_val, y_val, s=18, facecolors="none", edgecolors="C2")
plt.plot(x_dib, sin_reg.predict(x_dib), color="C2",
         label="Sin regularizar")
plt.plot(x_dib, con_reg.predict(x_dib), color="C1",
         label="Ridge, alpha = 0,1")
# Más espacio arriba, para la leyenda
plt.ylim(-2, 3.2)
plt.xlabel("x")
plt.ylabel("y")
plt.title("Grado 15, con y sin castigo")
plt.legend(loc="upper left")
plt.show()
alpha = 0.001: entrenamiento 0.028 validación 0.058
alpha = 0.01: entrenamiento 0.031 validación 0.051
alpha = 0.1: entrenamiento 0.034 validación 0.047
alpha = 1: entrenamiento 0.068 validación 0.096
alpha = 10: entrenamiento 0.192 validación 0.263
alpha = 100: entrenamiento 0.352 validación 0.467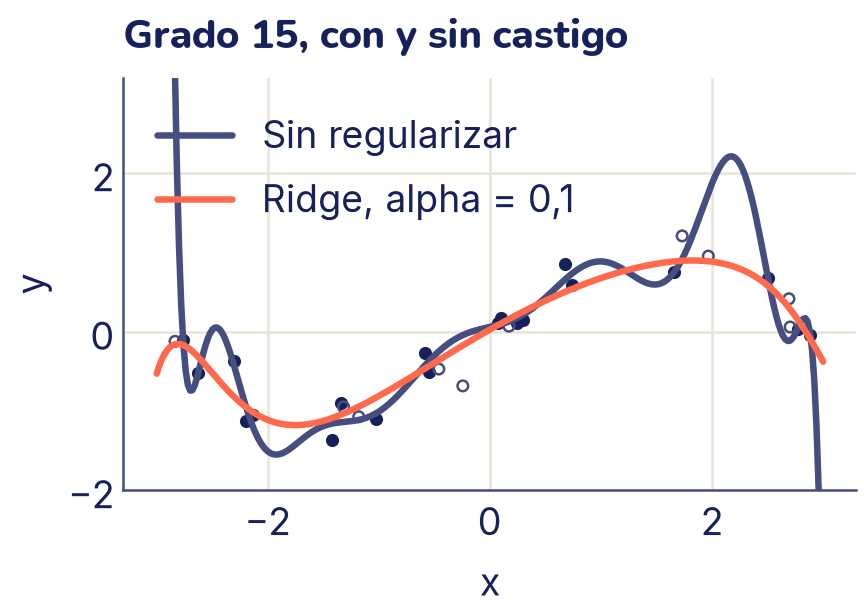
Con el mismo grado 15, Ridge da una curva suave. λ es otra perilla de complejidad, como el grado, pero continua: con alpha muy chico vuelve el sobreajuste; con alpha muy grande, el subajuste. Su valor también se elige con validación (o validación cruzada), nunca con la prueba.
Ridge y Lasso con datos reales
Volvamos al conjunto de diabetes del tema 6: 442 pacientes y 10 características. Vamos a ver qué les pasa a los 10 pesos a medida que sube alpha. Primero estandarizamos las columnas, y esto no es un detalle: el castigo trata a todos los pesos por igual, así que las columnas tienen que estar en la misma escala. Si una columna estuviera en metros y otra en milímetros, el castigo apretaría mucho más a una que a otra sin ninguna razón.
from sklearn.datasets import load_diabetes

diabetes = load_diabetes(as_frame=True)
nombres = list(diabetes.data.columns)
X_d = StandardScaler().fit_transform(diabetes.data)
y_d = diabetes.target.to_numpy()

alphas_r = np.logspace(-2, 4, 60)     # de 0,01 a 10 000
pesos_r = np.array([Ridge(alpha=a).fit(X_d, y_d).coef_ for a in alphas_r])

for i, nombre in enumerate(nombres):
    # Solo bmi va resaltado (color "C1"); las otras nueve, en "C2"
    if nombre == "bmi":
        plt.plot(alphas_r, pesos_r[:, i], color="C1", linewidth=3,
                 label="bmi")
    else:
        plt.plot(alphas_r, pesos_r[:, i], color="C2", linewidth=1.2)
plt.axhline(0, color="C0", linewidth=1)
plt.xscale("log")
plt.xlabel("alpha (escala logarítmica)")
plt.ylabel("Peso")
plt.title("Ridge: los pesos se encogen juntos")
plt.legend()
plt.show()

print("Pesos con alpha = 1000:",
      np.round(Ridge(alpha=1000).fit(X_d, y_d).coef_, 1))
Pesos con alpha = 1000: [ 1.6 -1.7 9.9 6.8 1.1 0. -5.5 4.8 8.7 4.6]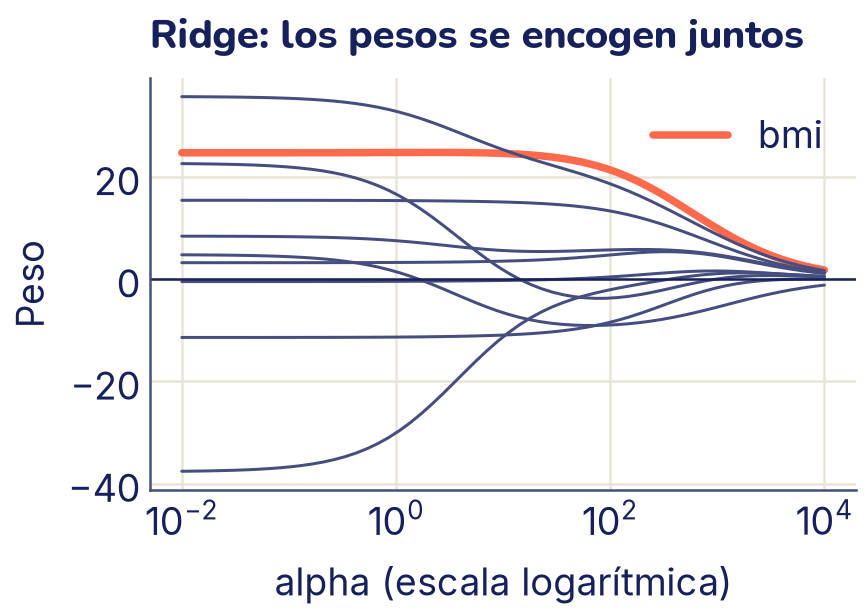
Con Ridge, todos los pesos se van encogiendo hacia cero, pero ninguno llega exactamente a cero. Ahora cambiemos una sola cosa del castigo: en lugar de los pesos al cuadrado, sus valores absolutos.
Esto es Lasso, o regularización L1. Parece un cambio menor, pero el resultado es muy distinto:
from sklearn.linear_model import Lasso

alphas_l = np.logspace(-2, 2, 60)     # de 0,01 a 100
pesos_l = np.array([Lasso(alpha=a).fit(X_d, y_d).coef_ for a in alphas_l])

for i, nombre in enumerate(nombres):
    if nombre == "bmi":
        plt.plot(alphas_l, pesos_l[:, i], color="C1", linewidth=3,
                 label="bmi")
    else:
        plt.plot(alphas_l, pesos_l[:, i], color="C2", linewidth=1.2)
plt.axhline(0, color="C0", linewidth=1)
plt.xscale("log")
plt.xlabel("alpha (escala logarítmica)")
plt.ylabel("Peso")
plt.title("Lasso: los pesos se apagan uno a uno")
plt.legend()
plt.show()

for alpha in [0.1, 1, 5, 20]:
    lasso = Lasso(alpha=alpha).fit(X_d, y_d)
    vivos = [n for n, w in zip(nombres, lasso.coef_) if w != 0]
    print(f"alpha = {alpha:4}:  {len(vivos)} pesos distintos de cero:",
          ", ".join(vivos))
alpha = 0.1: 9 pesos distintos de cero: age, sex, bmi, bp, s1, s2, s4, s5, s6
alpha = 1: 7 pesos distintos de cero: sex, bmi, bp, s1, s3, s5, s6
alpha = 5: 5 pesos distintos de cero: sex, bmi, bp, s3, s5
alpha = 20: 3 pesos distintos de cero: bmi, bp, s5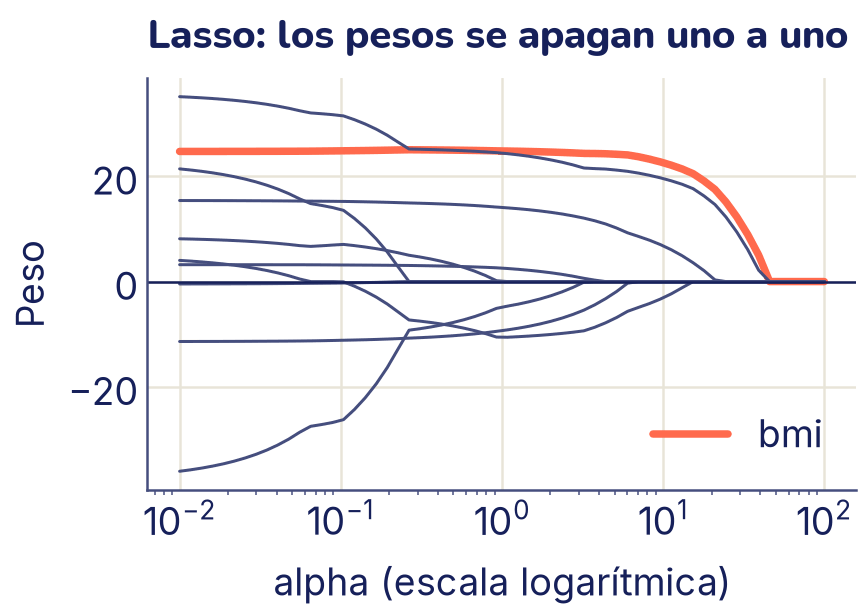
Con Lasso, los pesos no solo se encogen: se apagan, uno por uno, y quedan exactamente en cero. Un peso en cero significa que el modelo ya no usa esa característica. Por eso Lasso sirve también para elegir variables: con alpha grande, se queda solo con las que más ayudan a predecir. Aquí, las últimas en sobrevivir son bmi (índice de masa corporal) y s5 (un análisis de sangre).
¿Por qué Lasso deja pesos en cero?
Hay una forma geométrica de verlo, con un modelo de solo dos pesos, w₁ y w₂. Minimizar «MSE + λ · castigo» es parecido a minimizar el MSE con un presupuesto: los pesos no pueden salir de una región alrededor del origen. Para Ridge, la región es un círculo (w₁² + w₂² no puede pasar de cierto valor). Para Lasso, es un rombo (|w₁| + |w₂| tampoco).
El MSE, como viste en el tema 6, forma un valle con curvas de nivel en forma de elipse. La solución es el punto de la región donde el valle está más bajo: donde la región toca a la primera elipse. Probémoslo con una pérdida inventada cuyo mínimo está en (2, 1), fuera de las dos regiones. Para cada región recorremos 4000 puntos de su borde y nos quedamos con el de menor pérdida:
def perdida(w1, w2):
    """Un valle con el mínimo en (2, 1), más empinado en w1."""
    return 3 * (w1 - 2) ** 2 + (w2 - 1) ** 2

t = np.linspace(0, 2 * np.pi, 4000)
# El borde del círculo de radio 1 y el del rombo |w1| + |w2| = 1
circulo = np.cos(t), np.sin(t)
rombo = (np.cos(t) / (np.abs(np.cos(t)) + np.abs(np.sin(t))),
         np.sin(t) / (np.abs(np.cos(t)) + np.abs(np.sin(t))))

i_c = np.argmin(perdida(*circulo))
i_r = np.argmin(perdida(*rombo))
print(f"Ridge (círculo): w1 = {circulo[0][i_c]:.2f}"
      f"   w2 = {circulo[1][i_c]:.2f}")
print(f"Lasso (rombo):   w1 = {rombo[0][i_r]:.2f}"
      f"   w2 = {rombo[1][i_r]:.2f}")

W1, W2 = np.meshgrid(np.linspace(-1.5, 3, 200), np.linspace(-1.5, 2, 200))
plt.contour(W1, W2, perdida(W1, W2), levels=[0.5, 2, 4.5, 8, 12.5],
            colors="C2", linewidths=1)
plt.plot(*circulo, color="C0", linestyle="--", label="Ridge: círculo")
plt.plot(*rombo, color="C0", label="Lasso: rombo")
plt.scatter([circulo[0][i_c]], [circulo[1][i_c]], color="C0", s=80,
            zorder=3)
plt.scatter([rombo[0][i_r]], [rombo[1][i_r]], color="C1", s=140,
            zorder=4, label="Solución de Lasso: w2 = 0")
plt.scatter([2], [1], color="C0", marker="+", s=120)
plt.gca().set_aspect("equal")
plt.ylim(-1.5, 2.8)
plt.xlabel("w1")
plt.ylabel("w2")
plt.title("El rombo toca en una esquina")
plt.legend(loc="upper left", fontsize=10, frameon=True)
plt.show()
Ridge (círculo): w1 = 0.97 w2 = 0.24
Lasso (rombo): w1 = 1.00 w2 = 0.00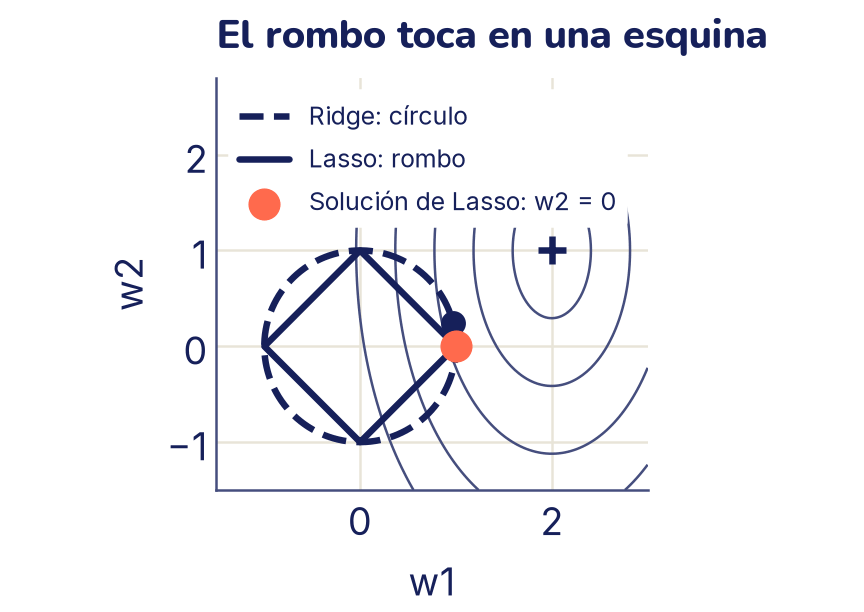
El círculo es redondo: la elipse lo toca en un punto cualquiera de su borde, donde los dos pesos suelen ser distintos de cero; solo se achican. El rombo, en cambio, tiene esquinas sobre los ejes, y las esquinas sobresalen: es muy probable que la elipse toque primero una esquina. En una esquina, uno de los pesos vale exactamente cero. Con muchas características, el «rombo» tiene muchísimas esquinas y aristas, y por eso Lasso apaga varios pesos a la vez.
Curva de aprendizaje: ¿más datos ayudarían?
Una última herramienta de diagnóstico. La curva de aprendizaje muestra el error de entrenamiento y el de validación según cuántos datos se usan para entrenar. learning_curve de scikit-learn la calcula con validación cruzada: para cada tamaño, entrena con esa cantidad de pacientes y valida con los demás.
from sklearn.model_selection import learning_curve

tamanos, p_ent, p_val = learning_curve(
    make_pipeline(StandardScaler(), LinearRegression()),
    diabetes.data, y_d, train_sizes=[15, 20, 30, 50, 100, 200, 353],
    cv=cinco, scoring="neg_mean_squared_error",
    shuffle=True, random_state=0)
mse_ent = -p_ent.mean(axis=1)         # promedio de los cinco folds
mse_val = -p_val.mean(axis=1)

for t, e, v in zip(tamanos, mse_ent, mse_val):
    print(f"{t:3d} pacientes:  entrenamiento {e:6.0f}"
          f"   validación {v:6.0f}")

plt.plot(tamanos, mse_ent, color="C2", marker="o", label="Entrenamiento")
plt.plot(tamanos, mse_val, color="C0", marker="o", label="Validación")
plt.xscale("log")
plt.yscale("log")
# Marcas legibles en el eje x: solo algunos tamaños
plt.xticks([15, 30, 100, 353], ["15", "30", "100", "353"])
plt.minorticks_off()
plt.xlabel("Pacientes para entrenar")
plt.ylabel("MSE (escala logarítmica)")
plt.title("Curva de aprendizaje: diabetes")
plt.legend()
plt.show()
15 pacientes: entrenamiento 1120 validación 10954
20 pacientes: entrenamiento 1412 validación 6822
30 pacientes: entrenamiento 1882 validación 3921
50 pacientes: entrenamiento 2347 validación 3266
100 pacientes: entrenamiento 2549 validación 3317
200 pacientes: entrenamiento 2701 validación 3124
353 pacientes: entrenamiento 2843 validación 2978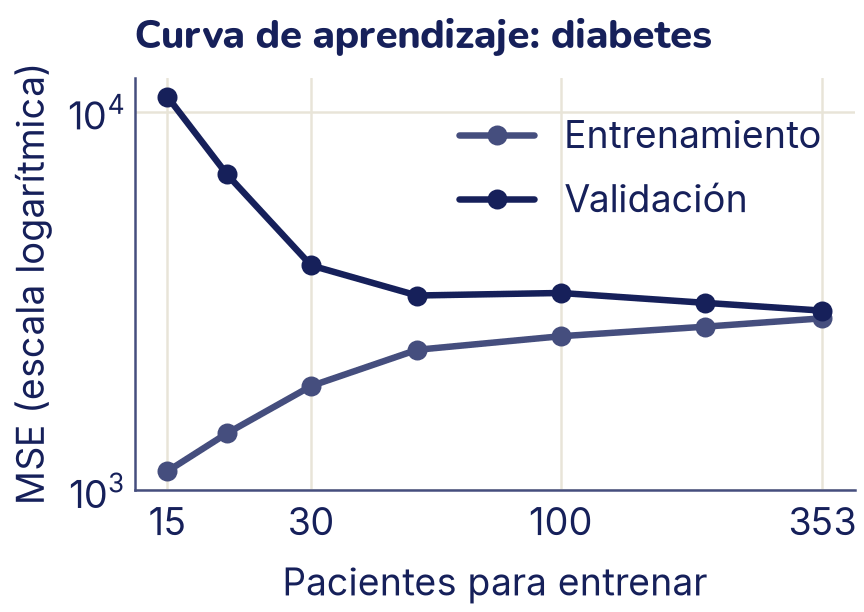
Con pocos pacientes, el modelo de 10 pesos se ajusta muy bien a los que ve y muy mal a los demás: varianza alta. A medida que hay más datos, memorizar se vuelve imposible: el error de entrenamiento sube, el de validación baja y las dos curvas se juntan. Así se lee la curva:
| Lo que ves | Diagnóstico | Qué probar |
|---|---|---|
| Las dos curvas altas y juntas | Subajuste (sesgo alto) | Un modelo más flexible o mejores características; más datos no ayudan |
| Entrenamiento bajo, validación mucho más alta, y la brecha se achica con más datos | Sobreajuste (varianza alta) | Más datos, regularizar o un modelo más simple |
| Las dos juntas y en un nivel aceptable | Buen ajuste | Nada; probar con la prueba |
En diabetes, al final las curvas casi se tocan: con 353 pacientes, un modelo lineal ya no sobreajusta, y conseguir más pacientes casi no lo mejoraría. Para bajar el error haría falta un modelo distinto o más información de cada paciente.
La receta completa con diabetes
Juntemos todo y arreglemos la trampa del tema 6. Separamos un 25 % de los pacientes para la prueba, elegimos alpha de Ridge con validación cruzada solo con el entrenamiento y medimos con la prueba una sola vez. Como el StandardScaler va dentro del pipeline, la media y la desviación también se calculan solo con el entrenamiento: los pacientes de prueba no se miran para nada hasta el final.
from sklearn.metrics import r2_score

Xd_ent, Xd_prueba, yd_ent, yd_prueba = train_test_split(
    diabetes.data, y_d, test_size=0.25, random_state=0)

# Como en el tema 6: entrenar y medir con los mismos pacientes
lineal = make_pipeline(StandardScaler(), LinearRegression())
lineal.fit(Xd_ent, yd_ent)
print(f"R² con los datos de entrenamiento: "
      f"{r2_score(yd_ent, lineal.predict(Xd_ent)):.3f}")

# Elegir alpha con validación cruzada, sin tocar la prueba
for alpha in [0.1, 1, 10, 100]:
    puntajes = cross_val_score(
        make_pipeline(StandardScaler(), Ridge(alpha=alpha)),
        Xd_ent, yd_ent, cv=cinco, scoring="r2")
    print(f"Ridge alpha = {alpha:5}:  R² de validación cruzada = "
          f"{puntajes.mean():.3f}")
R² con los datos de entrenamiento: 0.555
Ridge alpha = 0.1: R² de validación cruzada = 0.522
Ridge alpha = 1: R² de validación cruzada = 0.523
Ridge alpha = 10: R² de validación cruzada = 0.523
Ridge alpha = 100: R² de validación cruzada = 0.511# La prueba, una sola vez, con el modelo elegido
elegido = make_pipeline(StandardScaler(), Ridge(alpha=10))
elegido.fit(Xd_ent, yd_ent)
print(f"R² con los datos de prueba: "
f"{r2_score(yd_prueba, elegido.predict(Xd_prueba)):.3f}")R² con los datos de prueba: 0.358alpha = 1 y alpha = 10 empatan en la validación cruzada; elegimos 10. El R² medido con los pacientes de entrenamiento (0,555) era optimista. El de la prueba (0,358) salió más bajo incluso que el de la validación cruzada: 111 pacientes de prueba también traen su dosis de suerte, y en el ejercicio 6 vas a medir cuánto cambia con otra división. Aun así, es la única estimación que no participó en ninguna decisión, y por eso es la honesta. Fíjate también en que todas las alpha dan resultados parecidos: con 331 pacientes y solo 10 características, el modelo lineal casi no sobreajusta (lo dijo la curva de aprendizaje), así que regularizar ayuda poco. La regularización brilla cuando hay muchas características para pocos datos, como en el mini-proyecto.
Una última regla, la más importante del tema: si después de mirar la prueba vuelves a cambiar el modelo, la prueba deja de ser nueva. Su número ya no es honesto. Por eso se usa una sola vez, al final, y todas las decisiones se toman antes, con la validación.
Lo que aprendiste y lo que sigue
- Un modelo sirve si generaliza: si acierta con datos que no vio. El error de entrenamiento no lo dice; puede bajar a casi cero mientras el modelo memoriza.
- Los datos se dividen en entrenamiento (ajustar), validación (elegir) y prueba (medir una sola vez, al final).
- El error de validación frente a la complejidad forma una U: a la izquierda, subajuste (sesgo alto); a la derecha, sobreajuste (varianza alta).
- La validación cruzada k-fold promedia k divisiones distintas, para no depender de la suerte de una sola.
- Ridge (L2) encoge todos los pesos; Lasso (L1) apaga algunos exactamente en cero, por las esquinas del rombo. Los dos piden características estandarizadas.
- La curva de aprendizaje dice si conseguir más datos ayudaría.
Todo esto vale para cualquier modelo que veas desde ahora: los clasificadores del tema 8, los árboles del tema 11 y las redes neuronales, que tienen tantos parámetros que sobreajustar es su riesgo principal (tema 19).