La pregunta
Imagina que un banco usa un modelo para decidir a quién le ofrece una tarjeta de crédito. El modelo aprendió de miles de ejemplos y acierta 87 de cada 100 veces. ¿Es un buen modelo?
Con lo que sabes desde el tema 9, ya desconfías de un solo número: hay que mirar qué errores comete. Este tema agrega una pregunta más: ¿se equivoca igual con todas las personas? Un modelo puede tener muy buena exactitud y, aun así, rechazar con mucha más frecuencia a las mujeres que sí cumplían, o a las personas de un grupo que casi no aparecía en los datos. Esos errores no los paga el modelo, los pagan las personas.
Este es el último tema de la ruta. Vas a juntar todo lo que aprendiste en un proyecto completo, medido con honestidad, y a pensar en sus efectos. En este tema vas a:
- recorrer el ciclo de un proyecto: pregunta, datos, línea base, iteración y evaluación final;
- auditar un modelo por subgrupos con
pandas.groupby, con intervalos de bootstrap para saber si una diferencia es real; - medir la equidad con dos métricas, la paridad demográfica y la igualdad de oportunidades, y ver por qué, cuando los grupos son distintos, no se pueden igualar todas las métricas a la vez;
- documentar un modelo con una ficha de modelo y planificar tu proyecto final con una plantilla;
- argumentar con ejemplos concretos los riesgos de privacidad, sesgo, mal uso e impacto ambiental, y conocer qué dice hoy la normativa de Bolivia.
Necesitas las métricas del tema 9 (matriz de confusión, exhaustividad, umbral), el Pipeline del tema 10 y la importancia por permutación del tema 11.
Actividad: umbrales justos
Cuarenta personas del grupo A y cuarenta del grupo B piden un préstamo. Un modelo le da a cada una un puntaje entre 0 y 1, y cada grupo tiene su propio umbral: quien queda a su derecha es aprobado. Las figuras rellenas son las personas que sí habrían devuelto el préstamo; las huecas, las que no. El grupo A se dibuja con círculos y el B con cuadrados más claros. Los datos son sintéticos: los inventamos para que los dos grupos tengan distribuciones distintas, como pasa a menudo con datos reales. En el grupo A la mitad habría devuelto el préstamo; en el grupo B, solo una de cada cuatro, y el modelo le da puntajes más bajos.
Umbrales justos
Este es el estado inicial, con los dos umbrales en 0,5. Con JavaScript activado puedes mover cada umbral y usar los botones.
grupo A grupo B relleno: lo habría devuelto hueco: no
| Aprobación | TVP | |
|---|---|---|
| Grupo A 20 de 40 aprobados | 50 % | 80 %16 de 20 |
| Grupo B 10 de 40 aprobados | 25 % | 70 %7 de 10 |
Exactitud global: 83 %
La TVP es la tasa de verdaderos positivos: de quienes lo habrían devuelto, qué parte fue aprobada.
Mueve cada umbral, o prueba los botones: igualan el grupo B con el A.
Prueba esto, en orden:
- Con los dos umbrales en 0,5, mira la tabla. ¿Qué parte de cada grupo es aprobada? De quienes sí lo habrían devuelto, ¿qué parte es aprobada en cada grupo? Esa segunda tasa es la tasa de verdaderos positivos (TVP), la exhaustividad del tema 9 calculada dentro de cada grupo.
- Pulsa «Igualar aprobación». El umbral de B baja hasta que su tasa de aprobación queda lo más cerca posible de la de A. ¿Qué pasó con la TVP de B y con la exactitud global?
- Pulsa «Igualar oportunidades». Ahora el umbral de B se elige para que su TVP sea igual a la de A. ¿Las tasas de aprobación quedaron iguales?
- Mueve los dos umbrales como quieras e intenta igualar al mismo tiempo la aprobación y la TVP sin que la exactitud se caiga. ¿Lo consigues?
Lo que acabas de ver es el centro del tema: cuando los grupos son distintos en los datos, no se pueden igualar todas las métricas a la vez. Igualar la aprobación obliga a aprobar a más personas de B que no lo habrían devuelto; igualar las oportunidades deja tasas de aprobación distintas. Con un umbral por grupo, la aprobación y la TVP solo quedan iguales en los extremos (aprobar a casi todos o a casi nadie), donde la exactitud se desploma. Y aunque eligieras persona por persona a quién aprobar, podrías igualar la aprobación y la TVP, pero a costa de aprobar a muchos más negativos de B: su tasa de falsos positivos (TFP) quedaría distinta de la de A. Hay que elegir qué significa «justo» en cada problema y justificarlo. El resto del tema hace lo mismo con datos reales.
El ciclo de un proyecto
Todos los temas de la ruta siguieron, sin decirlo, el mismo camino. Ahora le ponemos nombre, porque es el que vas a seguir en tu proyecto final:
- La pregunta. Qué quieres predecir o descubrir, para quién y qué decisión se tomará con la respuesta. Una buena pregunta dice también qué error cuesta más (tema 9).
- Los datos. De dónde vienen, con qué licencia, cuántos son, quién aparece y quién falta. Se dividen antes de mirar demasiado: entrenamiento, validación y prueba (tema 7).
- La línea base. El modelo más simple posible: predecir siempre la clase más frecuente, el promedio, o «mañana igual que hoy» (tema 13). Todo modelo tiene que ganarle; si no, algo anda mal.
- Iterar. Probar modelos y variables midiendo en validación, y anotar cada intento en una bitácora: qué cambiaste y qué pasó.
- La evaluación final. Una sola vez, con el conjunto de prueba, cuando ya no vas a cambiar nada (temas 7 y 10). Aquí se agrega el análisis por subgrupos y la ficha del modelo.
¿Qué modelo elegir? Depende de los datos y de la máquina que tengas:
- Tablas con columnas de números y categorías: los modelos clásicos, sobre todo los árboles con boosting (tema 11), suelen ganar y entrenan en segundos.
- Texto, imágenes o audio con pocos ejemplos: un modelo preentrenado que solo se ajusta (temas 25 y 26). Entrenar desde cero una red grande con pocos datos casi nunca funciona.
- Entrenar desde cero (temas 18 a 20) tiene sentido cuando los datos son muchos y muy distintos de los que vio cualquier modelo preentrenado, o cuando el modelo es pequeño.
Con poca máquina, que es lo normal en Colab sin GPU: empieza con una muestra pequeña de los datos para depurar el código, mide cuánto tarda cada paso con time.perf_counter(), guarda los resultados intermedios y solo al final entrena con todo. Un modelo que entrena en dos minutos te deja probar treinta ideas en una tarde; uno que tarda una hora, cuatro.
Los datos: un censo de 1994
Vamos a auditar un modelo entrenado con Adult (también llamado Census Income), uno de los datasets más usados para enseñar este tema. Tiene 48 842 personas del censo de los Estados Unidos de 1994 y la tarea es predecir si una persona ganaba más de 50 000 dólares al año. Lo publicaron Barry Becker y Ronny Kohavi en el repositorio UCI (DOI 10.24432/C5XW20) con licencia CC BY 4.0, que permite usarlo citando a sus autores; aquí se descarga desde OpenML (dataset 1590).
Antes de usarlo, tres advertencias que van en cualquier informe serio:
- Son datos de otro país y de hace más de 30 años. El umbral de 50 000 dólares no se ajustó por inflación. Un equipo de investigadores mostró sus límites y propuso datos más nuevos del mismo censo (Ding y otros, 2021). Lo usamos porque es pequeño, está bien documentado y sirve para aprender a auditar, no para decidir nada sobre personas reales.
- La columna de sexo tiene solo dos valores, los que registró el censo de entonces. No describe a todas las personas.
- El «banco» de este tema es imaginario: llamamos aprobar a que el modelo prediga «más de 50 000», para pensar en un uso concreto.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_openml

# La primera vez se descarga (unos 4 MB); después sale de la caché
adult = fetch_openml("adult", version=2, as_frame=True).frame

# Nombres en español; se dejan fuera fnlwgt (un peso de muestreo
# del censo) y education (repite anios_estudio en palabras)
datos = adult.rename(columns={
    "age": "edad", "workclass": "empleador",
    "education-num": "anios_estudio", "marital-status": "estado_civil",
    "occupation": "ocupacion", "relationship": "parentesco",
    "capital-gain": "ganancia_capital", "capital-loss": "perdida_capital",
    "hours-per-week": "horas", "native-country": "pais", "race": "raza",
}).drop(columns=["fnlwgt", "education"])
sexos = {"Female": "mujer", "Male": "hombre"}
datos["sexo"] = datos["sex"].astype(str).map(sexos)
datos["ingreso_alto"] = (datos["class"] == ">50K").astype(int)
datos = datos.drop(columns=["sex", "class"])

print(datos.shape)
print(f"Ganan más de 50 000 dólares: {datos['ingreso_alto'].mean():.1%}")
# tasa_base: la fracción del grupo que realmente es positiva
print(datos.groupby("sexo")["ingreso_alto"]
      .agg(personas="size", tasa_base="mean").round(3))
(48842, 13)
Ganan más de 50 000 dólares: 23.9%
personas tasa_base
sexo
hombre 32650 0.304
mujer 16192 0.109En estos datos, el 30,4 % de los hombres y solo el 10,9 % de las mujeres ganaban más de 50 000 dólares. Esa diferencia no dice nada sobre la capacidad de nadie: refleja cómo era el mercado de trabajo en 1994. Influyen la brecha salarial entre hombres y mujeres por el mismo trabajo, que más mujeres trabajaran a tiempo parcial o se ocuparan del cuidado de la familia sin sueldo, y que algunas ocupaciones mejor pagadas estuvieran casi cerradas para ellas. Los datos son un registro de esas desigualdades históricas, y un modelo que aprende de ellos aprende a repetirlas. Por eso los atributos sensibles, como el sexo, el origen étnico, la religión, la edad o una discapacidad, se tratan con cuidado: no para adivinar cosas sobre una persona, sino para revisar si el modelo trata peor a algún grupo. La edad también es sensible; aquí la dejamos como variable porque se relaciona con la experiencia laboral, pero también habría que auditar el modelo por edad (puedes hacerlo como ejercicio extra).
Borrar una columna no basta
Dividimos en tres partes: entrenamiento (60 %), validación (20 %) para elegir el modelo y los umbrales, y prueba (20 %), que se usa una sola vez al final. Como queremos medir por grupos, estratificamos por la combinación de ingreso y sexo: así cada parte tiene la misma proporción de mujeres con ingreso alto, que son pocas.
Una idea muy común es «si el modelo no ve el sexo, no puede discriminar». Por eso dejamos fuera las columnas sexo y raza de las variables del modelo, pero las guardamos aparte para la auditoría. Veamos si eso alcanza.
from sklearn.model_selection import train_test_split

NUMERICAS = ["edad", "anios_estudio", "ganancia_capital",
             "perdida_capital", "horas"]
CATEGORICAS = ["empleador", "estado_civil", "ocupacion", "parentesco",
               "pais"]
X = datos[NUMERICAS + CATEGORICAS]
y = datos["ingreso_alto"]
sexo = datos["sexo"]

# Se estratifica por ingreso y sexo a la vez: las tres partes tienen
# las mismas proporciones de cada combinación
estratos = y.astype(str) + sexo
X_ent, X_resto, y_ent, y_resto, s_ent, s_resto = train_test_split(
    X, y, sexo, test_size=0.4, stratify=estratos, random_state=0)
X_val, X_pru, y_val, y_pru, s_val, s_pru = train_test_split(
    X_resto, y_resto, s_resto, test_size=0.5,
    stratify=estratos[X_resto.index], random_state=0)
print(f"Entrenamiento: {len(X_ent)}   validación: {len(X_val)}"
      f"   prueba: {len(X_pru)}")

# ¿Quitar la columna sexo basta para que el modelo no la vea?
print(pd.crosstab(datos["parentesco"], datos["sexo"]))
Entrenamiento: 29305 validación: 9768 prueba: 9769
sexo hombre mujer
parentesco
Husband 19715 1
Not-in-family 6713 5870
Other-relative 817 689
Own-child 4205 3376
Unmarried 1197 3928
Wife 3 2328No alcanza. La columna parentesco dice si la persona es «Husband» (esposo) o «Wife» (esposa) en su hogar: en esas filas, la columna revela el sexo casi sin error. Una variable que lleva escondida la información de un atributo sensible se llama variable proxy (o sustituta). Borrar la columna original no borra la información; solo hace que sea más difícil verla. En el ejercicio 3 vas a medir cuánto del sexo se puede adivinar con las demás columnas.
Los valores de las columnas categóricas quedaron en inglés, como vienen en el archivo original. Estos son los que vas a ver en las salidas del tema:
| Columna | Valor en inglés | Significado |
|---|---|---|
parentesco |
Husband / Wife | esposo / esposa |
parentesco |
Not-in-family | no vive con su familia |
parentesco |
Own-child | hijo o hija |
parentesco |
Other-relative | otro pariente |
parentesco |
Unmarried | sin pareja casada en el hogar |
estado_civil |
Married-civ-spouse | casado o casada |
estado_civil |
Never-married | soltero o soltera |
estado_civil |
Divorced / Separated / Widowed | divorciado, separado, viudo |
Primero, ganarle a la línea base
Entrenamos tres modelos con el mismo Pipeline del tema 10 y los comparamos en validación: la línea base (DummyClassifier, que siempre dice «no»), una regresión logística y un boosting de árboles (tema 11). HistGradientBoostingClassifier es la versión rápida de ese boosting: agrupa los valores en intervalos (histogramas) y acepta datos faltantes.
from sklearn.compose import ColumnTransformer
from sklearn.dummy import DummyClassifier
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, roc_auc_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

def crear_pipeline(modelo, numericas=NUMERICAS, categoricas=CATEGORICAS):
    """Prepara las columnas de la tabla y termina en el modelo dado."""
    prep_categoricas = Pipeline([
        ("imputar", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore",
                                 sparse_output=False))])
    preparar = ColumnTransformer([
        ("num", StandardScaler(), numericas),
        ("cat", prep_categoricas, categoricas)])
    return Pipeline([("preparar", preparar), ("modelo", modelo)])

candidatos = {
    "línea base": DummyClassifier(strategy="most_frequent"),
    "logística": LogisticRegression(max_iter=1000),
    "boosting": HistGradientBoostingClassifier(random_state=0),
}
exactitudes = {}
for nombre, estimador in candidatos.items():
    pipe = crear_pipeline(estimador).fit(X_ent, y_ent)
    prob = pipe.predict_proba(X_val)[:, 1]
    exactitudes[nombre] = accuracy_score(y_val, prob >= 0.5)
    print(f"{nombre:10s}  exactitud = {exactitudes[nombre]:.3f}"
          f"   AUC = {roc_auc_score(y_val, prob):.3f}")
modelo = pipe  # el último: el boosting

nombres = list(exactitudes)
colores = ["C1" if n == "boosting" else "C0" for n in nombres]
plt.barh(nombres, list(exactitudes.values()), color=colores)
for i, v in enumerate(exactitudes.values()):
    plt.text(v - 0.01, i, f"{v:.3f}", ha="right", va="center",
             color="white")
plt.xlim(0, 1)
plt.xlabel("Exactitud en validación")
plt.title("Primero, ganarle a la línea base")
plt.show()
línea base exactitud = 0.761 AUC = 0.500
logística exactitud = 0.852 AUC = 0.902
boosting exactitud = 0.874 AUC = 0.927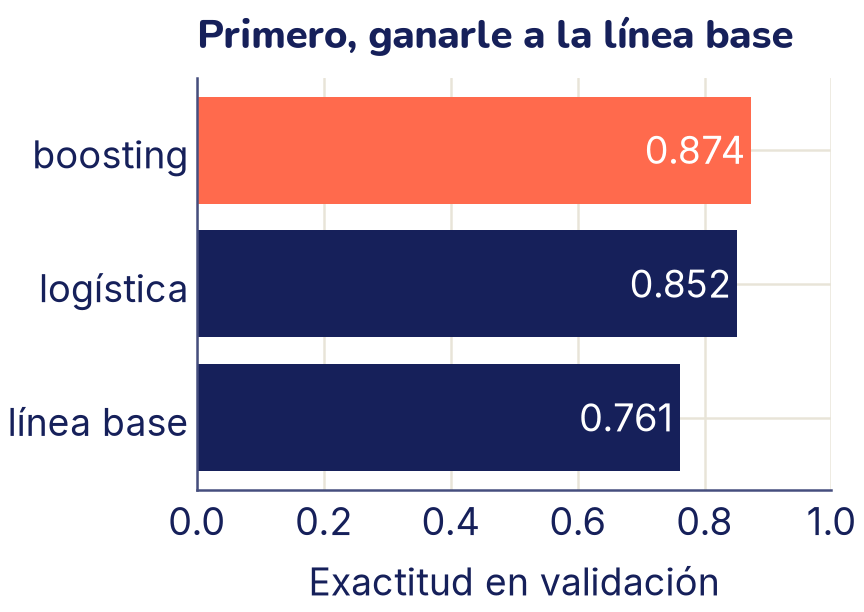
La línea base ya acierta el 76,1 %, porque tres de cada cuatro personas ganan menos de 50 000. Por eso una exactitud de 0,874 es menos impresionante de lo que suena: el boosting corrige casi la mitad de los errores de la línea base. Su AUC, 0,927, dice que ordena bien a las personas por probabilidad. Nos quedamos con el boosting. El conjunto de prueba todavía no se tocó.
Auditar por subgrupos
Ahora sí, la evaluación final en prueba. Además de la exactitud global, calculamos las métricas dentro de cada grupo con groupby. La función metricas recibe la parte de la tabla de un grupo y devuelve:
tasa_base: qué fracción del grupo es realmente positiva (gana más de 50 000);aprobacion: qué fracción del grupo aprueba el modelo;tvp: de los positivos del grupo, qué fracción aprueba (la exhaustividad del tema 9);tfp: de los negativos del grupo, qué fracción aprueba por error;precisionyexactitud, como en el tema 9.
prob_pru = modelo.predict_proba(X_pru)[:, 1]
pred_pru = (prob_pru >= 0.5).astype(int)
print(f"Exactitud en prueba: {accuracy_score(y_pru, pred_pru):.3f}")

def metricas(tabla):
    """Métricas de un grupo. tabla tiene las columnas y y pred."""
    real, pred = tabla["y"], tabla["pred"]
    return pd.Series({
        "n": len(tabla),
        "tasa_base": real.mean(),
        "aprobacion": pred.mean(),
        "tvp": pred[real == 1].mean(),
        "tfp": pred[real == 0].mean(),
        "precision": real[pred == 1].mean(),
        "exactitud": (real == pred).mean(),
    })

auditoria = pd.DataFrame({"y": y_pru.to_numpy(), "pred": pred_pru,
                          "sexo": s_pru.to_numpy()})
por_sexo = auditoria.groupby("sexo")[["y", "pred"]].apply(metricas)
por_sexo["n"] = por_sexo["n"].astype(int)
print(por_sexo.round(3).to_string())
Exactitud en prueba: 0.875
n tasa_base aprobacion tvp tfp precision exactitud
sexo
hombre 6530 0.304 0.255 0.664 0.077 0.789 0.844
mujer 3239 0.109 0.087 0.605 0.023 0.762 0.936Lee la tabla con calma, porque cada columna cuenta algo distinto:
- La exactitud es mayor para las mujeres (0,936 contra 0,844). Parece una buena noticia, pero es la trampa del tema 9: como solo el 10,9 % de las mujeres del conjunto son positivas, decirles «no» a casi todas ya da muchos aciertos.
- La aprobación es 25,5 % para los hombres y 8,7 % para las mujeres. Parte de esa diferencia viene de las tasas base distintas, y parte del modelo.
- La TVP es la que mide las oportunidades: de las mujeres que sí ganaban más de 50 000, el modelo reconoce al 60,5 %; de los hombres, al 66,4 %. A una mujer que cumple le cuesta más ser aprobada.
- La TFP va al revés: el modelo aprueba por error al 7,7 % de los hombres que no cumplen y solo al 2,3 % de las mujeres.
¿La diferencia es real? Intervalos de bootstrap
En el conjunto de prueba hay unas 350 mujeres positivas. Con tan pocas, la TVP de 0,605 podría variar bastante con otra muestra. Para saber cuánto, usamos el bootstrap que viste en el bagging del tema 11: sacamos muchas muestras con reemplazo del mismo tamaño que el grupo, calculamos la métrica en cada una y miramos entre qué valores cae el 95 % central. Ese rango es un intervalo del 95 %.
rng = np.random.default_rng(0)

def intervalos(tabla, repeticiones=1000):
    """Intervalo del 95 % de cada métrica, por bootstrap."""
    muestras = []
    for _ in range(repeticiones):
        filas = rng.integers(0, len(tabla), size=len(tabla))
        muestras.append(metricas(tabla.iloc[filas]))
    muestras = pd.DataFrame(muestras)
    return muestras.quantile([0.025, 0.975])

MOSTRAR = ["aprobacion", "tvp", "exactitud"]
grupos = {g: t for g, t in auditoria.groupby("sexo")}
for g, tabla in grupos.items():
    iv = intervalos(tabla)
    texto = "   ".join(f"{m}: {iv.loc[0.025, m]:.3f}–"
                       f"{iv.loc[0.975, m]:.3f}" for m in MOSTRAR)
    print(f"{g:7s} {texto}")
    grupos[g] = iv

ancho = 0.38
posiciones = np.arange(len(MOSTRAR))
estilos = [("hombre", "hombres", "C2", ""),
           ("mujer", "mujeres", "C3", "//")]
for k, (g, rotulo, color, rayas) in enumerate(estilos):
    valores = por_sexo.loc[g, MOSTRAR].to_numpy(dtype=float)
    iv = grupos[g][MOSTRAR].to_numpy()
    errores = [valores - iv[0], iv[1] - valores]
    plt.bar(posiciones + (k - 0.5) * ancho, valores, ancho, yerr=errores,
            capsize=4, color=color, edgecolor="C2", hatch=rayas,
            ecolor="C0", label=rotulo)
plt.xticks(posiciones, ["Aprobación", "TVP", "Exactitud"])
plt.ylim(0, 1)
plt.ylabel("Tasa en el conjunto de prueba")
plt.title("Métricas por grupo")
plt.legend(loc="upper left")
plt.show()
hombre aprobacion: 0.245–0.266 tvp: 0.643–0.684 exactitud: 0.835–0.853
mujer aprobacion: 0.077–0.097 tvp: 0.552–0.654 exactitud: 0.928–0.945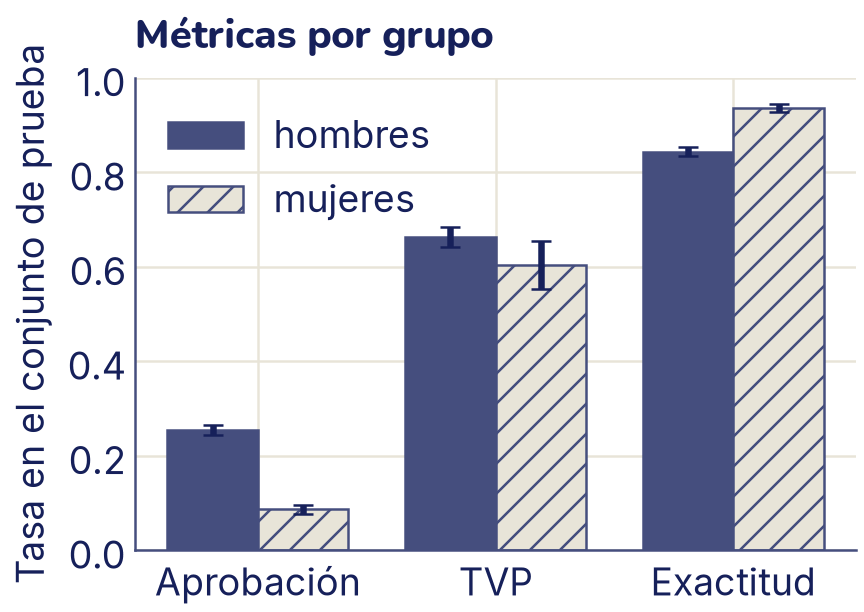
Los intervalos de la aprobación están muy lejos uno del otro: esa diferencia es clarísima. Los de la TVP se tocan (0,643 a 0,684 para los hombres y 0,552 a 0,654 para las mujeres), y el de las mujeres es más del doble de ancho porque hay menos datos. La diferencia de oportunidades es probable, pero con estos datos no es tan segura como la de aprobación. Un número sin intervalo no alcanza para afirmar que un grupo es tratado peor, y un grupo pequeño necesita todavía más cuidado (lo vas a ver en el ejercicio 2).
Mirar los errores
Las métricas resumen; los ejemplos muestran. Una auditoría siempre incluye una tabla de errores representativos: casos tomados al azar, no los más raros, de cada tipo de error y de cada grupo.
prueba = X_pru.assign(sexo=s_pru, real=y_pru, prob=prob_pru.round(2))
errores_fn = prueba[(prueba["real"] == 1) & (prueba["prob"] < 0.5)]
errores_fp = prueba[(prueba["real"] == 0) & (prueba["prob"] >= 0.5)]
print("Falsos negativos por grupo:",
      errores_fn["sexo"].value_counts().to_dict())
print("Falsos positivos por grupo:",
      errores_fp["sexo"].value_counts().to_dict())

columnas = ["sexo", "edad", "anios_estudio", "estado_civil", "horas",
            "prob"]
# Tres falsos negativos al azar de cada grupo
muestra = errores_fn.groupby("sexo").sample(3, random_state=0)
print(muestra[columnas].to_string())
Falsos negativos por grupo: {'hombre': 661, 'mujer': 138}
Falsos positivos por grupo: {'hombre': 358, 'mujer': 67}
sexo edad anios_estudio estado_civil horas prob
3340 hombre 43 10 Married-civ-spouse 44 0.45
26625 hombre 33 3 Married-civ-spouse 50 0.13
44362 hombre 31 9 Married-civ-spouse 50 0.25
2742 mujer 39 14 Divorced 30 0.03
833 mujer 36 14 Divorced 40 0.13
3178 mujer 45 9 Married-civ-spouse 40 0.18Los hombres acumulan más errores de los dos tipos porque son el doble y su tasa base es más alta. En la muestra, los falsos negativos de los hombres están casados, y dos de las tres mujeres están divorciadas, tienen 14 años de estudio y el modelo les da probabilidades bajísimas (0,03 y 0,13). Tres casos no prueban nada, pero dan una pista para investigar: ¿cuánto pesa el estado civil en las decisiones del modelo?
¿En qué se apoya el modelo?
La importancia por permutación del tema 11 responde esa pregunta: desordena una columna del conjunto de prueba y mide cuánta exactitud se pierde.
from sklearn.inspection import permutation_importance

imp = permutation_importance(modelo, X_pru, y_pru, n_repeats=5,
                             random_state=0)
orden = np.argsort(imp.importances_mean)
for j in orden[::-1][:5]:
    print(f"{X.columns[j]:17s} {imp.importances_mean[j]:+.3f}")

colores = ["C1" if j == orden[-1] else "C0" for j in orden]
plt.barh(X.columns[orden], imp.importances_mean[orden], color=colores)
plt.xlabel("Exactitud que se pierde")
plt.title("Importancia por permutación")
plt.show()
estado_civil +0.055
ganancia_capital +0.048
anios_estudio +0.034
edad +0.020
ocupacion +0.016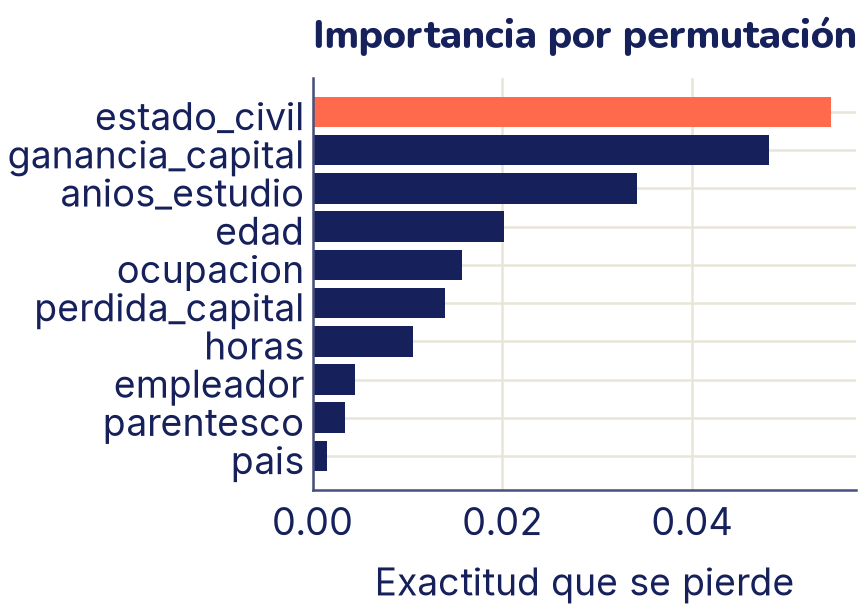
La variable de la que más depende el modelo es estado_civil, más que los años de estudio o las horas trabajadas. En estos datos, estar casado se asocia con ingresos altos, y el estado civil, junto con el parentesco, guarda mucha información sobre el sexo y la situación familiar. parentesco aparece casi en cero, pero no porque no sirva: como dice casi lo mismo que estado_civil, desordenar solo una de las dos le quita poco al modelo (la misma advertencia del tema 11 sobre variables muy relacionadas). La explicación no acusa ni absuelve al modelo: te dice dónde mirar.
Métricas de equidad
Hay muchas definiciones de «justo». Las dos más usadas comparan las tasas que ya calculaste. Llamemos ŷ a la decisión del modelo (1 = aprobar), y a la respuesta real y G al grupo.
Paridad demográfica: todos los grupos se aprueban en la misma proporción, sin importar cuántos cumplen.
Igualdad de oportunidades (Hardt, Price y Srebro, 2016): entre quienes sí cumplen, todos los grupos se aprueban en la misma proporción. Es decir, la TVP es igual.
Si además se pide que la TFP sea igual, se llama igualdad de probabilidades (equalized odds). Y otra familia pide que la precisión sea igual: que una aprobación «valga lo mismo» en cada grupo.
¿Por qué no pedir todas? La paridad y la igualdad de oportunidades, solas, se pueden cumplir juntas, pero pagando con más errores (lo vas a ver en el ejercicio 1). Lo que es matemáticamente imposible, cuando las tasas base de los grupos son distintas y el modelo no es perfecto, es cumplir la paridad junto con la igualdad de probabilidades (misma TVP y misma TFP), o la igualdad de probabilidades junto con la misma precisión (Kleinberg, Mullainathan y Raghavan, 2016; Chouldechova, 2017). Es el choque que viste en la actividad. La forma más directa de moverse entre ellas es usar un umbral distinto para cada grupo. Los elegimos en validación y medimos una sola vez en prueba. Para simplificar, el umbral de los hombres queda en 0,5 y buscamos el de las mujeres.
prob_val = modelo.predict_proba(X_val)[:, 1]
UMBRALES = np.round(np.arange(0.05, 0.96, 0.01), 2)

def tasas(real, prob, umbral):
    """Tasas de aprobación, de verdaderos positivos (TVP) y de falsos
    positivos (TFP)."""
    pred = prob >= umbral
    return pred.mean(), pred[real == 1].mean(), pred[real == 0].mean()

def umbral_parecido(real, prob, objetivo, cual):
    """El umbral cuya tasa (0: aprobación, 1: TVP) queda más cerca
    del objetivo."""
    distancias = [abs(tasas(real, prob, u)[cual] - objetivo)
                  for u in UMBRALES]
    return UMBRALES[int(np.argmin(distancias))]

# En validación: los hombres quedan con 0,5 y se busca el de las mujeres
h, m = (s_val == "hombre").to_numpy(), (s_val == "mujer").to_numpy()
yv = y_val.to_numpy()
meta = tasas(yv[h], prob_val[h], 0.5)
politicas = {
    "un solo umbral": 0.5,
    "igualar aprobación": umbral_parecido(yv[m], prob_val[m], meta[0], 0),
    "igualar oportunidades": umbral_parecido(yv[m], prob_val[m],
                                             meta[1], 1),
}

# En prueba: cada política se mide una sola vez
hp, mp = (s_pru == "hombre").to_numpy(), (s_pru == "mujer").to_numpy()
yp = y_pru.to_numpy()
print("política               umbral M  aprob H/M  TVP H/M    TFP H/M"
      "    exactitud")
for nombre, u_m in politicas.items():
    umbral = np.where(mp, u_m, 0.5)
    pred = prob_pru >= umbral
    ah, th, fh = tasas(yp[hp], prob_pru[hp], 0.5)
    am, tm, fm = tasas(yp[mp], prob_pru[mp], u_m)
    print(f"{nombre:22s} {u_m:.2f}      {ah:.2f}/{am:.2f}  "
          f"{th:.2f}/{tm:.2f}  {fh:.2f}/{fm:.2f}  "
          f"{(pred == yp).mean():.3f}")
política umbral M aprob H/M TVP H/M TFP H/M exactitud
un solo umbral 0.50 0.26/0.09 0.66/0.60 0.08/0.02 0.875
igualar aprobación 0.08 0.26/0.25 0.66/0.88 0.08/0.18 0.840
igualar oportunidades 0.45 0.26/0.10 0.66/0.65 0.08/0.03 0.874- Igualar la aprobación exige bajar el umbral de las mujeres hasta 0,08. Las tasas de aprobación quedan casi iguales (0,26 y 0,25), pero se aprueba a muchas mujeres que no cumplen: su TFP sube de 0,02 a 0,18, más del doble de la de los hombres (0,08). De paso se aprueba a casi todas las que sí cumplen: su TVP sube a 0,88, muy por encima de la de los hombres. La exactitud global cae de 0,875 a 0,840.
- Igualar las oportunidades solo pide bajar el umbral de las mujeres a 0,45. La TVP queda en 0,66 y 0,65, y la exactitud casi no cambia (0,874). La aprobación sigue siendo distinta, porque las tasas base lo son.
¿Y si movemos los dos umbrales a la vez? Probamos todas las parejas de umbrales entre 0,05 y 0,95 en validación y, para cada diferencia permitida entre grupos, buscamos la mejor exactitud posible. Esa curva es la frontera del compromiso entre exactitud y equidad.
# Todas las parejas de umbrales (hombres, mujeres), en validación
rejilla = np.round(np.arange(0.05, 0.96, 0.01), 2)
puntos = []
for u_h in rejilla:
    for u_m in rejilla:
        pred = prob_val >= np.where(m, u_m, u_h)
        dif_aprob = abs(pred[h].mean() - pred[m].mean())
        dif_tvp = abs(pred[h & (yv == 1)].mean()
                      - pred[m & (yv == 1)].mean())
        puntos.append((dif_aprob, dif_tvp, (pred == yv).mean()))
puntos = np.array(puntos)

def frontera(diferencias, exactitud):
    """Para cada diferencia, la mejor exactitud que no la supera."""
    orden = np.argsort(diferencias)
    return diferencias[orden], np.maximum.accumulate(exactitud[orden])

for col, nombre in [(0, "aprobación"), (1, "TVP")]:
    for tope in [0.10, 0.05, 0.02]:
        ok = puntos[:, col] <= tope
        print(f"Diferencia de {nombre} <= {tope:.2f}: mejor exactitud "
              f"{puntos[ok, 2].max():.3f}")

x_a, y_a = frontera(puntos[:, 0], puntos[:, 2])
x_t, y_t = frontera(puntos[:, 1], puntos[:, 2])
plt.step(x_a, y_a, where="post", color="C0", label="aprobación")
plt.step(x_t, y_t, where="post", color="C2", linestyle="--",
         label="oportunidades (TVP)")
ok = puntos[:, 0] <= 0.02
plt.scatter([0.02], [puntos[ok, 2].max()], s=80, color="C1", zorder=3)
plt.xlim(0, 0.3)
plt.ylim(0.84, 0.88)
plt.xlabel("Diferencia máxima entre grupos")
plt.ylabel("Mejor exactitud (validación)")
plt.title("Cuánto cuesta la equidad")
plt.legend(loc="lower right")
plt.show()
Diferencia de aprobación <= 0.10: mejor exactitud 0.868
Diferencia de aprobación <= 0.05: mejor exactitud 0.861
Diferencia de aprobación <= 0.02: mejor exactitud 0.855
Diferencia de TVP <= 0.10: mejor exactitud 0.875
Diferencia de TVP <= 0.05: mejor exactitud 0.875
Diferencia de TVP <= 0.02: mejor exactitud 0.874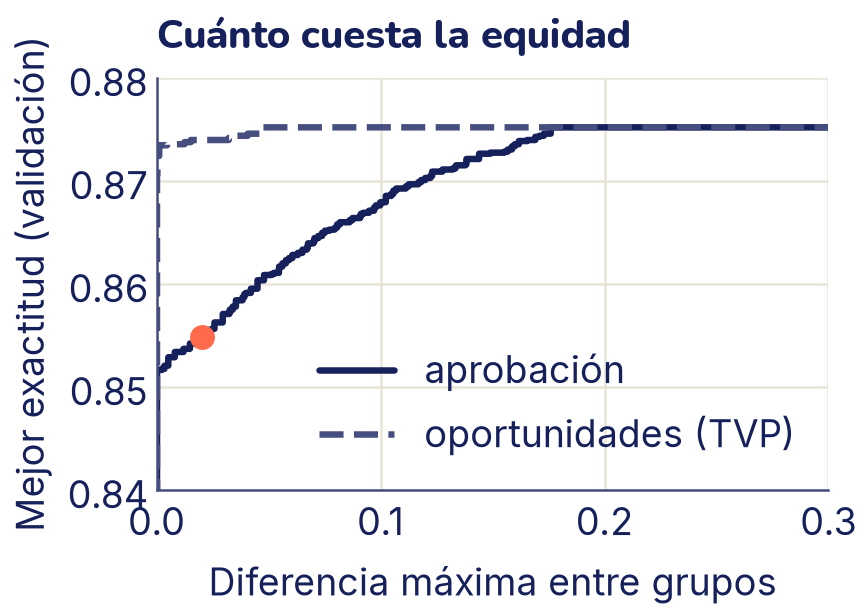
En este problema, igualar las oportunidades es casi gratis: exigir que la TVP de los dos grupos no difiera en más de 0,02 deja la exactitud en 0,874. Igualar la aprobación cuesta más: con una diferencia de 0,02 como máximo, la mejor exactitud baja a 0,855 (el punto resaltado), unos dos puntos menos. Esto no es una ley general: en otros datos el compromiso puede ser mucho más caro. Por eso se mide.
¿Cuál elegir? Depende de la pregunta, y la respuesta va escrita en la ficha:
- Si las etiquetas son confiables y la decisión debe premiar a quien cumple (por ejemplo, devolver un préstamo), la igualdad de oportunidades suele ser la más defendible.
- Si sospechas que las propias etiquetas están sesgadas (el «ingreso alto» de 1994 ya trae la brecha salarial adentro), igualar las oportunidades medidas con esas etiquetas también hereda el sesgo. Entonces se discute la paridad, o mejor, cambiar los datos o la pregunta.
- Usar el sexo o el origen de una persona para darle un umbral distinto es tratarla distinto por su grupo. En muchos países eso está regulado o prohibido en decisiones como el crédito o el empleo. Antes de aplicarlo hay que consultar la ley y a las personas afectadas. A veces la mejor salida no es un truco de umbrales, sino mejores datos, otras variables o no automatizar esa decisión.
La ficha del modelo
Una ficha de modelo (model card, Mitchell y otros, 2019) es un documento corto que acompaña a un modelo y le dice a quien lo use qué hace, cómo se midió y dónde falla. Su pariente es la ficha de datos (datasheet, Gebru y otros, 2018), que cuenta de dónde vienen los datos, quién los recogió y con qué permisos. Esta es la ficha del modelo de este tema, con los números de arriba:
Ficha del modelo: ¿ingreso mayor a 50 000 dólares? (ejercicio de auditoría)
- Qué es. Un
HistGradientBoostingClassifierde scikit-learn con los hiperparámetros por defecto, dentro de unPipeline(estandarizar las numéricas e imputar y pasar a one-hot las categóricas). Entrenado en 29 305 personas. - Uso previsto. Material de estudio para aprender a auditar un clasificador.
- Usos fuera de alcance. Cualquier decisión real sobre personas: crédito, empleo, vivienda o beneficios. Los datos son de otro país y de 1994.
- Datos. Adult (UCI, CC BY 4.0), 48 842 personas del censo de los Estados Unidos de 1994. División estratificada por ingreso y sexo: 60 % entrenamiento, 20 % validación y 20 % prueba. Variables usadas: edad, empleador, años de estudio, estado civil, ocupación, parentesco, ganancia y pérdida de capital, horas por semana y país. No usa sexo ni raza, pero
parentescoyestado_civilfuncionan como proxies del sexo. - Métricas globales (prueba). Exactitud 0,875 frente a 0,761 de la línea base. AUC 0,927 en validación.
- Métricas por grupo (prueba, umbral 0,5). Aprobación: hombres 0,255, mujeres 0,087. TVP: hombres 0,664 (intervalo del 95 %: 0,643 a 0,684), mujeres 0,605 (0,552 a 0,654). TFP: 0,077 y 0,023.
- Consideraciones éticas. Las etiquetas reflejan la desigualdad salarial de 1994. Igualar las oportunidades con umbrales por grupo costaría poco en exactitud (0,875 a 0,874), pero implica usar el sexo en la decisión.
- Limitaciones. No se auditaron grupos pequeños con suficiente cuidado (ver el ejercicio 2), ni combinaciones de atributos (por ejemplo, mujeres de un origen determinado). La variable más influyente es el estado civil.
- Quién lo hizo y cuándo. Escribe aquí tu nombre, la fecha y la versión de las librerías.
La plantilla del proyecto final
Tu proyecto final (lo describe el mini-proyecto de la ficha de ejercicios) se entrega como un cuaderno de Colab que tú armas con estas secciones, en este orden. Cada sección empieza con una celda de texto que explica lo que hace la siguiente celda de código.
- La pregunta. Una o dos frases: qué predices, para quién, qué decisión se tomaría y qué error cuesta más. Elige la métrica principal aquí, antes de ver resultados.
- Los datos. Origen, licencia y fecha. Cuántos ejemplos y qué columnas. Si hay datos personales, cuáles y por qué los necesitas. Un gráfico de exploración (tema 4). La división en entrenamiento, validación y prueba, con la semilla fija.
- La línea base. El modelo más simple y su puntaje en validación.
- El modelo y las iteraciones. Una tabla-bitácora con cada intento: qué cambiaste, puntaje en validación y tiempo de entrenamiento. Explica por qué elegiste el modelo final.
- La evaluación final. Una sola vez en prueba: la métrica principal, la matriz de confusión o el gráfico de residuos, y la comparación con la línea base.
- El análisis por subgrupos y los errores. Métricas por grupo con intervalos de bootstrap (si tus datos tienen grupos con sentido: región, idioma, tipo de foto, hablante…), una tabla de errores representativos y la importancia de las variables o ejemplos de lo que el modelo mira.
- La ficha del modelo. Con las secciones de la ficha de arriba.
- Qué harías con más tiempo. Tres ideas concretas.
IA responsable, más allá de las métricas
Medir por grupos es una parte. Un proyecto de IA también toca personas de otras maneras.
Privacidad y datos personales
Un dato personal es cualquier información sobre una persona identificada o que se pueda identificar: el nombre, el carnet, una foto de la cara, la voz, la ubicación del celular, las notas del colegio. Borrar el nombre no anonimiza: con unas pocas columnas comunes, como la edad, el sexo y la ocupación, muchas personas quedan únicas en la tabla y se las puede reconocer cruzando con otra fuente (lo vas a medir en el ejercicio 6). Algunas reglas prácticas para tu proyecto:
- Recoge solo lo que necesitas (minimización) y para un fin que explicas (finalidad).
- Pide permiso para usar fotos, voces o textos de otras personas, y diles para qué.
- No subas datos personales de otros a servicios en línea, incluidos los chats con modelos de lenguaje.
- Guarda los datos con cuidado y bórralos cuando el proyecto termine.
Qué dice la normativa en Bolivia
Esto es lo que se puede verificar a octubre de 2026, con las fuentes:
- La Constitución Política del Estado (2009) reconoce en el artículo 21 el derecho «a la privacidad, intimidad, honra, honor, propia imagen y dignidad», y en el artículo 25 la inviolabilidad del domicilio y el secreto de las comunicaciones privadas.
- Los artículos 130 y 131 crean la Acción de Protección de Privacidad. Puede presentarla quien no pueda conocer, objetar u obtener que se eliminen o corrijan sus datos registrados en archivos o bancos de datos públicos o privados, por cualquier medio, incluido el informático. Si el juez la declara procedente, ordena revelar, eliminar o rectificar esos datos.
- Bolivia no tiene todavía una ley general de protección de datos personales. La Agencia de Gobierno Electrónico y Tecnologías de Información y Comunicación (AGETIC) socializó un proyecto de ley en 2025 (boletín de la AGETIC de septiembre de 2025), y en septiembre de 2026 la prensa seguía informando que no se había aprobado (Opinión, 16 de septiembre de 2026). Si lees esto más adelante, revisa la Gaceta Oficial de Bolivia: la situación puede haber cambiado.
Dos marcos internacionales sirven de referencia. La Ley de IA de la Unión Europea (Reglamento 2024/1689) clasifica los sistemas por su nivel de riesgo y considera de alto riesgo, entre otros, los que evalúan la solvencia de una persona para darle crédito, como el banco imaginario de este tema. La Recomendación sobre la ética de la inteligencia artificial de la UNESCO (2021), adoptada por sus Estados miembros, pide proteger la privacidad, evitar la discriminación, ser transparentes y medir el impacto ambiental.
Sesgos: de dónde vienen
El sesgo de Adult es histórico: los datos registran bien un mundo desigual. Hay otros tipos que vas a encontrar en tu proyecto:
- De representación: un grupo casi no aparece. En Adult, la categoría «otra» de origen tiene menos de 100 personas en prueba, y sus métricas casi no se pueden medir. Un modelo de voz entrenado con hablantes de una ciudad entiende peor los acentos de otras regiones.
- De medición o de etiqueta: lo que se mide no es exactamente lo que importa. «Ganó más de 50 000» no es «puede pagar un crédito», y «lo arrestaron» no es «cometió un delito».
- De despliegue: el modelo se usa en un lugar o una época distintos de los de sus datos, como usar un censo de 1994 para decidir en 2026.
Transparencia y explicabilidad
Las personas afectadas por una decisión automática tienen razones para preguntar por qué. Las herramientas de este tema (la importancia por permutación, la tabla de errores y la ficha del modelo) son el mínimo. Y una regla simple: di cuándo algo lo hizo una IA, sea una decisión, un texto o una imagen.
IA generativa y desinformación
Los modelos de los temas 24 y 29 escriben textos e imágenes convincentes, y por eso sirven también para fabricar noticias, voces o fotos falsas de personas reales. Al compartir algo, pregúntate de dónde viene; al crear algo con IA, etiquétalo. Y recuerda que un modelo de lenguaje puede inventar datos, citas o referencias con total seguridad: lo que diga se verifica en una fuente.
Impacto ambiental
Entrenar y usar modelos consume electricidad y agua para enfriar los centros de datos. Según la Agencia Internacional de Energía, los centros de datos usaron alrededor del 1,5 % de la electricidad mundial en 2024 (unos 415 TWh), y prevé que su consumo se duplique con creces hasta unos 945 TWh en 2030. En tu escala, lo responsable es lo mismo que lo eficiente: empezar con modelos pequeños, reutilizar modelos preentrenados en lugar de entrenar desde cero, no repetir entrenamientos largos sin una pregunta clara y anotar en la ficha cuánto tiempo de cómputo usaste.
Usar modelos de lenguaje en el estudio, con honestidad
Un asistente como los del tema 24 puede ser un buen tutor, si lo usas para entender, no para evitar entender:
- Pídele que te explique un error o un concepto, y luego escribe tú el código.
- Todo el código que te dé se ejecuta y se comprueba; no lo copies sin entender cada línea.
- Declara en tu proyecto para qué usaste un asistente («me ayudó a depurar la función de bootstrap»). Ocultarlo es tan deshonesto como copiar de un compañero.
- Tienes que poder explicar con tus palabras cualquier parte de tu proyecto, porque eso es lo que aprendiste.
Derechos de autor y licencias de datos
Que algo esté en internet no quiere decir que puedas usarlo. Antes de usar datos o un modelo, busca su licencia: CC BY (como Adult) permite casi todo citando a los autores; CC BY-NC prohíbe el uso comercial; y un dataset sin licencia no es libre, simplemente no sabes qué permite. Los modelos preentrenados de los temas 21 a 26 también tienen licencias, que conviene leer. Las fotos y grabaciones de personas necesitan, además, su permiso.
Lo que aprendiste
- Un proyecto de IA sigue un ciclo: pregunta, datos, línea base, iteración y evaluación final, con la prueba guardada hasta el final.
- La exactitud global puede esconder que un modelo trata peor a un grupo. Se audita por subgrupos con
groupby, mirando la aprobación, la TVP y la TFP, con intervalos de bootstrap. - Borrar un atributo sensible no basta: otras variables lo delatan.
- La paridad demográfica y la igualdad de oportunidades piden cosas distintas, y con tasas base distintas no se pueden cumplir todas. Mover umbrales por grupo muestra el compromiso, y la elección se justifica por escrito.
- Una ficha de modelo dice qué hace el modelo, cómo se midió, para qué no sirve y dónde falla.
- La privacidad, los sesgos, la transparencia, la desinformación, el consumo de energía, las licencias y el uso honesto de los asistentes son parte del trabajo, no un agregado.
El final de la ruta, y lo que sigue
Empezaste esta ruta escribiendo print en el tema 1. Desde entonces programaste el descenso de gradiente a mano, entrenaste árboles, redes convolucionales y transformers, reutilizaste modelos que vieron millones de ejemplos y, en este tema, aprendiste a preguntarle a un modelo a quién le falla. Lo que sigue depende de lo que más te haya gustado:
- La matemática de fondo. Álgebra lineal, cálculo de varias variables y probabilidad. El libro Mathematics for Machine Learning se puede leer gratis en línea.
- Redes neuronales en profundidad. Dive into Deep Learning (gratuito, con código en PyTorch) y los tutoriales oficiales de PyTorch retoman los temas 16 a 29 con más detalle.
- Modelos preentrenados y lenguaje. Los cursos de Hugging Face siguen donde terminaron los temas 21 a 25.
- Lo que la ruta no cubrió. El aprendizaje por refuerzo y por imitación (agentes que aprenden probando o copiando a un experto) quedó en el tema optativo 20 bis; si no lo hiciste, es un buen siguiente paso. Tampoco cubrió las redes de grafos, la inferencia causal (distinguir correlación de causa) y cómo poner un modelo en producción y mantenerlo.
- Problemas de tu entorno. Busca datos abiertos sobre algo que conozcas: el clima de tu ciudad, el idioma que hablas en casa, los cultivos de tu región. Un proyecto pequeño sobre un problema real enseña más que un tutorial.
- Leer y replicar. Elige un artículo corto de arXiv sobre un tema de la ruta y trata de reproducir uno de sus resultados con su código.
Sigue haciendo lo que hiciste en cada tema: primero la intuición, después el código, y siempre medir con honestidad.