Antes de empezar
Varios ejercicios usan lo que construiste en la teoría: onda y sr (el Quijote), stft, en_db, tinta, audios, digitos, tomas, a_un_segundo, mel_d, media, desvio, cnn, bloque, entrenar, evaluar, cargador_val, whisper, transcribir, mostrar, REFERENCIA, normalizar, ref, con_ruido, textos y wer. Abre un cuaderno nuevo, pega y ejecuta en orden los bloques de la ficha Código (la primera vez baja los audios y los modelos) y después trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta.
Ejercicios
1. ¿Qué sonido es cada uno?
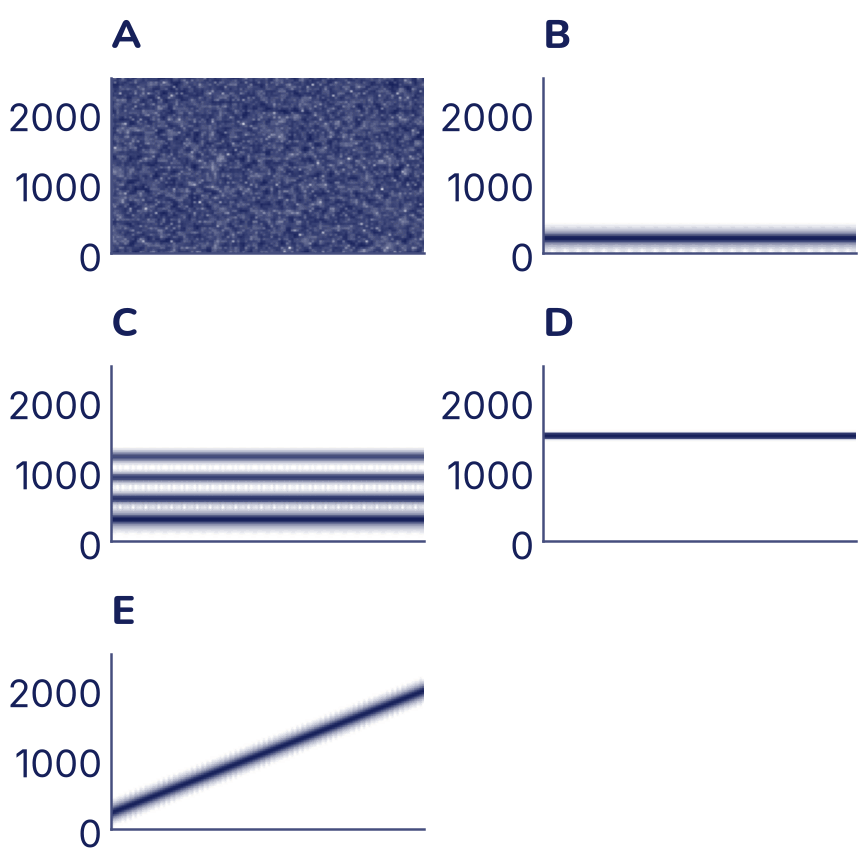
Estos son los espectrogramas de cinco sonidos sintéticos de un segundo, en desorden: un tono grave de 200 Hz, un tono agudo de 1500 Hz, un silbido que sube de 200 a 2000 Hz, ruido (como un «shhh») y una nota con armónicos (300 Hz más sus múltiplos 600, 900 y 1200 Hz, cada uno más suave). Di cuál es cuál y explica qué te delató en cada caso.
El código que hizo la figura (trae la respuesta: ábrelo al final)
sr_e = 8000
t_e = np.arange(sr_e) / sr_e
rng = np.random.default_rng(1)
sonidos = {
    "tono grave": np.sin(2 * np.pi * 200 * t_e),
    "tono agudo": np.sin(2 * np.pi * 1500 * t_e),
    # La frecuencia sube de 200 a 2000 Hz en un segundo
    "silbido que sube": np.sin(2 * np.pi * (200 * t_e + 900 * t_e ** 2)),
    "ruido": 0.5 * rng.normal(size=sr_e),
    "nota con armónicos": sum(np.sin(2 * np.pi * 300 * k * t_e) / k
                              for k in [1, 2, 3, 4]),
}
orden = ["ruido", "tono grave", "nota con armónicos", "tono agudo",
         "silbido que sube"]

fig, ejes = plt.subplots(3, 2, figsize=(4.8, 4.8))
for eje, letra, nombre in zip(ejes.flat, "ABCDE", orden):
    S = en_db(stft(sonidos[nombre], 256, 64))
    eje.imshow(S, origin="lower", aspect="auto", cmap=tinta,
               vmin=S.max() - 60, extent=[0, 1, 0, sr_e / 2])
    eje.set_ylim(0, 2500)
    eje.set_title(letra)
    eje.set_xticks([])
    eje.set_yticks([0, 1000, 2000])
    eje.grid(False)
ejes[2, 1].axis("off")
plt.show()

for letra, nombre in zip("ABCDE", orden):
    print(letra, "=", nombre)
A = ruido
B = tono grave
C = nota con armónicos
D = tono agudo
E = silbido que subeRespuesta
- A, ruido: tinta repartida en todas las frecuencias y todo el tiempo, sin rayas. El ruido no tiene tono: tiene un poco de cada frecuencia.
- B, tono grave: una sola raya horizontal, abajo, en 200 Hz.
- C, nota con armónicos: una escalera de cuatro rayas paralelas igual de separadas (300, 600, 900 y 1200 Hz). Así se ven las vocales de la voz. Los armónicos más altos suenan más suave, pero el espectrograma está en decibeles, una escala logarítmica, y por eso las cuatro rayas se ven casi igual de oscuras.
- D, tono agudo: una sola raya, más arriba, en 1500 Hz.
- E, silbido que sube: una raya inclinada: la frecuencia cambia con el tiempo. La frecuencia es la velocidad con que avanza lo que está dentro del seno (dividido entre 2π): si eso crece como 200t + 900t², su velocidad (su derivada, tema 5) es 200 + 1800t, que sube en línea recta de 200 a 2000 Hz.
2. Cuentas de muestras, ventanas y cuadros
Sin computadora:
- Los audios de FSDD tienen 8000 muestras por segundo. ¿Cuál es la frecuencia más alta que pueden representar?
- El log-Mel de FSDD usa
n_fft=256yhop_length=80. ¿Cuántos milisegundos dura cada ventana? ¿Cada cuánto empieza una? ¿Cuántos cuadros salen de un audio de 1 s, sitorchaudioagrega un cuadro más por el borde? - Whisper usa 16 000 muestras por segundo y un salto de 160. ¿Cuántos cuadros tiene su entrada de 30 segundos? ¿Y el Quijote, de 876 800 muestras?
Después comprueba con código, y mira qué pasa si le das a Whisper más de 30 segundos sin pedirle los tiempos.
Respuesta
- La frecuencia de Nyquist: 8000 / 2 = 4000 Hz. Por eso el espectrograma de Mel de FSDD llega solo hasta ahí.
- La ventana dura 256 / 8000 = 0,032 s = 32 ms, y empieza una cada 80 / 8000 = 0,01 s = 10 ms. En 1 s caben 8000 / 80 = 100 saltos, más el cuadro del borde: 101 cuadros.
- 30 s son 480 000 muestras; entre 160, 3000 cuadros. El Quijote: 876 800 / 160 = 5480 cuadros (el procesador de Whisper no agrega el cuadro del borde): más de los 3000 que Whisper mira de una vez.
print("Nyquist de FSDD:", sr_d // 2, "Hz")
print("Ventana:", 1000 * 256 / sr_d, "ms   salto:", 1000 * 80 / sr_d,
      "ms   cuadros en 1 s:", log_mel.shape[-1])

procesador, modelo = whisper["tiny"]
x = procesador(onda, sampling_rate=16000, return_tensors="pt",
               truncation=False, padding="longest",
               return_attention_mask=True)
print("Cuadros del Quijote:", x["input_features"].shape[-1])
modelo.generate(**x, language="es")
Nyquist de FSDD: 4000 Hz
Ventana: 32.0 ms salto: 10.0 ms cuadros en 1 s: 101
Cuadros del Quijote: 5480
Traceback (most recent call last):
...
ValueError: You have passed more than 3000 mel input features (> 30 seconds) which automatically enables long-form generation which requires the model to predict timestamp tokens. Please either pass `return_timestamps=True` or make sure to pass no more than 3000 mel input features.Whisper se entrenó con tramos de 30 segundos, 3000 cuadros, y no acepta una entrada más larga de una vez. Con return_timestamps=True (lo que hace transcribir) el modelo marca dónde termina cada frase y avanza de tramo en tramo: así transcribe audios de cualquier largo.
3. Normalizar antes de medir
El WER de la teoría se calculó después de pasar los textos a minúsculas y quitar la puntuación. Calcula el WER de whisper-base con el Quijote de tres formas: con los textos tal cual, normalizados como en la teoría, y además corrigiendo dos diferencias que no son errores de oído: los números escritos con cifras y el castellano antiguo (lantejas, della y mesmo se dicen hoy lentejas, de ella y mismo). ¿Cuál de los tres números es el «verdadero»?
Respuesta
import jiwer

hip_base = textos["base", "es"]
print(f"Tal cual:     {jiwer.wer(REFERENCIA, hip_base):.3f}")
print(f"Normalizado:  {jiwer.wer(ref, normalizar(hip_base)):.3f}")

# Lo que no son errores de oído: cifras y castellano antiguo
cambios = {"40": "cuarenta", "20": "veinte", "lantejas": "lentejas",
           "della": "de ella", "mesmo": "mismo"}


def modernizar(texto):
    """Cambia palabra por palabra según el diccionario `cambios`."""
    return " ".join(cambios.get(p, p) for p in texto.split())


print(f"Además, sin cifras ni arcaísmos: "
      f"{jiwer.wer(modernizar(ref), modernizar(normalizar(hip_base))):.3f}")
Tal cual: 0.311
Normalizado: 0.281
Además, sin cifras ni arcaísmos: 0.235El mismo audio y la misma transcripción dan tres WER distintos:
- Tal cual, 0,311. Cuenta como error «Mancha,» frente a «mancha»: una coma y una mayúscula no son errores de oído.
- Normalizado, 0,281. Es el de la teoría, la forma habitual de medir.
- Sin cifras ni arcaísmos, 0,235. Whisper oyó bien «cuarenta», «veinte», «lantejas», «della» y «mesmo», pero los escribió como se escriben hoy («40», «20», «lentejas», «de ella», «mismo»). Ojo: «della» pasa a ser dos palabras, así que la referencia también cambia de largo.
Ninguno es «el verdadero»: depende de qué quieres medir. Si te importa entender lo que se dijo, el tercero es más justo; si necesitas el texto exacto de Cervantes, el segundo. Lo que sí importa es decir siempre cómo normalizaste y comparar modelos solo con la misma normalización. Fíjate que lo que queda (0,235) son errores de verdad: «haciendo», «salio», «pantunflos».
4. Whisper tiny frente a base: tiempo y errores
Mide cuánto tarda cada modelo en transcribir el Quijote con time.perf_counter y ponlo al lado de su WER (sin ruido y con ruido, del diccionario wer de la teoría) y de su tamaño. ¿Cuándo elegirías el chico?
Respuesta
import time

tiempos = {}
for nombre in ["tiny", "base"]:
    inicio = time.perf_counter()
    transcribir(onda, nombre, "es")
    tiempos[nombre] = time.perf_counter() - inicio
    millones = sum(p.numel() for p in whisper[nombre][1].parameters())
    print(f"{nombre}: {millones / 1e6:.0f} M de parámetros, "
          f"WER {wer[nombre, 'es']:.3f} sin ruido y "
          f"{wer[nombre, 'es + ruido']:.3f} con ruido")
print("¿base tardó más que tiny?", tiempos["base"] > tiempos["tiny"])
tiny: 38 M de parámetros, WER 0.363 sin ruido y 0.452 con ruido
base: 73 M de parámetros, WER 0.281 sin ruido y 0.341 con ruido
¿base tardó más que tiny? TrueLos segundos exactos dependen de tu computadora, por eso el código solo imprime cuál tardó más; imprime tiempos para ver los tuyos. Base tiene casi el doble de parámetros y tarda más, pero se equivoca menos: el WER baja de 0,363 a 0,281 sin ruido y de 0,452 a 0,341 con ruido. Tiny conviene cuando la velocidad o la memoria mandan (un celular, subtítulos en vivo, miles de horas de audio que procesar) y se puede tolerar una palabra mala de cada tres; base, o uno más grande, cuando el texto tiene que salir bien. Los dos son chicos: Whisper tiene tamaños de hasta unos 1500 millones de parámetros, mucho mejores pero que piden una GPU.
5. Aumentación: ruido y desplazamiento
- Evalúa la
cnnde la teoría con los 300 audios de validación con ruido (SNR 10 dB). Usamos la validación y no la prueba porque vamos a comparar dos redes. ¿Cuánto baja la exactitud? - Entrena una CNN igual con aumentación: en cada época, cada audio de entrenamiento se corre en el tiempo hasta 0,1 s y, la mitad de las veces, al azar, se le suma ruido con una SNR al azar entre 5 y 20 dB. Compara las dos redes con y sin ruido.
Respuesta
from torch.utils.data import DataLoader, Dataset


def preparar(ondas_1s):
    """De ondas de 1 s a log-Mel estandarizado con un canal."""
    return ((torch.log(mel_d(ondas_1s) + 1e-6) - media) / desvio
            ).unsqueeze(-3)


validacion = np.flatnonzero((tomas >= 5) & (tomas < 10))
y_validacion = torch.from_numpy(digitos[validacion])
ruidosas = torch.from_numpy(np.stack(
    [a_un_segundo(con_ruido(audios[k], 10, semilla=int(k)))
     for k in validacion]))
cargador_ruido = DataLoader(
    torch.utils.data.TensorDataset(preparar(ruidosas), y_validacion),
    batch_size=300)
perdida = nn.CrossEntropyLoss()
print(f"CNN sin aumentación: limpio "
      f"{evaluar(cnn, cargador_val, perdida, device)[1]:.3f}, "
      f"con ruido {evaluar(cnn, cargador_ruido, perdida, device)[1]:.3f}")


class DigitosAumentados(Dataset):
    """Cada vez que se pide un audio, sale con otro ruido y corrimiento."""

    def __init__(self, indices):
        self.ondas = torch.from_numpy(
            np.stack([a_un_segundo(audios[k]) for k in indices]))
        self.y = torch.from_numpy(digitos[indices])

    def __len__(self):
        return len(self.y)

    def __getitem__(self, i):
        x = self.ondas[i]
        # Correr hasta 800 muestras (0,1 s) a la derecha. roll es
        # circular: lo que sale por el final entra por el principio; como
        # el final es silencio de relleno, lo que vuelve es silencio
        x = torch.roll(x, int(torch.randint(0, 800, (1,))))
        # La mitad de las veces, ruido con una SNR entre 5 y 20 dB
        if torch.rand(1) < 0.5:
            snr = 5 + 15 * torch.rand(1)
            potencia = x.pow(2).mean() / 10 ** (snr / 10)
            x = x + torch.randn(len(x)) * potencia.sqrt()
        return preparar(x), self.y[i]


cargador_aum = DataLoader(
    DigitosAumentados(np.flatnonzero(tomas >= 10)), batch_size=64,
    shuffle=True, generator=torch.Generator().manual_seed(0))
torch.manual_seed(0)
cnn_aum = nn.Sequential(
    bloque(1, 16), nn.MaxPool2d(2), bloque(16, 32), nn.MaxPool2d(2),
    bloque(32, 32), nn.AdaptiveAvgPool2d((5, 6)), nn.Flatten(),
    nn.Linear(32 * 5 * 6, 10))
entrenar(cnn_aum, cargador_aum, cargador_val, epocas=8,
         optimizador=torch.optim.Adam(cnn_aum.parameters(), lr=1e-3),
         dispositivo=device, mostrar=False)
print(f"CNN con aumentación: limpio "
      f"{evaluar(cnn_aum, cargador_val, perdida, device)[1]:.3f}, "
      f"con ruido "
      f"{evaluar(cnn_aum, cargador_ruido, perdida, device)[1]:.3f}")
CNN sin aumentación: limpio 0.977, con ruido 0.497
CNN con aumentación: limpio 0.967, con ruido 0.820- Sin aumentación, el ruido hunde a la red de 0,977 a 0,497: nunca oyó ruido, y con él los silencios entre sonidos del log-Mel se llenan de tinta.
- Con aumentación, la red pierde un poco con los audios limpios (0,967 frente a 0,977) pero aguanta mucho mejor el ruido (0,820). Aprendió que el ruido y la posición exacta de la palabra no importan para decidir el dígito.
Es el mismo truco del tema 20 (voltear y recortar fotos), adaptado al audio: el ruido y el corrimiento producen audios nuevos y creíbles sin grabar nada. Fíjate en dos detalles del código. La aumentación cambia en cada época, porque se aplica en __getitem__, cada vez que se pide un audio. Y el ruido se suma a la onda, antes del log-Mel, como pasaría con un micrófono de verdad.
6. ¿Qué modelo usarías?
Para cada caso, elige entre Whisper solo, Whisper y después un LLM de texto o un modelo de audio y lenguaje (como Qwen2-Audio o Voxtral), y explica por qué:
- Subtitular los videos de un canal de cocina.
- Saber si en una llamada a un servicio de atención el cliente suena molesto.
- Hacer un resumen con las tareas acordadas en una reunión grabada, en una computadora sin GPU.
- Detectar si en una grabación de la calle se oye una sirena.
- Un celular que tiene que escribir lo que dices mientras hablas, sin internet.
Respuesta
- Whisper solo. Se necesitan las palabras y sus tiempos, y nada más; además, el WER permite medir qué tan buenos son los subtítulos.
- Un modelo de audio y lenguaje. El enojo está en el tono, el volumen y el ritmo, no solo en las palabras; una transcripción lo pierde.
- Whisper y después un LLM de texto. Lo importante son las palabras, y las dos piezas son chicas: es justo el mini-proyecto. Además, cada parte se mide por separado.
- Un modelo de audio y lenguaje (o un clasificador de sonidos entrenado para eso, como la CNN de dígitos). Una sirena no es habla: Whisper no la escribiría.
- Whisper solo, y del tamaño más chico (tiny), o un modelo de transcripción pensado para el celular. Tiene que ir rápido y caber en el teléfono; un modelo de miles de millones de parámetros no entra.
Mini-proyecto: transcribir y resumir
Vas a armar una cadena de dos modelos: Whisper escribe lo que se dice en un audio en español y Qwen2.5-0.5B-Instruct, el LLM del tema 24, lo resume. Y vas a medir los errores de cada paso.
El audio. Graba unos dos minutos en español: tú contando algo (tu colegio, una receta, un partido) o, con su permiso, alguien de tu familia. Escribe a mano lo que se dice: esa es tu referencia. Si prefieres no grabarte, usa el Quijote de la teoría, con REFERENCIA; así están hechos los resultados de abajo. Lee tu audio con sf.read y, si no está a 16 000 Hz o tiene dos canales, conviértelo con onda.mean(axis=1) y torchaudio.functional.resample. Los celulares graban en .m4a, .aac u .opus (WhatsApp), y soundfile no lee esos formatos: conviértelo antes en una celda de Colab con !ffmpeg -i mi_audio.m4a -ar 16000 -ac 1 mi_audio.wav, que de paso lo deja a 16 000 Hz y en un solo canal.
Pasos.
- Transcribe con
whisper-tinyy conwhisper-basey mide el WER de cada uno contra tu referencia, normalizando los dos textos. - Resume con Qwen, de forma determinista (
do_sample=False), con una instrucción clara: «Resume en dos oraciones…». Haz tres resúmenes: de la referencia, de la transcripción de base y de la de tiny. - Mide el resumen. Antes de leer los resúmenes, anota cinco a ocho datos clave del audio (quién, qué, dónde, cuántos). Para cada resumen, cuenta cuántos datos clave aparecen y si hay algo inventado que no está en el audio.
- Concluye. ¿Los errores de Whisper llegan al resumen? ¿El resumen de la referencia es perfecto, o Qwen también se equivoca? ¿Dónde está el eslabón más débil de la cadena?
Resultados de referencia con el Quijote, para comprobar los tuyos
from transformers import AutoModelForCausalLM, AutoTokenizer

nombre = "Qwen/Qwen2.5-0.5B-Instruct"
tok = AutoTokenizer.from_pretrained(nombre)
llm = AutoModelForCausalLM.from_pretrained(nombre, dtype=torch.float32)
llm = llm.to(device).eval()


@torch.no_grad()
def resumir(texto, max_tokens=150):
    """Resumen determinista de `texto` con Qwen."""
    mensajes = [
        {"role": "system",
         "content": "Resumes textos en español. Usa solo datos del texto."},
        {"role": "user",
         "content": "Resume en dos oraciones este texto:\n\n" + texto},
    ]
    x = tok.apply_chat_template(mensajes, add_generation_prompt=True,
                                return_tensors="pt", return_dict=True)
    x = x.to(device)
    salida = llm.generate(**x, max_new_tokens=max_tokens,
                          do_sample=False)
    return tok.decode(salida[0, x["input_ids"].shape[1]:],
                      skip_special_tokens=True)


# Paso 1: WER de cada transcripción (ya calculado en la teoría)
for modelo_w in ["tiny", "base"]:
    print(f"WER de whisper-{modelo_w}: {wer[modelo_w, 'es']:.3f}")

# Pasos 2 y 3: resumir y buscar los datos clave
datos_clave = {
    "hidalgo": ["hidalgo"], "la Mancha": ["mancha"],
    "rocín": ["rocín", "caballo"], "galgo": ["galgo", "perro"],
    "el ama": ["ama"], "la sobrina": ["sobrina"],
    "el mozo": ["mozo"],
}
fuentes = {"referencia": REFERENCIA, "whisper-base": textos["base", "es"],
           "whisper-tiny": textos["tiny", "es"]}
for fuente, texto in fuentes.items():
    resumen = resumir(texto)
    palabras = normalizar(resumen).split()
    presentes = [dato for dato, formas in datos_clave.items()
                 if any(f in palabras for f in formas)]
    print(f"\nResumen de {fuente}:")
    mostrar(resumen)
    print(f"Datos clave: {len(presentes)} de {len(datos_clave)}:",
          ", ".join(presentes))
WER de whisper-tiny: 0.363
WER de whisper-base: 0.281
Resumen de referencia:
El hidalgo de los de lanza vivió en una mancha, donde trabajó con
ladrillos antiguo, rocín flaco y galgo corredor. Su hogar era una olla
vacía, llenada de comida y celebración.
Datos clave: 4 de 7: hidalgo, la Mancha, rocín, galgo
Resumen de whisper-base:
En el lugar donde vivía poco tiempo, tenía una olla vacía de carne,
salpicones nocturnos, duetos y quebrantos, lentes de anedelos y
parominos de añadidura, consumiendo tres partes de su trabajo cada día.
Además, tenia una ama de 40 años y una sobrina de 20 años, mientras que
un mozo de campo y plaza trabajaba duro y lloraba al rocin como tomaba
la podadera.
Datos clave: 3 de 7: el ama, la sobrina, el mozo
Resumen de whisper-tiny:
En el lugar de la mancha, vivía un hombre llamado Velante, con una casa
en el amac, sobrinas y un monje de campo y plaza.
Datos clave: 1 de 7: la ManchaLo que muestran estos resultados:
- Whisper base transcribe mejor (WER 0,281 frente a 0,363), y su resumen conserva más del final del texto: el ama, la sobrina y el mozo. El de tiny inventa un personaje, «Velante», a partir de un error de transcripción («de Velarte» en lugar de «de velarte», que es una tela): los errores de Whisper llegan al resumen.
- Pero el eslabón más débil es el resumen. Incluso con el texto perfecto, Qwen2.5-0.5B inventa: el hidalgo «trabajó con ladrillos» y su hogar era «una olla vacía, llenada de comida y celebración». Con la transcripción de base dice que el ama tiene «40 años», cuando el texto dice que pasaba de los cuarenta. Un LLM de 500 millones de parámetros resume mal un castellano de hace 400 años.
- Contar palabras clave no alcanza. El conteo automático le dio a la referencia el dato «la Mancha» porque el resumen dice «una mancha», que es otra cosa; y no le dio «rocín» al resumen de base porque Whisper escribió «rocin», sin tilde. Las palabras clave sirven para una primera medida rápida, pero hay que leer los resúmenes.
Para mejorar la cadena, en orden de impacto: un LLM más grande (o uno por API), un Whisper más grande, y un audio en español actual, como el tuyo, que es lo que estos modelos conocen mejor.
Errores comunes
- Usar
torchaudio.loadsintorchcodec. En las versiones nuevas detorchaudiofalla con unImportError. Lee consoundfile(sf.read) y usatorchaudiopara transformar. - Mezclar frecuencias de muestreo. Un modelo entrenado a 16 000 Hz que recibe audio a 8000 o a 44 100 Hz «oye» la voz más aguda o más grave y se equivoca sin avisar. Remuestrea siempre a lo que espera el modelo (
torchaudio.functional.resample). - Olvidar que el audio puede venir en estéreo.
sf.readdevuelve una matriz (muestras, 2); promedia los canales antes de seguir. - Leer mal los ejes del espectrograma. El horizontal es el tiempo, el vertical es la frecuencia y la tinta es la intensidad. Una raya horizontal es un tono que dura; una raya vertical es un golpe corto.
- Elegir mal la ventana de la STFT. Larga: buenas frecuencias, malos instantes. Corta: al revés. Para voz, unos 25 ms con saltos de 10 ms.
- Comparar espectrogramas de distinto largo en una CNN sin recortar ni rellenar. Los tensores de un lote tienen que tener la misma forma; o igualas los audios o usas un pooling adaptativo al final.
- No estandarizar el log-Mel. Sus valores van de −14 a +5 y la red aprende mucho peor. Resta la media y divide por la desviación del entrenamiento.
- Medir el WER sin normalizar, o sin decir cómo normalizaste. Mayúsculas, comas, cifras y ortografía cambian el número. Dos WER solo se comparan si se normalizaron igual.
- Pasarle a Whisper más de 30 s sin
return_timestamps=True. Da unValueErrorpor tener más de 3000 cuadros. - Creer que una transcripción sin errores visibles es correcta. Whisper escribe frases fluidas incluso cuando se equivoca («haciendo» en lugar de «hacienda»). Mide con una referencia.
- Grabar a alguien sin su permiso. La voz es un dato personal. Pide permiso antes de grabar y antes de compartir un audio o su transcripción.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Cargar audio, explicar la frecuencia de muestreo y graficar la onda (ejercicio 2 y el paso 1 del mini-proyecto, al leer tu propio audio).
- Calcular un espectrograma y un espectrograma de Mel y explicar sus ejes (ejercicios 1 y 2).
- Clasificar audios cortos con una CNN sobre espectrogramas o con embeddings de HuBERT (la teoría y el ejercicio 5).
- Transcribir audio en español con Whisper y medir el WER (ejercicios 3 y 4, y pasos 1 y 3 del mini-proyecto).
- Describir qué hacen los modelos de audio y lenguaje, como Qwen-Audio y Voxtral, y cuándo conviene usarlos (ejercicio 6).