Antes de empezar
Varios ejercicios usan las variables y funciones de la teoría: foto, ruta_video, iou, iou_matriz, nms, detectar, detectar_detr, frcnn, CLASES, crudas, clases_crudas, puntajes_crudos, resultados, UNet, doble_conv, predecir_mascaras, iou_clases, dice_clase, cargador, x_val, y_val y unet. Abre un cuaderno nuevo en Colab, pega y ejecuta en orden los bloques de la ficha Código y después trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta.
Ejercicios
1. IoU a mano
Calcula sin computadora el IoU de la caja A = [2, 2, 6, 6] (en formato xyxy) con cada una de estas:
- B = [4, 4, 8, 8]
- C = [3, 2, 7, 6]
- D = [6, 2, 10, 6]
Después compruébalo con la función iou de la teoría.
Respuesta
A mide 4 × 4, así que su área es 16; las otras tres también.
- La intersección es [4, 4, 6, 6], de 2 × 2 = 4. La unión es 16 + 16 − 4 = 28. IoU = 4 / 28 ≈ 0,143. Correr una caja la mitad de su lado en las dos direcciones deja muy poco IoU.
- La intersección es [3, 2, 6, 6], de 3 × 4 = 12. La unión es 16 + 16 − 12 = 20. IoU = 12 / 20 = 0,6.
- La intersección sería [6, 2, 6, 6]: ancho 0. Las cajas solo comparten un borde, así que el IoU es 0.
A = [2, 2, 6, 6]
for nombre, otra in [("B", [4, 4, 8, 8]), ("C", [3, 2, 7, 6]),
                     ("D", [6, 2, 10, 6])]:
    print(f"IoU(A, {nombre}) = {iou(A, otra):.3f}")
IoU(A, B) = 0.143
IoU(A, C) = 0.600
IoU(A, D) = 0.0002. Formatos mezclados
Una persona anotó a mano el auto plateado de la foto con la caja [251, 536, 97, 93], en formato xywh. Faster R-CNN lo detectó con la caja [254, 535, 344, 613], en xyxy. Calcula el IoU entre las dos sin convertir la anotación y después convirtiéndola. ¿Qué concluirías en cada caso? Usa box_convert de torchvision.ops para convertir.
Respuesta
from torchvision.ops import box_convert

anotada_xywh = torch.tensor([[251., 536., 97., 93.]])
detectada = [254, 535, 344, 613]

mal = iou(anotada_xywh[0].tolist(), detectada)
anotada = box_convert(anotada_xywh, in_fmt="xywh", out_fmt="xyxy")
bien = iou(anotada[0].tolist(), detectada)
print("Anotación convertida:", anotada[0].tolist())
print(f"IoU sin convertir: {mal:.3f}")
print(f"IoU convirtiendo:  {bien:.3f}")
Anotación convertida: [251.0, 536.0, 348.0, 629.0]
IoU sin convertir: 0.000
IoU convirtiendo: 0.761Sin convertir, la anotación se lee como una caja «al revés» (su x₂ = 97 queda a la izquierda de su x₁ = 251), y el IoU da 0: concluirías que el detector falló. Convirtiendo, el IoU es 0,761: un acierto claro (pasa con holgura el 0,5 de costumbre). El código no avisa nada en ninguno de los dos casos; por eso conviene dibujar las cajas sobre la foto antes de confiar en un número.
3. NMS a mano
Un detector devuelve cinco cajas de la misma clase:
| Caja | xyxy | Puntaje |
|---|---|---|
| A | [0, 0, 10, 10] | 0,90 |
| B | [1, 1, 11, 11] | 0,80 |
| C | [20, 0, 30, 10] | 0,75 |
| D | [0, 2, 10, 12] | 0,60 |
| E | [22, 1, 32, 11] | 0,30 |
Aplica NMS a mano con umbral de IoU 0,5 y después con 0,6. ¿Qué cajas quedan en cada caso? Pista: calcula primero los IoU de A con B y con D, y de C con E.
Respuesta
Los IoU que importan (todas las cajas tienen área 100):
- A y B se cruzan en [1, 1, 10, 10], de 9 × 9 = 81: IoU = 81 / (200 − 81) ≈ 0,68.
- A y D se cruzan en [0, 2, 10, 10], de 10 × 8 = 80: IoU = 80 / 120 ≈ 0,67.
- C y E se cruzan en [22, 1, 30, 10], de 8 × 9 = 72: IoU = 72 / 128 ≈ 0,56.
- A, B y D no tocan a C ni a E.
Con umbral 0,5. Se queda A (0,90) y borra B y D, que pasan de 0,5. Quedan C y E: se queda C y borra E (0,56). Resultado: A y C.
Con umbral 0,6. Se queda A y borra B y D, como antes. Se queda C, pero E (0,56) ya no pasa de 0,6 y sobrevive. Resultado: A, C y E. Si E es una segunda caja sobre el mismo objeto que C, ese objeto se contaría dos veces.
cinco = np.array([[0, 0, 10, 10], [1, 1, 11, 11], [20, 0, 30, 10],
                  [0, 2, 10, 12], [22, 1, 32, 11]], dtype=float)
puntajes5 = np.array([0.90, 0.80, 0.75, 0.60, 0.30])
letras = "ABCDE"
print(np.round(iou_matriz(cinco, cinco), 2))
for umbral in [0.5, 0.6]:
    quedan = nms(cinco, puntajes5, umbral)
    print(f"Umbral {umbral}:", [letras[i] for i in quedan])
[[1. 0.68 0. 0.67 0. ]
[0.68 1. 0. 0.68 0. ]
[0. 0. 1. 0. 0.56]
[0.67 0.68 0. 1. 0. ]
[0. 0. 0.56 0. 1. ]]
Umbral 0.5: ['A', 'C']
Umbral 0.6: ['A', 'C', 'E']4. NMS por clase
La función nms de la teoría trata todas las cajas igual: una caja de «persona» podría borrar una de «bicicleta» si se cruzan mucho, aunque sean dos objetos distintos (una persona montada en su bicicleta). Escribe nms_por_clase(cajas, puntajes, clases, umbral_iou) que aplique nms por separado a cada clase y devuelva los índices que quedan, de mayor a menor puntaje. Compárala con batched_nms de torchvision.ops en las 15 cajas crudas de Faster R-CNN y en las 41 de DETR.
Respuesta
from torchvision.ops import batched_nms


def nms_por_clase(cajas, puntajes, clases, umbral_iou=0.5):
    quedan = []
    for clase in set(clases):
        # Los índices de las cajas de esta clase
        indices = np.array([i for i, c in enumerate(clases) if c == clase])
        for j in nms(cajas[indices], puntajes[indices], umbral_iou):
            quedan.append(int(indices[j]))
    return sorted(quedan, key=lambda i: -puntajes[i])


for nombre, (cajas, clases, puntajes) in [
        ("Faster R-CNN", (crudas, clases_crudas, puntajes_crudos)),
        ("DETR", resultados["DETR"])]:
    mias = nms_por_clase(cajas, puntajes, clases)
    codigos = torch.tensor([CLASES.index(c) for c in clases])
    suyas = batched_nms(torch.tensor(cajas), torch.tensor(puntajes),
                        codigos, 0.5).tolist()
    print(f"{nombre}: quedan {len(mias)}; ¿igual que torchvision?",
          mias == suyas)
Faster R-CNN: quedan 6; ¿igual que torchvision? True
DETR: quedan 36; ¿igual que torchvision? Truenms recibe solo las cajas de una clase, así que los índices que devuelve son posiciones dentro de indices; hay que traducirlos con indices[j] a posiciones de la lista completa. Ese es el error más común al escribir esta función.
5. Elegir los umbrales
Para cada caso, ¿pondrías el umbral de confianza alto o bajo? ¿Y el umbral de IoU de la NMS? Explica qué error es más caro en cada uno.
- Contar cuántas personas cruzan una plaza cada hora, para una estadística de la municipalidad.
- Detectar baches en las fotos de una cámara montada en un auto, para mandar una cuadrilla a repararlos.
Respuesta
- Contar personas. Aquí los dos errores pesan parecido: una falsa alarma suma una persona de más y una persona perdida, una de menos. Conviene un umbral de confianza intermedio (alrededor de 0,5 o 0,7) y elegirlo comparando con conteos hechos a mano en algunos cuadros. El umbral de IoU de la NMS no debe ser bajo: en una plaza la gente camina en grupos, sus cajas se cruzan, y con un umbral bajo la NMS borraría personas de verdad. Además, para contar personas distintas hace falta seguimiento, no solo contar por cuadro.
- Baches. Perder un bache es caro (un accidente, una rueda rota) y una falsa alarma cuesta poco si una persona revisa la foto antes de mandar a la cuadrilla. Conviene un umbral de confianza bajo (más exhaustividad) y una revisión humana. Hay un problema previo: COCO no tiene la clase «bache», así que ninguno de los detectores del tema lo encuentra. Habría que anotar fotos propias y ajustar un detector, como hiciste con los modelos preentrenados en el tema «Visión moderna».
6. La exactitud que engaña
Calcula la exactitud por píxel y el IoU de cada clase de un «modelo» que responde «fondo» en todos los píxeles de las imágenes de validación. Compáralos con los de la U-Net entrenada. ¿Cuál de las dos medidas te habría alertado?
Respuesta
todo_fondo = torch.zeros_like(y_val)
pred = predecir_mascaras(unet, x_val)
for nombre, p in [("Siempre fondo", todo_fondo), ("U-Net", pred)]:
    exactitud = (p == y_val).float().mean().item()
    fondo, circulo, cuadrado = iou_clases(p, y_val)
    print(f"{nombre}: exactitud {exactitud:.3f}, IoU fondo {fondo:.2f}, "
          f"círculo {circulo:.2f}, cuadrado {cuadrado:.2f}")
Siempre fondo: exactitud 0.896, IoU fondo 0.90, círculo 0.00, cuadrado 0.00
U-Net: exactitud 0.996, IoU fondo 1.00, círculo 0.94, cuadrado 0.94Con la exactitud por píxel, el modelo que no ve nada saca 0,896, cerca del 0,996 de la U-Net. Con el IoU de las formas, saca 0: no encontró ningún círculo ni cuadrado. El IoU por clase (o el Dice) es el que alerta. Fíjate en que el IoU del fondo también es alto para los dos: por eso se mira cada clase, y no solo el promedio.
7. Dice e IoU
- Demuestra que, para dos máscaras cualesquiera, Dice = 2 · IoU / (1 + IoU). Pista: llama I a la intersección y U a la unión, y recuerda que |A| + |B| = U + I.
- Comprueba la fórmula con los valores de la U-Net para el círculo.
- ¿Puede un modelo tener mejor IoU que otro y peor Dice?
Respuesta
- IoU = I / U, y Dice = 2I / (|A| + |B|) = 2I / (U + I). Dividiendo arriba y abajo por U: Dice = 2 (I/U) / (1 + I/U) = 2 · IoU / (1 + IoU).
- Con el código:
iou_c = iou_clases(pred, y_val)[1]
print(f"IoU del círculo: {iou_c:.4f}")
print(f"2·IoU/(1 + IoU): {2 * iou_c / (1 + iou_c):.4f}")
print(f"Dice calculado:  {dice_clase(pred, y_val, 1):.4f}")
IoU del círculo: 0.9371
2·IoU/(1 + IoU): 0.9675
Dice calculado: 0.9675- No. La función 2x / (1 + x) crece siempre entre 0 y 1, así que si un modelo tiene mayor IoU que otro en una clase, también tiene mayor Dice. Las dos medidas ordenan igual a los modelos de una clase; solo cambia la escala (el Dice da números más altos). Al promediar varias clases o varias imágenes sí pueden ordenar distinto, porque el promedio de los Dice no es el Dice del promedio.
8. Una U-Net sin saltos
Copia la U-Net quitando las conexiones de salto: el decodificador solo recibe lo que sube del nivel de abajo. Entrénala 8 épocas como en la teoría y compara el IoU final de las formas. ¿Qué crees que pierde?
Respuesta
Sin torch.cat, cada doble_conv del decodificador recibe la mitad de canales.
class UNetSinSaltos(UNet):
    def __init__(self, clases=3):
        super().__init__(clases)
        self.dec2 = doble_conv(16, 16)
        self.dec1 = doble_conv(8, 8)

    def forward(self, x):
        c1 = self.cod1(x)
        c2 = self.cod2(self.bajar(c1))
        centro = self.centro(self.bajar(c2))
        d2 = self.dec2(self.subir2(centro))       # sin c2
        d1 = self.dec1(self.subir1(d2))           # sin c1
        return self.salida(d1)


torch.manual_seed(0)
sin_saltos = UNetSinSaltos().to(device)
optimizador = torch.optim.Adam(sin_saltos.parameters(), lr=3e-3)
for epoca in range(1, 9):
    sin_saltos.train()
    for x, y in cargador:
        x, y = x.to(device), y.to(device)
        optimizador.zero_grad()
        perdida = nn.CrossEntropyLoss()(sin_saltos(x), y)
        perdida.backward()
        optimizador.step()

for nombre, modelo in [("Con saltos", unet), ("Sin saltos", sin_saltos)]:
    _, circulo, cuadrado = iou_clases(predecir_mascaras(modelo, x_val),
                                      y_val)
    print(f"{nombre}: IoU círculo {circulo:.2f}, cuadrado {cuadrado:.2f}")
Con saltos: IoU círculo 0.94, cuadrado 0.94
Sin saltos: IoU círculo 0.90, cuadrado 0.92Sin saltos, el IoU baja de 0,94 a 0,90 en los círculos y a 0,92 en los cuadrados. La diferencia es chica porque nuestras formas son simples y la red baja solo dos veces de resolución (hasta 12 × 12). Aun así, sin saltos el decodificador tiene que reconstruir el contorno exacto de cada forma a partir de ese mapa chico, y lo esperable es que los errores se junten en los bordes: compruébalo dibujando las predicciones de los dos modelos para la misma imagen. En imágenes reales, con bordes finos y más bajadas de resolución, los saltos hacen una diferencia mucho mayor.
9. Encuentra el error
Alguien quiere comparar con torchvision el IoU de dos cajas que tiene en NumPy y escribe esto. ¿Qué falla y cómo se arregla?
from torchvision.ops import box_iou

caja_a = np.array([[0, 0, 10, 10]], dtype=float)
caja_b = np.array([[5, 0, 15, 10]], dtype=float)
print(box_iou(caja_a, caja_b))
Traceback (most recent call last):
...
AttributeError: 'numpy.ndarray' object has no attribute 'is_floating_point'Respuesta
Las funciones de torchvision.ops (box_iou, nms, batched_nms, box_convert) trabajan con tensores de PyTorch, no con arreglos de NumPy. El mensaje lo dice a su manera: buscó un método de los tensores (is_floating_point) en un numpy.ndarray. Se arregla convirtiendo con torch.tensor (o torch.from_numpy):
print(box_iou(torch.tensor(caja_a), torch.tensor(caja_b)))tensor([[0.3333]], dtype=torch.float64)Es el mismo 1/3 que calculaste en la teoría con iou.
Mini-proyecto: contar vehículos en tu video
Vas a grabar un video corto, contar los vehículos de cada cuadro con dos detectores y graficar el conteo por segundo.
1. Graba el video. De 10 a 30 segundos, con el teléfono quieto (apoyado en algo), mirando una calle o una avenida desde una vereda, un puente peatonal o una ventana. Elige un lugar público y un encuadre donde no haya personas reconocibles en primer plano. Súbelo a Colab (el ícono de carpeta, a la izquierda) y cambia RUTA por el nombre de tu archivo. Los videos del celular (.mov de iPhone, o los que pasan por WhatsApp) a veces no se abren con OpenCV; si la función de abajo dice que no pudo abrirlo, conviértelo en una celda de Colab con !ffmpeg -i mi_video.mov -c:v libx264 mi_calle.mp4 y usa mi_calle.mp4. Mientras tanto, el código usa el video de la autopista de la teoría.
2. Una función que cuenta por segundo. Los detectores dan conteos que saltan de un cuadro a otro. Para suavizarlos, toma varios cuadros de cada segundo y quédate con la mediana de sus conteos (como el promedio, pero sin dejarse llevar por un cuadro raro).
RUTA = ruta_video     # cambia por tu video, por ejemplo "mi_calle.mp4"
VEHICULOS = {"car", "bus", "truck", "motorcycle"}


def contar_por_segundo(ruta, detector, buscadas, cada=15):
    """Mediana, en cada segundo, de los objetos buscados por cuadro."""
    video = cv2.VideoCapture(str(ruta))
    fps = video.get(cv2.CAP_PROP_FPS)
    if not video.isOpened() or fps == 0:
        raise ValueError(f"No se pudo abrir {ruta}: conviértelo a .mp4")
    por_segundo = {}
    i = 0
    while True:
        ok, cuadro = video.read()
        if not ok:
            break
        if i % cada == 0:
            rgb = Image.fromarray(cv2.cvtColor(cuadro, cv2.COLOR_BGR2RGB))
            _, clases, _ = detector(rgb)
            n = sum(c in buscadas for c in clases)
            por_segundo.setdefault(int(i // fps), []).append(n)
        i += 1
    video.release()
    segundos = sorted(por_segundo)
    return segundos, [float(np.median(por_segundo[s])) for s in segundos]


segundos, con_frcnn = contar_por_segundo(
    RUTA, lambda f: detectar(frcnn, f), VEHICULOS)
_, con_detr = contar_por_segundo(RUTA, detectar_detr, VEHICULOS)
print("Segundo:     ", segundos)
print("Faster R-CNN:", con_frcnn)
print("DETR:        ", con_detr)
Segundo: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12]
Faster R-CNN: [7.0, 8.0, 5.0, 7.0, 7.5, 5.0, 8.0, 10.0, 8.5, 7.5, 7.5, 6.0, 6.0]
DETR: [30.0, 24.0, 26.0, 29.5, 27.0, 26.0, 30.0, 29.5, 27.0, 29.5, 28.5, 27.5, 26.0]3. Grafica. Las dos series en el mismo gráfico, con el tiempo en el eje horizontal.
plt.plot(segundos, con_frcnn, marker="o", color="C2",
         label="Faster R-CNN")
plt.plot(segundos, con_detr, marker="o", color="C1", label="DETR")
plt.xlabel("Segundo del video")
plt.ylabel("Vehículos (mediana)")
plt.ylim(0, None)
plt.legend()
plt.title("Vehículos visibles en cada segundo")
plt.show()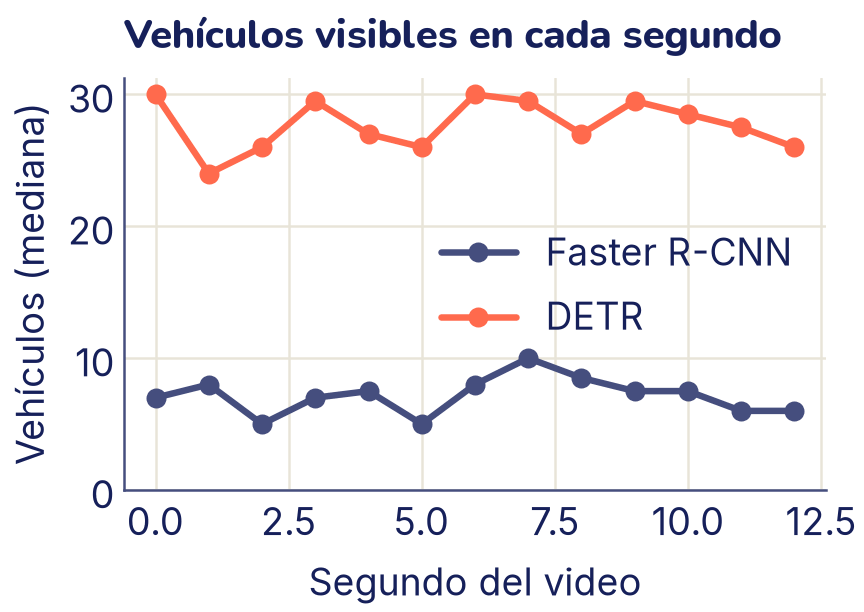
4. ¿Quién tiene razón? Elige un cuadro, cuenta los vehículos a mano y compara con los dos detectores. Dibuja las cajas de cada uno sobre ese cuadro (con dibujar_cajas) y mira cuáles se pierden.
5. Para ir más lejos. Escribe un seguimiento simple: entre dos cuadros analizados seguidos, empareja cada caja con la caja del cuadro anterior con la que tenga mayor IoU (si pasa de 0,3) y dale el mismo número; las que no se emparejan son objetos nuevos. Con eso puedes contar cuántos vehículos distintos aparecieron. Para que funcione, analiza cuadros más seguidos (cada=3): si los autos se mueven mucho entre dos cuadros, sus cajas ya no se cruzan.
Qué deberías ver
Con el video de la autopista, Faster R-CNN ve entre 5 y 10 vehículos a la vez en cada segundo del video y DETR entre 24 y 30: los dos siguen el mismo tráfico, pero DETR ve unas cuatro veces más. Si miras el cuadro de la teoría, hay varias decenas de autos a la vista, la mayoría chicos y lejanos: Faster R-CNN a 320 píxeles se pierde casi todos. DETR tarda varias veces más por cuadro (recuerda los tiempos de la teoría), pero para contar es mucho mejor.
Con tu video los números serán otros. Si la calle está cerca y los autos se ven grandes, los dos detectores pueden coincidir bastante; si está lejos, pasará lo mismo que aquí. El conteo por segundo sigue sin ser «vehículos que pasaron»: para eso necesitas el seguimiento del paso 5.
Errores comunes
- Mezclar formatos de caja. xyxy, xywh y cxcywh (a veces normalizadas entre 0 y 1) son cuatro números en todos los casos; el código no falla, pero las cajas quedan mal. Dibújalas sobre la imagen antes de calcular nada.
- Olvidar que OpenCV da BGR. Si pasas un cuadro de
cv2sincv2.cvtColor(cuadro, cv2.COLOR_BGR2RGB), el modelo ve los autos rojos azules y detecta peor. - Olvidar
modelo.eval(). Los detectores detorchvisionen modo entrenamiento esperan las cajas correctas como entrada y dan un error; en la U-Net, BatchNorm se comporta distinto. - Elegir un umbral de IoU de NMS sin mirar. Muy bajo, borra objetos pegados (autos en fila, personas en grupo); muy alto, deja cajas repetidas que se cuentan dos veces.
- Aplicar NMS entre clases distintas cuando los objetos se superponen de verdad (una persona sobre su bicicleta). La NMS se aplica por clase.
- Medir la segmentación con la exactitud por píxel. Cuando el fondo es la mayoría, un modelo que no ve nada saca una exactitud alta. Mide IoU o Dice por clase.
- Aumentar la imagen y no la etiqueta. Si volteas o recortas la imagen, la caja y la máscara tienen que cambiar igual. Usa
torchvision.transforms.v2contv_tensors. - Contar por cuadro y llamarlo «vehículos que pasaron». El mismo auto aparece en muchos cuadros; para contar objetos distintos hace falta seguimiento.
- Creer que el detector ve lo que tú ves. Los modelos a 320 píxeles pierden los objetos chicos y se equivocan de clase (el peatón «bicicleta»). Revisa siempre algunas detecciones a ojo.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Explicar las cajas delimitadoras y sus formatos, y calcular el IoU (ejercicios 1 y 2).
- Explicar y programar la supresión de no máximos (ejercicios 3 y 4).
- Usar detectores preentrenados de una etapa (SSD, como YOLO), de dos etapas (Faster R-CNN) y basados en transformers (DETR) en fotos y en cuadros de video, y comparar su velocidad y su calidad (ejercicio 5 y pasos 2 a 4 del mini-proyecto).
- Explicar la U-Net: codificador, decodificador y conexiones de salto (ejercicio 8).
- Entrenar una U-Net pequeña y medirla con IoU y Dice, entendiendo por qué la exactitud por píxel engaña (ejercicios 6 y 7).
- Procesar un video como una secuencia de cuadros (pasos 2 y 3 del mini-proyecto).