La pregunta
Mira una foto de una zapatilla. La reconoces al instante, aunque esté un poco más a la izquierda, un poco más arriba o un poco más chica que la última que viste. ¿Cómo lo hace tu cerebro? No compara la foto píxel por píxel con una zapatilla guardada en la memoria: primero nota bordes, después formas hechas de bordes (una suela, unos cordones) y recién al final junta las formas en «zapatilla».
El MLP de los temas 18 y 19 no trabaja así. Lo primero que hace es aplanar la imagen de 28 × 28 en una fila de 784 números, y desde ese momento ya no sabe qué píxel estaba al lado de cuál. Si la zapatilla se corre un píxel a la derecha, para el MLP es otra fila de números completamente distinta, y tiene que aprender lo mismo una y otra vez en cada posición.
Las redes convolucionales (CNN, por convolutional neural networks) arreglan eso con una idea sencilla: en lugar de mirar toda la imagen de golpe, pasan una ventanita pequeña por toda la imagen y buscan con ella el mismo patrón en todas partes. Con esa idea se reconocen caras, se leen placas de autos y se detectan enfermedades en radiografías.
En este tema vas a:
- calcular a mano una convolución 2D y el tamaño de su salida, con padding y stride;
- programarla desde cero en NumPy y usarla para encontrar los bordes de una foto con el filtro Sobel;
- explicar el pooling máximo y promedio, y por qué da cierta tolerancia a pequeños movimientos;
- construir y entrenar una CNN en PyTorch y compararla con un MLP del mismo tamaño, midiendo de verdad;
- mirar por dentro lo que aprendió la red: sus filtros y sus mapas de activación;
- multiplicar tus datos con aumentación de imágenes usando
torchvision.transforms.
Necesitas lo de los temas 18 y 19: tensores, nn.Module, DataLoader, el bucle de entrenamiento y el optimizador Adam. Del tema 3 te sirve recordar que una imagen es un arreglo de números.
Actividad: dibuja y filtra
Dibuja algo en la cuadrícula de la izquierda: un número, una letra, una raya. Al lado ves lo que sale al pasarle un filtro de 3 × 3: cada casilla del resultado es la suma de los nueve productos entre el filtro y el pedazo de dibujo que tiene debajo. Las casillas en tinta son resultados positivos; las coral, negativos. A la derecha, la misma salida achicada con max-pooling: de cada bloque de 2 × 2 casillas se queda solo el número más grande.
Dibuja y filtra
Este es el estado inicial: un 7 filtrado con «Bordes verticales». Con JavaScript activado puedes dibujar, cambiar el filtro y mover la ventana.
Con el foco en el dibujo, las flechas mueven el cursor; Espacio pinta la casilla con la herramienta elegida; con Mayúsculas y una flecha, se pinta mientras se avanza. Con el foco en el mapa de activación, las flechas mueven la ventana.
- positivo
- negativo
- cero
- Cuanto más intenso, más lejos de cero. La escala se ajusta al valor más grande del mapa.
Dibujar
Mover el dibujo un casillero
Filtro 3 × 3
La cuenta de la ventana
Fila 15, columna 14 del mapa
Suma = 3,60
Dibuja en la cuadrícula o elige otro filtro. Toca una casilla del mapa para ver de dónde sale.
Prueba esto, en orden:
- Elige el filtro «Bordes verticales» y dibuja una raya vertical gruesa. ¿Dónde aparece la tinta y dónde el coral? ¿Qué pasa si la raya es horizontal?
- Pulsa «Recorrer» y mira la ventana pasar por el dibujo. Detenla, o toca una casilla del mapa, y comprueba la cuenta de «La cuenta de la ventana»: nueve productos y su suma.
- Cambia a «Desenfoque» y después a «Nitidez». ¿Qué le hace cada uno a tu dibujo?
- Escribe tus propios números en el filtro. ¿Puedes inventar uno que encuentre las rayas diagonales?
- Mueve el dibujo un casillero con las flechas de «Mover el dibujo» y lee el mensaje de abajo: ¿cuántas casillas cambiaron en el mapa de activación y cuántas en el max-pooling? Repite varias veces. ¿Cambia siempre el max-pooling?
Esa es la idea entera de una CNN. Una red convolucional tiene muchos filtros como este, pero no los escribe nadie: empiezan con números al azar y el descenso de gradiente los ajusta, igual que ajustaba los pesos del MLP.
Una imagen es una tabla de números
Vamos a trabajar con FashionMNIST, el conjunto de 70 000 fotos de prendas en blanco y negro de 28 × 28 píxeles que ya usaste en el tema 18. Lo cargamos sin transformar, para ver los números tal como vienen.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.colors import LinearSegmentedColormap
import torch
from torch import nn
from torchvision import datasets

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

# La primera vez descarga unos 30 MB; después queda guardado en «datos»
entrenamiento = datasets.FashionMNIST(root="datos", train=True,
                                      download=True)
prueba = datasets.FashionMNIST(root="datos", train=False, download=True)
nombres = ["camiseta", "pantalón", "suéter", "vestido", "abrigo",
           "sandalia", "camisa", "zapatilla", "bolso", "botín"]

print(entrenamiento.data.shape, entrenamiento.data.dtype)
prenda = entrenamiento.data[0].numpy() / 255   # números entre 0 y 1
print("Etiqueta:", nombres[entrenamiento.targets[0]])
# Filas 6 a 10, columnas 9 a 16: un pedazo del borde de la prenda
print(np.round(prenda[6:11, 9:17], 1))
torch.Size([60000, 28, 28]) torch.uint8
Etiqueta: botín
[[0. 0. 0. 0. 0. 0.6 0.9 0.8]
[0. 0. 0. 0. 0.3 0.8 0.9 0.9]
[0. 0. 0. 0. 0.8 0.9 0.9 0.9]
[0. 0. 0. 0. 0.7 0.9 0.8 0.9]
[0. 0. 0. 0. 0.8 0.9 0.9 0.8]]Cada imagen es una tabla de 28 filas y 28 columnas, con un número de 0 (negro) a 255 (blanco) por píxel; al dividir por 255 queda entre 0 y 1. El pedazo que imprimimos es parte del borde izquierdo de la caña del botín: los ceros son el fondo negro y los números altos, la prenda. Un borde es justamente eso: un lugar donde los números cambian de golpe.
Una red de PyTorch espera las imágenes con una forma más: (C, H, W), canales × alto × ancho. Una foto en color tiene 3 canales (rojo, verde y azul); estas prendas tienen uno solo. Un lote de imágenes, como el que entrega un DataLoader, es (N, C, H, W): en el tema 3 la viste como (N, alto, ancho, 3), con los canales al final; PyTorch los pone antes del alto y el ancho.
La convolución: una ventana que recorre la imagen
Un filtro (también se dice núcleo o kernel) es una tabla chica de pesos, por ejemplo de 3 × 3. La convolución lo apoya sobre la esquina de arriba a la izquierda de la imagen, multiplica cada peso por el píxel que tiene debajo y suma los nueve productos: ese número es la primera casilla de la salida. Después corre el filtro un píxel a la derecha y repite. Al terminar la fila, baja un píxel y vuelve a empezar. Con I la imagen y K el filtro de k × k, la casilla (i, j) de la salida es:
Es el producto punto del tema 3 entre el filtro y un pedazo de la imagen. Y el producto punto mide parecido: la salida es grande donde el pedazo de imagen se parece al filtro. Por eso a la salida se le llama mapa de activación: es un mapa de dónde está el patrón que busca el filtro.
Programémosla tal cual, con dos bucles: uno para las filas de la salida y otro para las columnas.
def convolucion2d(imagen, filtro, padding=0, stride=1):
    """Desliza `filtro` sobre `imagen` y suma los productos."""
    if padding > 0:
        # Un marco de ceros alrededor de la imagen
        imagen = np.pad(imagen, padding)
    k = filtro.shape[0]
    alto = (imagen.shape[0] - k) // stride + 1
    ancho = (imagen.shape[1] - k) // stride + 1
    salida = np.zeros((alto, ancho))
    for i in range(alto):
        for j in range(ancho):
            fila, col = i * stride, j * stride
            ventana = imagen[fila:fila + k, col:col + k]
            salida[i, j] = np.sum(ventana * filtro)
    return salida

# Filtro Sobel horizontal: resta la izquierda de la derecha
sobel_x = np.array([[-1, 0, 1],
                    [-2, 0, 2],
                    [-1, 0, 1]])
# Una imagen chiquita: oscura a la izquierda, clara a la derecha
mini = np.array([[0, 0, 0, 9, 9],
                 [0, 0, 0, 9, 9],
                 [0, 0, 0, 9, 9],
                 [0, 0, 0, 9, 9],
                 [0, 0, 0, 9, 9]])
print(convolucion2d(mini, sobel_x))
[[ 0. 36. 36.]
[ 0. 36. 36.]
[ 0. 36. 36.]]Hagamos a mano la casilla del medio de la primera fila. La ventana cubre las columnas 1, 2 y 3 de las filas 0, 1 y 2: la columna de la izquierda (pesos −1, −2 y −1) cae sobre ceros y la de la derecha (pesos 1, 2 y 1) cae sobre nueves. La suma es 9 + 18 + 9 = 36. En la primera columna de la salida, la ventana solo ve ceros y da 0. El filtro Sobel encuentra los lugares donde la imagen cambia de oscuro a claro al ir hacia la derecha, es decir, los bordes verticales. Su transpuesto, sobel_x.T, encuentra los bordes horizontales.
Un detalle de nombres: lo que acabamos de programar, y lo que hacen PyTorch y todas las librerías de redes, se llama en matemática correlación cruzada. La convolución «de libro» primero gira el filtro 180°. Como en una red los pesos del filtro se aprenden, da lo mismo, y todo el mundo le dice convolución.
Bordes de una foto
Probemos con una foto de verdad: la del templo que ya usaste en el tema 3. La pasamos a gris con los mismos pesos de entonces y nos quedamos con uno de cada dos píxeles para que el bucle de Python termine rápido.
from sklearn.datasets import load_sample_image

foto = load_sample_image("china.jpg")
gris = foto @ np.array([0.299, 0.587, 0.114])
# Uno de cada dos píxeles: menos ventanas que recorrer
gris = gris[::2, ::2] / 255
sobel_y = sobel_x.T

bordes_x = convolucion2d(gris, sobel_x)
bordes_y = convolucion2d(gris, sobel_y)
# Los dos bordes juntos, como la longitud de un vector
magnitud = np.sqrt(bordes_x ** 2 + bordes_y ** 2)
print("Foto en gris:", gris.shape, "  Mapa de bordes:", bordes_x.shape)
print(f"Valores de bordes_x: de {bordes_x.min():.2f} "
      f"a {bordes_x.max():.2f}")

# Blanco para el cero y tinta para los valores más altos
blanco_tinta = LinearSegmentedColormap.from_list("bt", ["white", "C0"])
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
ejes[0, 0].imshow(foto)
ejes[0, 0].set_title("Original")
# Valor absoluto: un borde es borde, suba o baje el brillo
ejes[0, 1].imshow(np.abs(bordes_x), cmap=blanco_tinta, vmax=2)
ejes[0, 1].set_title("Bordes verticales")
ejes[1, 0].imshow(np.abs(bordes_y), cmap=blanco_tinta, vmax=2)
ejes[1, 0].set_title("Bordes horizontales")
ejes[1, 1].imshow(magnitud, cmap=blanco_tinta, vmax=2)
ejes[1, 1].set_title("Los dos juntos")
for eje in ejes.flat:
    eje.axis("off")
plt.show()
Foto en gris: (214, 320) Mapa de bordes: (212, 318)
Valores de bordes_x: de -3.23 a 3.04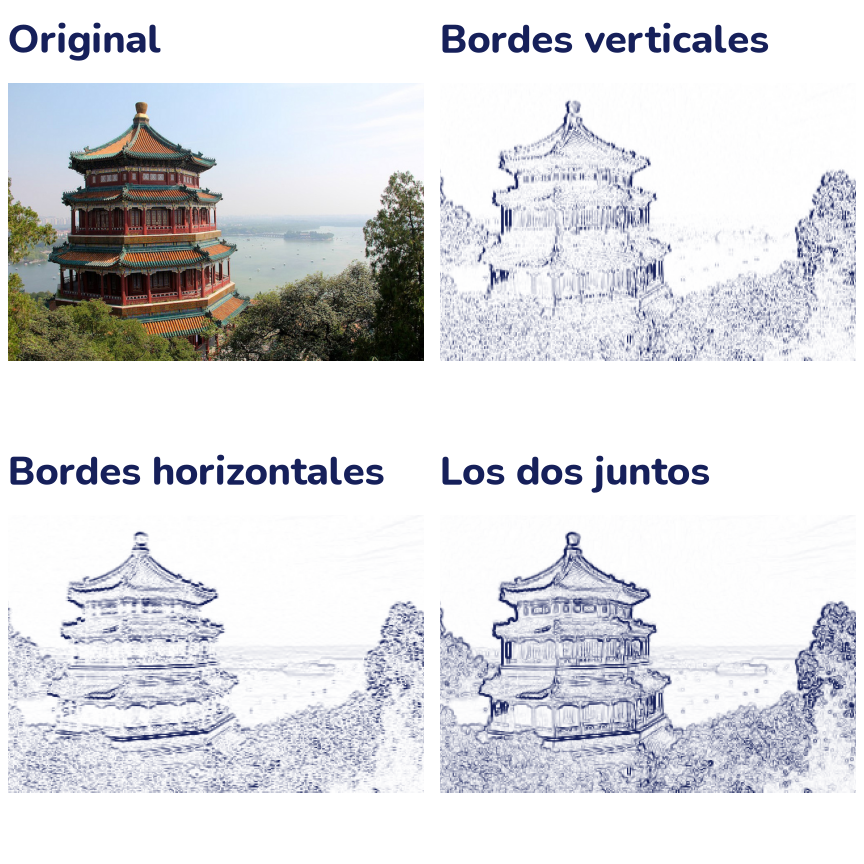
El filtro de bordes verticales marca las columnas y los costados del edificio; el de bordes horizontales, las líneas de los techos. Ninguno de los dos «sabe» qué es un templo: solo responden a cambios de brillo. Pero con mapas como estos, una segunda capa puede buscar esquinas (donde hay borde vertical y horizontal a la vez), una tercera, ventanas o tejas, y así sucesivamente. Las CNN construyen la visión por pisos.
Fíjate en que los valores de bordes_x son positivos y negativos: positivo donde la imagen se aclara hacia la derecha, negativo donde se oscurece. En la figura dibujamos el valor absoluto; en la actividad, los negativos se ven en coral.
Tamaño de la salida: padding y stride
La foto en gris mide 214 × 320 y su mapa de bordes, 212 × 318: un filtro de 3 × 3 no puede centrarse en los píxeles del borde, así que la salida pierde una fila arriba, una abajo y una columna a cada lado. Dos perillas controlan el tamaño:
- Padding (relleno): agregar un marco de p píxeles en cero alrededor de la imagen antes de filtrar. Con un filtro de 3 × 3 y p = 1, la salida queda del mismo tamaño que la entrada.
- Stride (paso): cuántos píxeles salta la ventana cada vez. Con s = 2 la ventana se apoya en una posición sí y una no, y la salida queda de la mitad de alto y de ancho.
Para una entrada de n × n, un filtro de k × k, relleno p y paso s, el lado de la salida es:
Los corchetes ⌊ ⌋ significan «redondear hacia abajo», lo mismo que hace // en Python. Comprobémoslo con la prenda de 28 × 28:
for p, s in [(0, 1), (1, 1), (1, 2), (0, 2)]:
    salida = convolucion2d(prenda, sobel_x, padding=p, stride=s)
    formula = (28 + 2 * p - 3) // s + 1
    print(f"padding {p}, stride {s}: salida {salida.shape}, "
          f"fórmula {formula}")
padding 0, stride 1: salida (26, 26), fórmula 26
padding 1, stride 1: salida (28, 28), fórmula 28
padding 1, stride 2: salida (14, 14), fórmula 14
padding 0, stride 2: salida (13, 13), fórmula 13En el último caso, (28 − 3) / 2 = 12,5 se redondea hacia abajo a 12, y la salida mide 13: la ventana no alcanza a apoyarse en la última columna, que queda sin usar.
Pooling: resumir y achicar
Después de una convolución suele venir un pooling (agrupamiento): se corta el mapa de activación en bloques de 2 × 2 y cada bloque se reemplaza por un solo número. En el max-pooling ese número es el máximo del bloque; en el average-pooling, el promedio. El mapa queda de la mitad de alto y de ancho, con la cuarta parte de los números, y las capas siguientes trabajan menos.
Para programarlo no hace falta un bucle: con reshape partimos el mapa en bloques y con max o mean sobre los ejes 1 y 3 resumimos cada bloque.
def pooling2d(mapa, tam=2, modo="max"):
    """Resume cada bloque de tam × tam con su máximo o su promedio."""
    alto, ancho = mapa.shape[0] // tam, mapa.shape[1] // tam
    recorte = mapa[:alto * tam, :ancho * tam]
    # Ejes: (fila de bloque, fila dentro, columna de bloque, col. dentro)
    bloques = recorte.reshape(alto, tam, ancho, tam)
    if modo == "max":
        return bloques.max(axis=(1, 3))
    return bloques.mean(axis=(1, 3))

# Un punto brillante y el mismo punto movido un píxel
punto = np.zeros((4, 4))
punto[0, 0] = 1
movido = np.zeros((4, 4))
movido[1, 1] = 1
print("Iguales antes del pooling:", np.array_equal(punto, movido))
print("Iguales después del max-pooling:",
      np.array_equal(pooling2d(punto), pooling2d(movido)))
print(pooling2d(movido))
Iguales antes del pooling: False
Iguales después del max-pooling: True
[[1. 0.]
[0. 0.]]Esta es la razón de ser del pooling. El punto se movió, pero sigue dentro del mismo bloque de 2 × 2, así que el máximo del bloque no cambia. Después del max-pooling, un detalle que se corre un píxel da el mismo resultado: la red se vuelve un poco invariante a movimientos pequeños. Solo un poco: si el punto se mueve al bloque vecino, el resultado cambia. Apilar varias capas de convolución y pooling acumula esa tolerancia.
bordes_prenda = np.abs(convolucion2d(prenda, sobel_x))
maximo = pooling2d(bordes_prenda, modo="max")
promedio = pooling2d(bordes_prenda, modo="promedio")
print(prenda.shape, bordes_prenda.shape, maximo.shape, promedio.shape)

# Los tres mapas de bordes con la misma escala, para poder compararlos
tope = bordes_prenda.max()
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
paneles = [(prenda, "Prenda 28 × 28", 1),
           (bordes_prenda, "Bordes 26 × 26", tope),
           (maximo, "Máximo 13 × 13", tope),
           (promedio, "Promedio 13 × 13", tope)]
for eje, (mapa, titulo, vmax) in zip(ejes.flat, paneles):
    eje.imshow(mapa, cmap=blanco_tinta, vmin=0, vmax=vmax)
    eje.set_title(titulo)
    eje.axis("off")
plt.show()
(28, 28) (26, 26) (13, 13) (13, 13)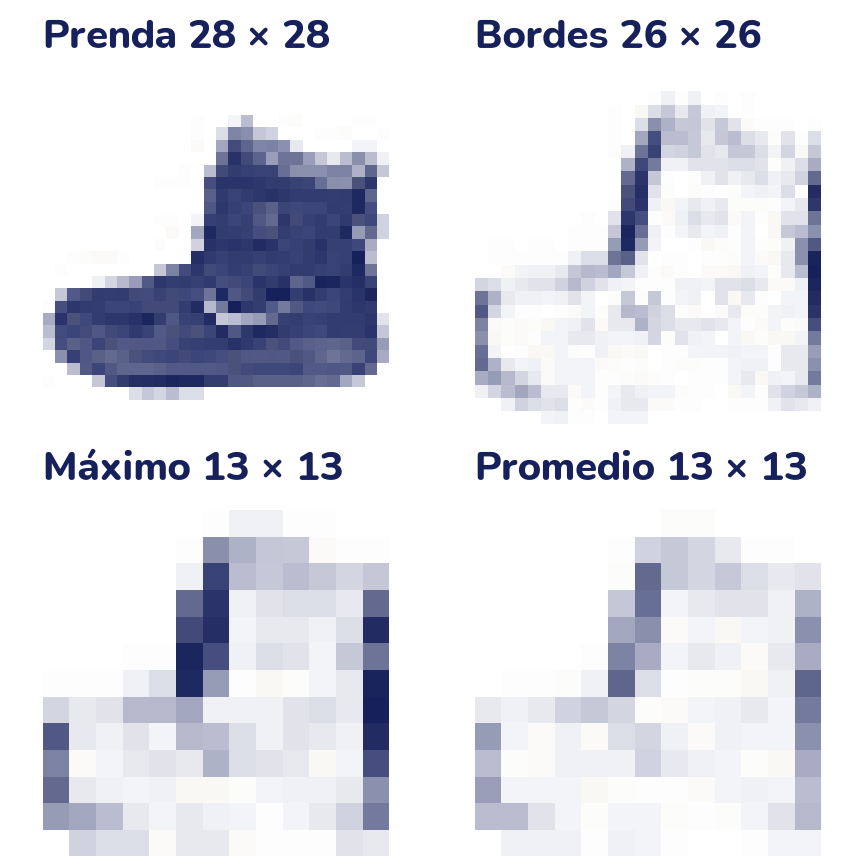
Los dos mapas de abajo tienen la cuarta parte de los números que el de bordes, y el botín todavía se reconoce. El max-pooling conserva los bordes fuertes, porque se queda con lo más alto de cada bloque; el average-pooling los suaviza, porque los mezcla con el fondo. En las capas intermedias de una CNN se usa casi siempre el máximo: lo que importa es si el patrón apareció en esa zona, no exactamente dónde.
De NumPy a PyTorch
PyTorch tiene todo esto listo y mucho más rápido. torch.nn.functional.conv2d hace la misma cuenta que nuestra función; comprobémoslo con la prenda y el filtro Sobel. Ojo con las formas: la imagen va como (N, C, H, W) y el filtro como (filtros de salida, canales de entrada, k, k).
import torch.nn.functional as F

imagen_t = torch.tensor(prenda, dtype=torch.float32).reshape(1, 1, 28, 28)
filtro_t = torch.tensor(sobel_x, dtype=torch.float32).reshape(1, 1, 3, 3)
salida_t = F.conv2d(imagen_t, filtro_t)
print(salida_t.shape)
print("¿Igual a la nuestra?",
      np.allclose(salida_t[0, 0].numpy(), convolucion2d(prenda, sobel_x),
                  atol=1e-5))
torch.Size([1, 1, 26, 26])
¿Igual a la nuestra? TrueEn una red no se usa la función suelta sino la capa nn.Conv2d, que guarda sus filtros como parámetros que se entrenan. Sus argumentos principales son in_channels (canales que entran), out_channels (cuántos filtros distintos tiene, uno por cada mapa de salida), kernel_size, padding y stride. Cada filtro tiene un peso por píxel de la ventana y por canal de entrada, más un sesgo.
capa = nn.Conv2d(in_channels=1, out_channels=16, kernel_size=3,
                 padding=1)
lote = torch.zeros(64, 1, 28, 28)            # (N, C, H, W)
print("Pesos de la capa:", tuple(capa.weight.shape))
print("Después de la convolución:", tuple(capa(lote).shape))
print("Después de MaxPool2d(2):  ",
      tuple(nn.MaxPool2d(2)(capa(lote)).shape))
print("Después de AvgPool2d(2):  ",
      tuple(nn.AvgPool2d(2)(capa(lote)).shape))
print("Después de AdaptiveAvgPool2d(1):",
      tuple(nn.AdaptiveAvgPool2d(1)(capa(lote)).shape))

def contar(modelo):
    """Cantidad total de números entrenables de un modelo."""
    return sum(p.numel() for p in modelo.parameters())

# Una capa densa que diera la misma salida: 16 × 28 × 28 números
densa = nn.Linear(28 * 28, 16 * 28 * 28)
print(f"Parámetros de la convolución: {contar(capa)}")
print(f"Parámetros de la capa densa:  {contar(densa)}")
Pesos de la capa: (16, 1, 3, 3)
Después de la convolución: (64, 16, 28, 28)
Después de MaxPool2d(2): (64, 16, 14, 14)
Después de AvgPool2d(2): (64, 16, 14, 14)
Después de AdaptiveAvgPool2d(1): (64, 16, 1, 1)
Parámetros de la convolución: 160
Parámetros de la capa densa: 9847040Mira las formas. Con 16 filtros, cada imagen de 1 canal se convierte en 16 mapas de 28 × 28 (gracias a padding=1), y el pooling los deja en 14 × 14. AdaptiveAvgPool2d(1) es el pooling global: promedia cada mapa entero y deja un solo número por canal, sea cual sea el tamaño de la imagen. Muchas CNN modernas lo usan al final, antes de la capa que clasifica.
Y mira los parámetros. La convolución tiene 16 filtros de 3 × 3 = 144 pesos, más 16 sesgos: 160 números. Una capa densa que convirtiera la imagen en esos mismos 12 544 números de salida necesitaría casi diez millones. La diferencia es que la convolución comparte sus pesos: el mismo filtro de 9 números se usa en todas las posiciones de la imagen. Eso tiene dos ventajas: la red es mucho más chica, y lo que aprende en un rincón de la imagen (un borde, una costura) lo reconoce en cualquier otro.
El campo receptivo
Cada casilla de la primera convolución depende de una ventana de 3 × 3 píxeles de la imagen: ese es su campo receptivo. Después de un max-pooling de 2 × 2, cada casilla resume dos ventanas vecinas y ve 4 × 4 píxeles. Una segunda convolución de 3 × 3 sobre ese mapa achicado mezcla tres casillas en cada dirección, que en la imagen original abarcan 8 × 8 píxeles. Cada piso de la red ve un pedazo más grande de la imagen: por eso las primeras capas encuentran bordes y las últimas, partes enteras de una prenda.
Una CNN para FashionMNIST
La arquitectura típica repite un bloque convolución → ReLU → pooling: la convolución busca patrones, la ReLU deja pasar solo los positivos (el patrón está o no está) y el pooling achica. Al final se aplanan los mapas y una capa nn.Linear decide la clase.
Los datos
Para que todo el tema corra en menos de un par de minutos en una computadora sin GPU, entrenamos con 10 000 imágenes elegidas al azar de las 60 000 de entrenamiento, y validamos con 2000 de las 10 000 de prueba, que el modelo nunca ve mientras aprende. Además, cargamos todas las imágenes de una vez como un solo tensor y usamos TensorDataset, que entrega pares (imagen, etiqueta) de ese tensor: así no hay que convertir cada imagen en cada época.
También normalizamos las imágenes: les restamos la media de los píxeles y las dividimos por su desviación estándar, calculadas con el entrenamiento, como hacías con las columnas de una tabla en los temas anteriores. Así los valores quedan centrados en cero, y el entrenamiento es más estable.
from torch.utils.data import DataLoader, TensorDataset

g = torch.Generator().manual_seed(0)
idx_ent = torch.randperm(len(entrenamiento), generator=g)[:10000]
idx_val = torch.randperm(len(prueba), generator=g)[:2000]

x_ent = entrenamiento.data[idx_ent].float() / 255
x_val = prueba.data[idx_val].float() / 255
y_ent = entrenamiento.targets[idx_ent]
y_val = prueba.targets[idx_val]

# Media y desviación del entrenamiento, para las dos partes
media, desv = x_ent.mean().item(), x_ent.std().item()
print(f"Media de los píxeles: {media:.3f}   desviación: {desv:.3f}")
# unsqueeze(1) agrega el eje del canal: (N, 28, 28) -> (N, 1, 28, 28)
x_ent = ((x_ent - media) / desv).unsqueeze(1)
x_val = ((x_val - media) / desv).unsqueeze(1)
print("Entrenamiento:", tuple(x_ent.shape), " Validación:",
      tuple(x_val.shape))

cargador_ent = DataLoader(TensorDataset(x_ent, y_ent), batch_size=64,
                          shuffle=True,
                          generator=torch.Generator().manual_seed(0))
cargador_val = DataLoader(TensorDataset(x_val, y_val), batch_size=500)
Media de los píxeles: 0.287 desviación: 0.354
Entrenamiento: (10000, 1, 28, 28) Validación: (2000, 1, 28, 28)El bucle de entrenamiento
Para entrenar usamos la función entrenar del tema 18, sin cambiar nada. Si no la tienes a mano, cópiala en tu cuaderno tal como está aquí; en el tema 18 se explica línea por línea.
import torch
from torch import nn


def evaluar(modelo, cargador, funcion_perdida, dispositivo="cpu"):
    """Pérdida media y exactitud de `modelo` sobre `cargador`."""
    modelo.eval()
    suma, aciertos, total = 0.0, 0, 0
    with torch.no_grad():
        for x, y in cargador:
            x, y = x.to(dispositivo), y.to(dispositivo)
            salida = modelo(x)
            suma += funcion_perdida(salida, y).item() * len(y)
            aciertos += (salida.argmax(dim=1) == y).sum().item()
            total += len(y)
    return suma / total, aciertos / total


def entrenar(modelo, cargador_ent, cargador_val, epocas, optimizador,
             funcion_perdida=None, planificador=None, dispositivo="cpu",
             mostrar=True):
    """Entrena `modelo` y devuelve el historial de cada época."""
    if funcion_perdida is None:
        funcion_perdida = nn.CrossEntropyLoss()
    modelo.to(dispositivo)
    historial = {"perdida_ent": [], "exactitud_ent": [],
                 "perdida_val": [], "exactitud_val": []}
    for epoca in range(1, epocas + 1):
        modelo.train()
        suma, aciertos, total = 0.0, 0, 0
        for x, y in cargador_ent:
            x, y = x.to(dispositivo), y.to(dispositivo)
            optimizador.zero_grad()
            salida = modelo(x)
            perdida = funcion_perdida(salida, y)
            perdida.backward()
            optimizador.step()
            suma += perdida.item() * len(y)
            aciertos += (salida.argmax(dim=1) == y).sum().item()
            total += len(y)
        if planificador is not None:
            planificador.step()
        perdida_val, exactitud_val = evaluar(
            modelo, cargador_val, funcion_perdida, dispositivo)
        historial["perdida_ent"].append(suma / total)
        historial["exactitud_ent"].append(aciertos / total)
        historial["perdida_val"].append(perdida_val)
        historial["exactitud_val"].append(exactitud_val)
        if mostrar:
            print(f"Época {epoca}: pérdida {suma / total:.3f}, "
                  f"validación {perdida_val:.3f}, "
                  f"exactitud de validación {exactitud_val:.3f}")
    return historial
CNN contra MLP, con el mismo tamaño
Para que la comparación sea justa, armamos dos redes con casi la misma cantidad de parámetros, unos 20 000:
- La CNN tiene dos bloques convolución → ReLU → max-pooling, con 16 y 32 filtros. La imagen pasa de (1, 28, 28) a (16, 14, 14) y después a (32, 7, 7); esos 32 × 7 × 7 = 1568 números se aplanan y una capa lineal los convierte en 10 puntajes, uno por clase.
- El MLP aplana la imagen en 784 números, tiene una capa oculta de 26 neuronas y una de salida de 10. Con 26 neuronas queda casi del mismo tamaño que la CNN.
torch.manual_seed(0)
cnn = nn.Sequential(
    nn.Conv2d(1, 16, kernel_size=3, padding=1),   # (16, 28, 28)
    nn.ReLU(),
    nn.MaxPool2d(2),                              # (16, 14, 14)
    nn.Conv2d(16, 32, kernel_size=3, padding=1),  # (32, 14, 14)
    nn.ReLU(),
    nn.MaxPool2d(2),                              # (32, 7, 7)
    nn.Flatten(),                                 # 1568
    nn.Linear(32 * 7 * 7, 10),
)
torch.manual_seed(0)
mlp = nn.Sequential(
    nn.Flatten(),                                 # 784
    nn.Linear(28 * 28, 26),
    nn.ReLU(),
    nn.Linear(26, 10),
)
print(f"Parámetros de la CNN: {contar(cnn)}")
print(f"Parámetros del MLP:   {contar(mlp)}")
Parámetros de la CNN: 20490
Parámetros del MLP: 20680Entrenamos las dos con lo mismo: Adam con tasa 0,001, lotes de 64 y 8 épocas. Primero la CNN:
torch.manual_seed(0)
hist_cnn = entrenar(cnn, cargador_ent, cargador_val, epocas=8,
                    optimizador=torch.optim.Adam(cnn.parameters(),
                                                 lr=1e-3),
                    dispositivo=device)
Época 1: pérdida 0.800, validación 0.554, exactitud de validación 0.797
Época 2: pérdida 0.471, validación 0.445, exactitud de validación 0.843
Época 3: pérdida 0.415, validación 0.438, exactitud de validación 0.847
Época 4: pérdida 0.368, validación 0.428, exactitud de validación 0.838
Época 5: pérdida 0.346, validación 0.408, exactitud de validación 0.846
Época 6: pérdida 0.319, validación 0.376, exactitud de validación 0.874
Época 7: pérdida 0.302, validación 0.391, exactitud de validación 0.865
Época 8: pérdida 0.285, validación 0.367, exactitud de validación 0.874Y ahora el MLP:
torch.manual_seed(0)
hist_mlp = entrenar(mlp, cargador_ent, cargador_val, epocas=8,
                    optimizador=torch.optim.Adam(mlp.parameters(),
                                                 lr=1e-3),
                    dispositivo=device)

epocas = range(1, 9)
plt.plot(epocas, hist_mlp["exactitud_val"], "o-", color="C0",
         label="MLP")
plt.plot(epocas, hist_cnn["exactitud_val"], "o-", color="C1",
         label="CNN")
plt.xlabel("Época")
plt.ylabel("Exactitud de validación")
plt.title("Mismo tamaño, distinta forma")
plt.legend()
plt.show()
Época 1: pérdida 0.790, validación 0.588, exactitud de validación 0.794
Época 2: pérdida 0.522, validación 0.515, exactitud de validación 0.814
Época 3: pérdida 0.470, validación 0.504, exactitud de validación 0.821
Época 4: pérdida 0.435, validación 0.499, exactitud de validación 0.815
Época 5: pérdida 0.413, validación 0.484, exactitud de validación 0.828
Época 6: pérdida 0.390, validación 0.475, exactitud de validación 0.829
Época 7: pérdida 0.376, validación 0.458, exactitud de validación 0.836
Época 8: pérdida 0.362, validación 0.455, exactitud de validación 0.835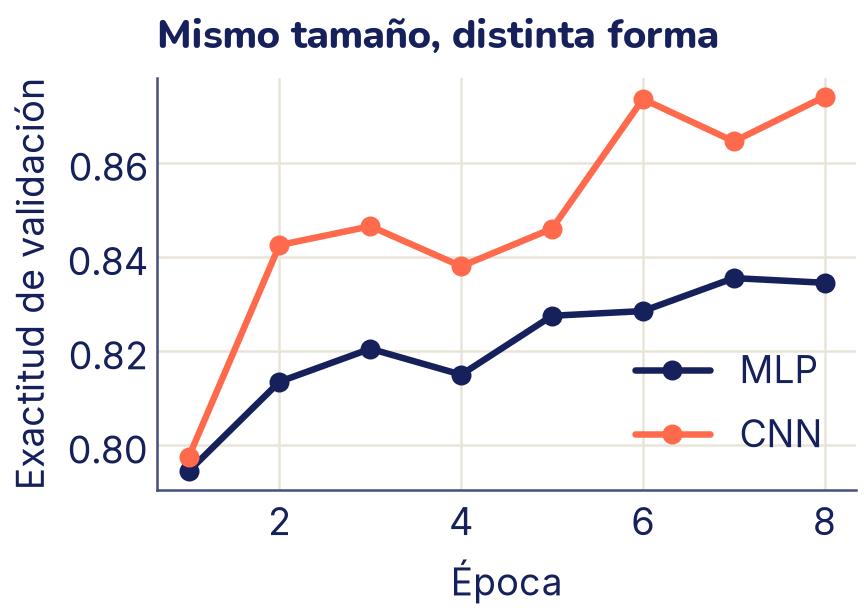
Las dos redes tienen casi el mismo tamaño (20 490 y 20 680 parámetros), vieron las mismas imágenes el mismo número de veces y se entrenaron con el mismo optimizador. Aun así, después de 8 épocas la CNN acierta el 87,4 % de las prendas de validación y el MLP, el 83,5 %. Dicho al revés: el MLP se equivoca en el 16,5 % de las prendas y la CNN en el 12,6 %, cerca de una cuarta parte menos de errores. La pérdida de validación cuenta lo mismo: 0,367 contra 0,455.
La diferencia no viene de tener más parámetros, sino de cómo se usan. El MLP gasta casi todos sus pesos en conectar cada píxel con cada neurona oculta, y tiene que aprender por separado que una costura en la esquina y una costura en el centro son lo mismo. La CNN gasta sus pesos en filtros que se reutilizan en toda la imagen.
Dos advertencias honestas. Primero, la CNN es más lenta de entrenar con los mismos parámetros, porque cada filtro se aplica en cientos de posiciones; en una computadora sin GPU lo notas. Segundo, son números de una corrida con 10 000 imágenes y 8 épocas: con otra semilla, otros datos o más épocas cambian un poco. Fíjate que las curvas suben y bajan de una época a otra (la de la CNN baja en las épocas 4 y 7): con 2000 imágenes de validación, una diferencia de un punto porcentual son apenas 20 prendas. La ventaja de la CNN, en cambio, se mantiene en todas las épocas desde la segunda.
¿Qué aprendió la CNN?
Los filtros de la primera capa son 16 tablas de 3 × 3 que empezaron al azar. Podemos dibujarlos: en cada uno, la tinta marca los pesos más altos y el blanco, los más bajos.
# cpu(): por si la red se entrenó en una GPU
filtros = cnn[0].weight.detach().cpu()        # (16, 1, 3, 3)
print(tuple(filtros.shape))

fig, ejes = plt.subplots(4, 4, figsize=(4.8, 4.8))
for k, eje in enumerate(ejes.flat):
    eje.imshow(filtros[k, 0], cmap=blanco_tinta)
    eje.set_title(f"Filtro {k}", fontsize=11)
    eje.axis("off")
plt.suptitle("Filtros de la primera capa")
plt.show()
(16, 1, 3, 3)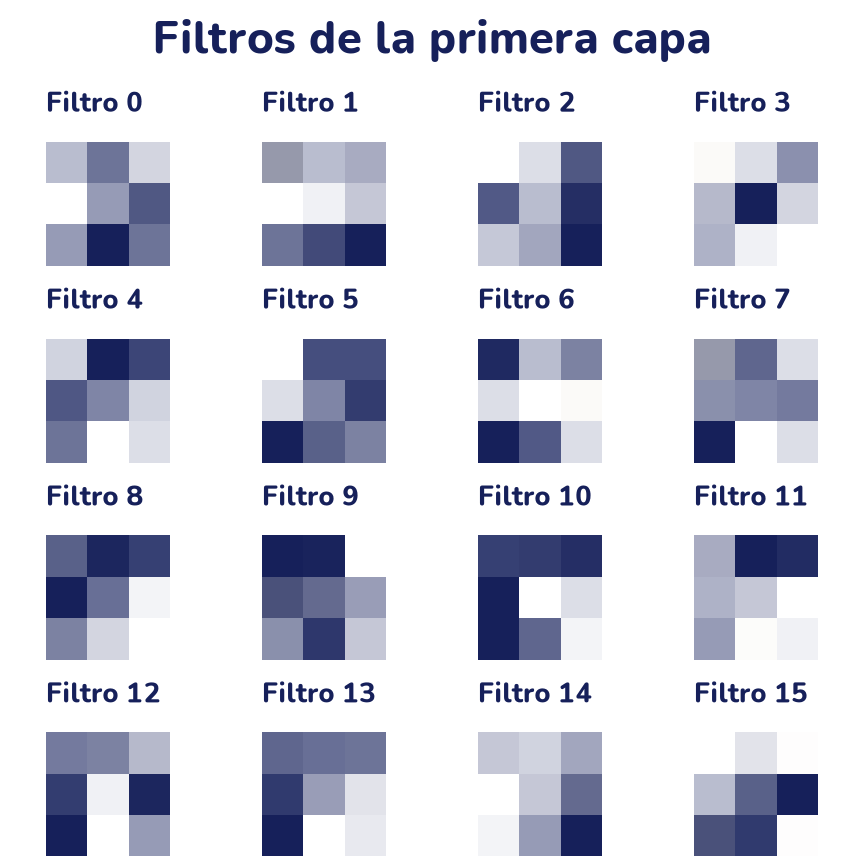
No se parecen al Sobel prolijo que escribimos a mano: después de solo 8 épocas siguen teniendo bastante del azar con que empezaron. Pero varios tienen un lado oscuro y otro claro, como el filtro 10 (tinta arriba y a la izquierda) o el 2 (tinta abajo a la derecha): responden a cambios de brillo en una dirección, es decir, son detectores de bordes. Nadie le dijo a la red que buscara bordes; los encontró porque le sirven para separar las clases.
Más interesante todavía es ver qué hace cada filtro con una prenda. Pasamos una imagen de validación por la primera convolución y su ReLU y dibujamos los 16 mapas de activación.
# Una prenda de validación: la que está en la posición 1
imagen = x_val[1:2].to(device)                # (1, 1, 28, 28)
print("Etiqueta:", nombres[y_val[1]])
with torch.no_grad():
    mapas = cnn[1](cnn[0](imagen))[0].cpu()   # (16, 28, 28)
print(tuple(mapas.shape))

fig, ejes = plt.subplots(4, 4, figsize=(4.8, 4.8))
for k, eje in enumerate(ejes.flat):
    eje.imshow(mapas[k], cmap=blanco_tinta)
    eje.set_title(f"Mapa {k}", fontsize=11)
    eje.axis("off")
plt.suptitle("Mapas de activación de la primera capa")
plt.show()
Etiqueta: camisa
(16, 28, 28)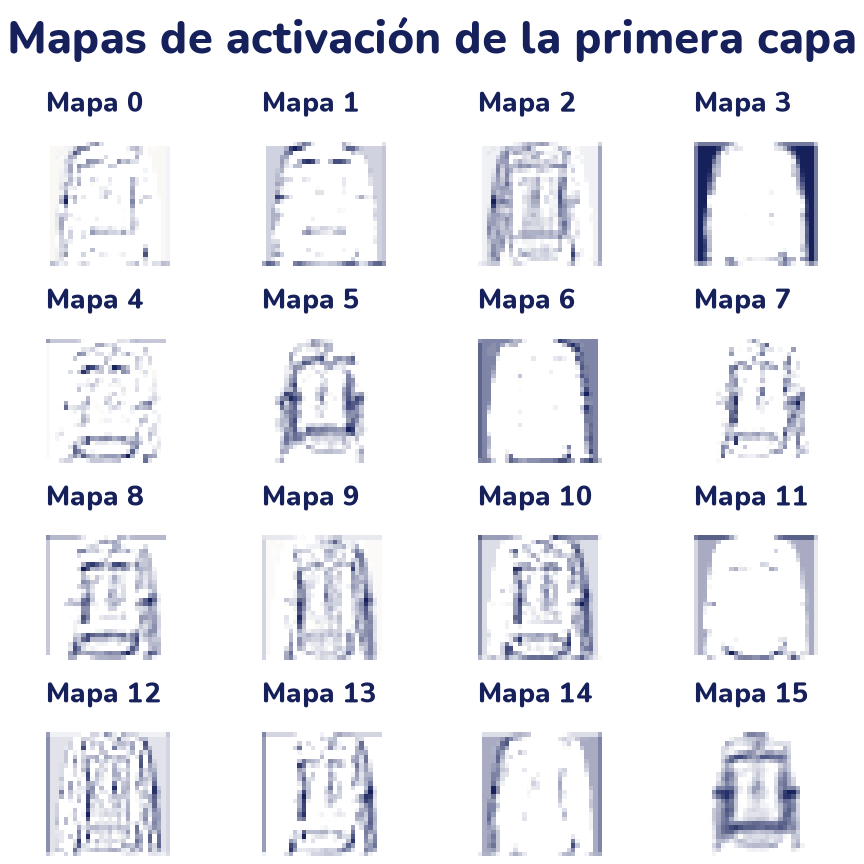
Cada mapa es la misma camisa vista con un filtro distinto. Algunos marcan sobre todo los costados verticales (como el 2 y el 5), otros los bordes horizontales, como el ruedo de abajo (el 1 y el 4). Los mapas 3, 6 y 11 hacen algo que no esperábamos: se encienden en el fondo y quedan apagados sobre la prenda. También eso es información útil: la silueta de lo que no es prenda dice mucho de la forma de la prenda.
La segunda capa de la CNN recibe estos 16 mapas (achicados por el pooling) como si fueran 16 canales de una imagen, y combina sus filtros sobre todos a la vez: así arma patrones más grandes, como un cuello o una manga.
Aumentación: más datos sin salir a fotografiar
Una CNN grande con pocas imágenes termina memorizándolas: sobreajusta, como viste en el tema 19. Conseguir más fotos cuesta, pero hay un truco barato. Si una camiseta volteada como en un espejo sigue siendo una camiseta, podemos inventar imágenes nuevas a partir de las que tenemos: voltearlas, recortarlas un poco corridas, ponerles ruido. Eso se llama aumentación de datos, y es una forma de regularización: la red ve en cada época una versión un poco distinta de cada imagen, y le cuesta más memorizar.
torchvision.transforms trae las transformaciones listas, y transforms.Compose las encadena:
RandomHorizontalFlip(p=0.5)voltea la imagen de izquierda a derecha la mitad de las veces.RandomCrop(28, padding=3)agrega un marco de 3 píxeles y recorta un cuadro de 28 × 28 en una posición al azar: la prenda queda corrida hasta 3 píxeles en cualquier dirección.- Para el ruido gaussiano escribimos una función corta y la envolvemos en
transforms.Lambda.
from torchvision import transforms

def ruido(x):
    """Suma a cada píxel un número al azar de desviación 0,1."""
    return x + 0.1 * torch.randn_like(x)

aumentar = transforms.Compose([
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.RandomCrop(28, padding=3),
    transforms.Lambda(ruido),
])

torch.manual_seed(0)
# Una imagen de entrenamiento, sin normalizar: (1, 28, 28)
original = entrenamiento.data[0].float().unsqueeze(0) / 255
fig, ejes = plt.subplots(3, 3, figsize=(4.8, 4.8))
for k, eje in enumerate(ejes.flat):
    version = original if k == 0 else aumentar(original)
    eje.imshow(version[0], cmap=blanco_tinta, vmin=0, vmax=1)
    eje.set_title("Original" if k == 0 else f"Versión {k}", fontsize=11)
    eje.axis("off")
plt.show()
print("Forma de cada versión:", tuple(aumentar(original).shape))
Forma de cada versión: (1, 28, 28)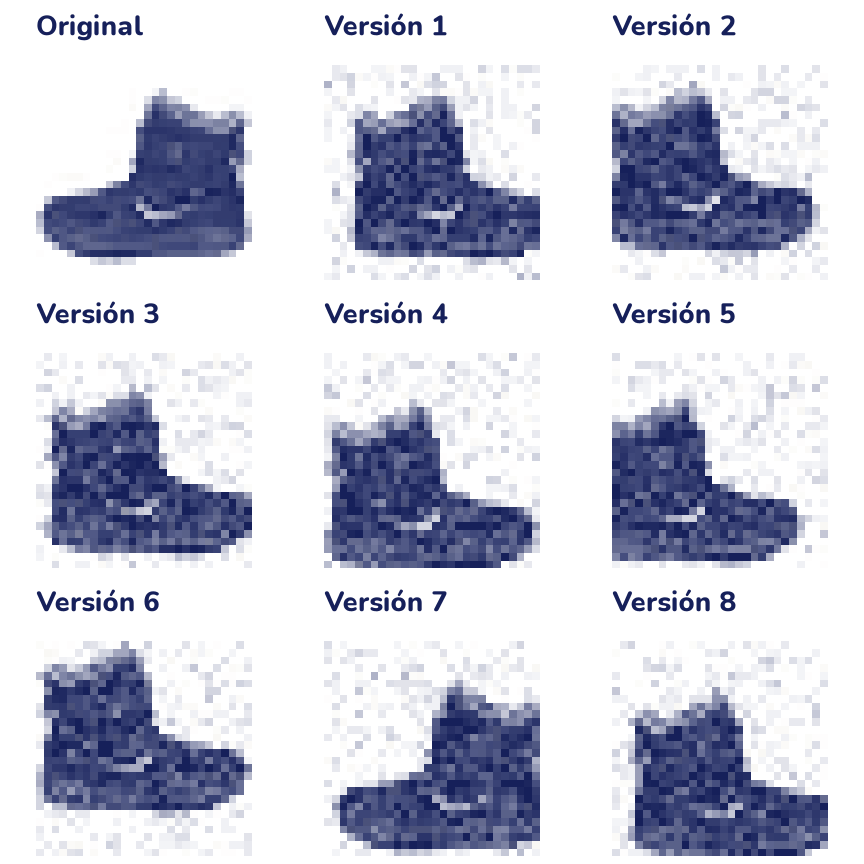
Las ocho versiones son el mismo botín: unas miran hacia el otro lado, todas están un poco corridas y tienen un granulado de ruido. Para la red, son ocho ejemplos distintos con la misma etiqueta.
Dos reglas para elegir aumentaciones:
- Solo las que no cambian la respuesta. Voltear de izquierda a derecha una prenda está bien; voltearla de arriba abajo, no, porque nadie fotografía botines al revés. Con dígitos, ni siquiera el volteo horizontal sirve: un 2 en espejo ya no es un 2.
- Solo en el entrenamiento. La validación y la prueba se miden con las imágenes tal cual, para comparar siempre contra lo mismo.
Con fotos en color se usan además cambios de brillo y contraste (ColorJitter) y recortes de distinto tamaño (RandomResizedCrop). Un conjunto clásico para practicar con fotos en color es CIFAR-10: 60 000 fotos de 32 × 32 de aviones, autos, pájaros, gatos y otras seis clases. Se baja con datasets.CIFAR10(root="datos", download=True), pero pesa unos 170 MB y, sin GPU, entrenar con él es lento: úsalo como opción si tu conexión y tu paciencia lo permiten. Todo el código de este tema sirve igual, cambiando in_channels=1 por in_channels=3 y el tamaño de la capa final.
En el mini-proyecto vas a aplicar la aumentación en el entrenamiento y a medir si ayuda.
Lo que aprendiste y lo que sigue
- Una convolución desliza un filtro chico por la imagen y en cada posición calcula un producto punto: el mapa de activación dice dónde aparece el patrón del filtro. El filtro Sobel encuentra bordes.
- El lado de la salida es ⌊(n + 2p − k) / s⌋ + 1. El padding conserva el tamaño; el stride lo achica.
- El pooling resume bloques de 2 × 2 con su máximo o su promedio: achica los mapas y da algo de tolerancia a movimientos pequeños.
- Una convolución comparte sus pesos en toda la imagen: tiene muchísimos menos parámetros que una capa densa y reconoce un patrón en cualquier lugar.
- Con el mismo número de parámetros, una CNN clasifica las prendas mejor que un MLP, porque aprovecha que los píxeles vecinos están relacionados.
- La aumentación crea versiones nuevas de cada imagen de entrenamiento y ayuda a no sobreajustar, siempre que no cambie la respuesta correcta.
Los filtros de una CNN aprenden a ver bordes, texturas y formas sin que nadie se los escriba. En el tema 26 vas a usar CNN enormes ya entrenadas con millones de fotos y a adaptarlas a tus propios problemas, y en el 27, a encontrar dónde está cada objeto dentro de una foto.