La pregunta
Tienes un texto largo: una noticia, un cuento, los mensajes de un grupo. ¿Cuál es la palabra que más se repite? Leerlo y contar a mano funciona con un párrafo, pero no con mil páginas.
Con lo del tema 1 (variables, decisiones y bucles) casi podrías hacerlo, pero te faltan dos cosas: una manera de guardar muchos datos juntos (todas las palabras, y cuántas veces aparece cada una) y una manera de ordenar el código en piezas con nombre que puedas usar una y otra vez. Eso son las colecciones y las funciones, y con ellas está escrito todo el código de inteligencia artificial que vas a ver en esta ruta. Contar palabras, además, es exactamente el primer paso con el que una computadora empieza a «leer» un texto.
En este tema vas a:
- escribir funciones con parámetros y
return; - guardar datos en listas, tuplas, diccionarios y conjuntos, y transformar listas con comprensiones;
- contar frecuencias con un diccionario y ordenarlas con
sorted; - leer y escribir archivos CSV con
openy con el módulocsv; - usar módulos con
importe instalar paquetes conpip; - entender qué es una clase, lo justo para reconocer
modelo.fit()cuando aparezca.
Necesitas lo del tema 1: variables, if, bucles for y while, y f-strings.
Actividad: el diccionario vivo
Antes de escribir código, mira cómo cuenta una computadora. Escribe una frase (o deja la que está) y pulsa «Siguiente palabra». El programa lee las palabras una por una y va llenando una tabla: a la izquierda, cada palabra distinta (la clave); a la derecha, cuántas veces apareció (la cuenta). Si la palabra es nueva, se agrega una fila con 1; si ya estaba, su cuenta sube en 1.
Diccionario vivo
Así queda el diccionario con la frase de ejemplo, ya limpia. Con JavaScript activado puedes escribir tu propia frase y llenarlo palabra por palabra.
Las palabras, en el orden en que se leen
- el
- pan
- de
- la
- mañana
- la
- gente
- compra
- pan
- y
- el
- pan
- se
- acaba
- pan
conteo clave → cuenta
| Clave | Barra | Cuenta |
|---|---|---|
'el' | 2 | |
'pan' | 4 | |
'de' | 1 | |
'la' | 2 | |
'mañana' | 1 | |
'gente' | 1 | |
'compra' | 1 | |
'y' | 1 | |
'se' | 1 | |
'acaba' | 1 |
El diccionario está vacío: conteo = {}
palabras leídas: 15 de 15claves distintas: 10
Pulsa «Siguiente palabra» para leer la primera.
Prueba esto, en orden:
- Con «Limpiar el texto» apagado, llena la tabla. ¿Cuántas veces cuenta la palabra pan? ¿Por qué aparecen «pan,» y «¡Pan!» en filas separadas?
- Enciende «Limpiar el texto» y vuelve a llenar. ¿Qué cambió en la cantidad de filas y en la cuenta de pan?
- Enciende «Ordenar por cuenta». Las palabras que más se repiten, ¿son las más interesantes del texto?
- Escribe una frase tuya donde una palabra aparezca con mayúscula y con punto, y predice cuántas filas va a tener la tabla antes de llenarla.
Lo que acabas de ver son dos ideas de este tema: un diccionario es una tabla de búsqueda (dada una palabra, encuentra su cuenta al instante) y los datos crudos casi siempre necesitan limpieza antes de contarlos. Para la computadora, «Pan», «pan,» y «pan» son tres textos distintos hasta que tú le digas lo contrario.
Funciones: código con nombre
Una función es un pedazo de código con nombre que recibe datos, hace algo con ellos y devuelve un resultado. Ya usaste varias: print, len, round. Ahora vas a escribir las tuyas con def:
def celsius_a_fahrenheit(celsius):
    """Convierte una temperatura de grados Celsius a Fahrenheit."""
    return celsius * 9 / 5 + 32

print(celsius_a_fahrenheit(0))
print(celsius_a_fahrenheit(25))
temperatura = celsius_a_fahrenheit(-10)
print(f"-10 °C son {temperatura} °F")
32.0
77.0
-10 °C son 14.0 °Fdefempieza la función,celsius_a_fahrenheites su nombre ycelsiuses su parámetro: una variable que recibe el valor que le pases al llamarla.- El texto entre triples comillas es la documentación: dice qué hace la función. No es obligatorio, pero te ayuda a ti y a quien lea tu código.
returntermina la función y devuelve un valor, que puedes imprimir o guardar en una variable.
Una función puede tener varios parámetros, y alguno puede tener un valor por defecto que se usa cuando no lo pasas:
def nota_final(parcial, examen, peso_examen=0.6):
    """Promedio ponderado: el examen pesa peso_examen."""
    return parcial * (1 - peso_examen) + examen * peso_examen

print(nota_final(70, 80))                    # el examen pesa 0.6
print(nota_final(70, 80, peso_examen=0.5))   # ahora pesa la mitad
76.0
75.0print no es lo mismo que return. print muestra un valor en la pantalla y nada más; return lo entrega a quien llamó la función para que lo siga usando. Una función sin return devuelve un valor especial, None («nada»):
def doble_que_imprime(x):
    print(2 * x)

def doble_que_devuelve(x):
    return 2 * x

a = doble_que_imprime(5)
b = doble_que_devuelve(5)
print(a, b)
10
None 10El 10 de la primera línea lo escribió print dentro de la función, pero a quedó vacía. Si quieres usar el resultado después, usa return.
El ámbito: lo que pasa en la función se queda en la función
Las variables que creas dentro de una función son locales: existen mientras la función corre y desaparecen al terminar. Afuera no se ven:
def duplicar(x):
    resultado = 2 * x
    return resultado

print(duplicar(21))
print(resultado)
42
Traceback (most recent call last):
...
NameError: name 'resultado' is not definedEsto es una ventaja: puedes usar los nombres que quieras dentro de una función sin pisar las variables del resto del programa. Lo que quieras sacar de una función, sácalo con return.
Listas: muchos valores juntos
Una lista guarda varios valores en orden, entre corchetes y separados por comas. Cada valor tiene una posición (su índice), que empieza en 0:
notas = [72, 85, 58, 91, 64]

print(notas[0])      # la primera
print(notas[-1])     # la última: los índices negativos cuentan desde atrás
print(notas[1:3])    # una rebanada: de la posición 1 hasta antes de la 3
print(len(notas), sum(notas), min(notas), max(notas))

notas.append(77)     # agrega un valor al final
notas[2] = 60        # cambia el valor de la posición 2
print(notas)
print(91 in notas)   # ¿está el 91 en la lista?
72
64
[85, 58]
5 370 58 91
[72, 85, 60, 91, 64, 77]
Truelen, sum, min y max reciben una lista entera y te ahorran un bucle. append es un método: una función que pertenece a la lista y se llama con un punto, notas.append(77).
Recorrer y transformar una lista
Un for recorre una lista valor por valor. Para crear una lista nueva a partir de otra, empiezas con una lista vacía y le vas agregando:
# Sumar 5 puntos de bono a cada nota
con_bono = []
for n in notas:
    con_bono.append(n + 5)
print(con_bono)
[77, 90, 65, 96, 69, 82]Esto es tan común que Python tiene una forma corta, la comprensión de lista: «la lista de n + 5 para cada n en notas». Se le puede agregar un if al final para quedarse solo con algunos valores:
con_bono = [n + 5 for n in notas]
altas = [n for n in notas if n >= 80]
print(con_bono)
print(altas)
print(f"{len(altas)} de {len(notas)} notas son de 80 o más")
[77, 90, 65, 96, 69, 82]
[85, 91]
2 de 6 notas son de 80 o másLee la comprensión de izquierda a derecha como una frase: qué guardas (n + 5), de dónde lo sacas (for n in notas) y, si quieres, con qué condición (if n >= 80).
Las funciones y las listas se llevan bien. Esta función recibe una lista y devuelve un número:
def promedio(valores):
    """El promedio de una lista de números."""
    return sum(valores) / len(valores)

print(round(promedio(notas), 1))
print(promedio([10, 20]))
74.8
15.0Tuplas, diccionarios y conjuntos
Tuplas: valores que van juntos
Una tupla es como una lista, pero entre paréntesis y no se puede cambiar una vez creada. Sirve para valores que van siempre juntos, como el nombre y la edad de una persona. Se puede desempaquetar en varias variables a la vez:
persona = ("Ana", 15)
nombre, edad = persona          # desempaquetar
print(nombre, "tiene", edad, "años")
persona[1] = 16
Ana tiene 15 años
Traceback (most recent call last):
...
TypeError: 'tuple' object does not support item assignmentDiccionarios: una tabla de búsqueda
Un diccionario guarda pares clave → valor, entre llaves. En lugar de buscar por posición, buscas por clave, igual que en un diccionario de verdad buscas una palabra para encontrar su significado:
edades = {"Ana": 15, "Luis": 16, "Sofía": 14}

print(edades["Luis"])        # buscar por clave
edades["Marco"] = 15         # agregar una clave nueva
edades["Ana"] = 16           # cambiar el valor de una clave
print(len(edades), "personas")

for nombre, edad in edades.items():
    print(f"{nombre}: {edad} años")
16
4 personas
Ana: 16 años
Luis: 16 años
Sofía: 14 años
Marco: 15 añosedades.items()da los pares (clave, valor) como tuplas, y elforlos desempaqueta.- Las claves no se repiten: si asignas una clave que ya existe, cambias su valor.
- El diccionario recuerda el orden en que agregaste las claves.
Si buscas una clave que no existe, Python se queja con un KeyError. El método get busca sin quejarse y devuelve un valor por defecto:
print("Pedro" in edades)
print(edades.get("Pedro", 0))
print(edades["Pedro"])
False
0
Traceback (most recent call last):
...
KeyError: 'Pedro'Conjuntos: sin repetidos
Un conjunto (set) guarda valores sin repetir y sin orden. Es la forma más rápida de saber qué valores distintos hay o de preguntar si algo está:
colores = ["rojo", "azul", "rojo", "verde", "azul", "rojo"]
distintos = set(colores)
print(len(colores), "colores anotados,", len(distintos), "distintos")
print(sorted(distintos))
print("amarillo" in distintos)
6 colores anotados, 3 distintos
['azul', 'rojo', 'verde']
FalseComo un conjunto no tiene orden, para mostrarlo conviene pasarlo por sorted, que devuelve una lista ordenada.
| Colección | Se escribe | ¿Ordenada? | ¿Se puede cambiar? | Para qué sirve |
|---|---|---|---|---|
| Lista | [1, 2, 2] |
Sí, por posición | Sí | Una secuencia de valores |
| Tupla | ("Ana", 15) |
Sí, por posición | No | Valores que van juntos |
| Diccionario | {"Ana": 15} |
Por orden de llegada | Sí | Buscar un valor por su clave |
| Conjunto | {1, 2} |
No | Sí | Valores distintos, sin repetir |
Contar las palabras de un texto
Ya tienes todo para responder la pregunta del principio. Este es un texto de ejemplo, escrito para este tema. Las triples comillas permiten escribir un texto de varias líneas:
texto = """La panadería del barrio abre temprano. A las seis ya huele a pan,
y a las siete la fila llega a la esquina. El pan de la mañana se acaba
rápido: la gente compra pan para el desayuno y pan para el colegio. Por la
tarde la panadería hace galletas, y los niños del barrio pasan a comprar
galletas al salir del colegio."""
Primero, limpiar. Como viste en la actividad, «Pan», «pan,» y «pan» tienen que contar como la misma palabra. Esta función pasa todo a minúsculas y cambia cada signo de puntuación por un espacio. c.isalnum() dice si el carácter c es una letra o un número, y c.isspace(), si es un espacio o un salto de línea:
def limpiar(texto):
    """Pasa a minúsculas y cambia la puntuación por espacios."""
    limpio = ""
    for c in texto.lower():
        if c.isalnum() or c.isspace():
            limpio += c
        else:
            limpio += " "
    return limpio

palabras = limpiar(texto).split()   # split corta en los espacios
print(palabras[:8])
print(len(palabras), "palabras")
['la', 'panadería', 'del', 'barrio', 'abre', 'temprano', 'a', 'las']
63 palabrasDespués, contar. Un diccionario palabra → cuenta, exactamente como en la actividad: si la palabra ya está, su cuenta sube en 1; si no, entra con 1.
def contar(palabras):
    """Diccionario con cuántas veces aparece cada palabra."""
    conteo = {}
    for palabra in palabras:
        if palabra in conteo:
            conteo[palabra] += 1
        else:
            conteo[palabra] = 1
    return conteo

conteo = contar(palabras)
print(len(conteo), "palabras distintas")
print("pan:", conteo["pan"], "  la:", conteo["la"])
38 palabras distintas
pan: 4 la: 7Las cuatro líneas del if se pueden escribir en una con get: conteo[palabra] = conteo.get(palabra, 0) + 1. Las dos formas hacen lo mismo.
Ordenar con sorted y key
Para saber cuáles son las más frecuentes hay que ordenar los pares (palabra, cuenta) por la cuenta. sorted recibe cualquier colección y devuelve una lista ordenada. Con key le dices según qué ordenar: una función que, para cada elemento, devuelve el valor que hay que comparar. Con reverse=True, de mayor a menor:
def la_cuenta(par):
    """De un par (palabra, cuenta), devuelve la cuenta."""
    return par[1]

ordenadas = sorted(conteo.items(), key=la_cuenta, reverse=True)
print(ordenadas[:5])
[('la', 7), ('a', 5), ('pan', 4), ('del', 3), ('y', 3)]Fíjate que se pasa la_cuenta sin paréntesis: no la llamas tú, se la entregas a sorted para que la llame con cada par. Para funciones tan cortas, Python permite escribirlas en el mismo lugar con lambda: key=lambda par: par[1] hace lo mismo que key=la_cuenta.
Tu primer gráfico
Una lista de números se entiende mejor dibujada. matplotlib es la librería de gráficos que vas a usar en toda la ruta; en el tema 4 la verás a fondo, así que por ahora tómalo como un adelanto. Como vas a dibujar dos veces, conviene una función:
import matplotlib.pyplot as plt

def graficar_frecuentes(pares, titulo):
    """Barras horizontales con los pares (palabra, cuenta)."""
    palabras_top = [p for p, c in pares]
    cuentas_top = [c for p, c in pares]
    # La primera barra (la más frecuente) en otro color
    colores = ["C1"] + ["C0"] * (len(pares) - 1)
    plt.barh(palabras_top, cuentas_top, color=colores)
    plt.gca().invert_yaxis()       # la más frecuente arriba
    plt.xlabel("Veces que aparece")
    plt.title(titulo)
    plt.show()

graficar_frecuentes(ordenadas[:8], "Las 8 palabras más frecuentes")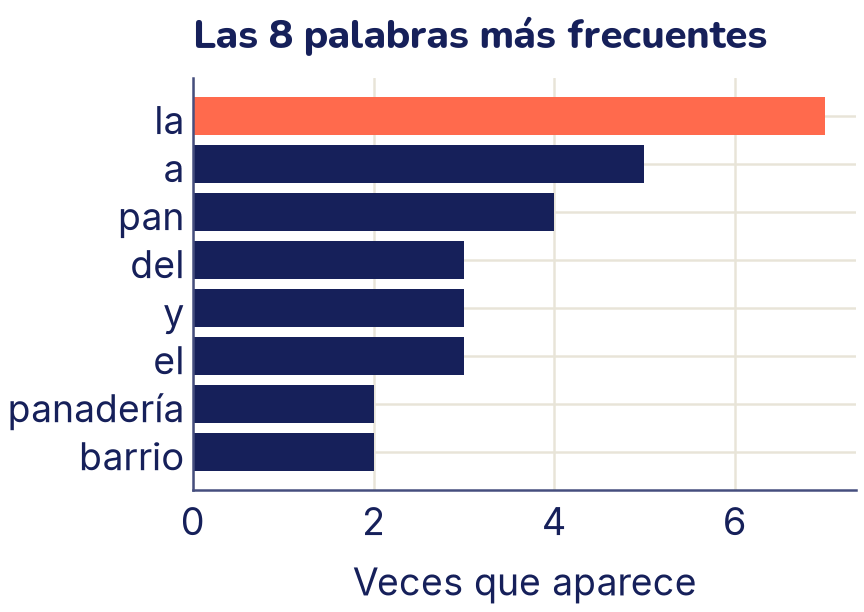
Las ganadoras son «la», «a», «del», «y», «el»: palabras que aparecen en cualquier texto en español y no dicen de qué trata este. Se llaman palabras vacías. Un conjunto es perfecto para guardarlas, porque solo nos interesa preguntar si una palabra está o no. Y una comprensión de diccionario, con la misma idea que la de lista, arma el conteo sin ellas:
vacias = {"la", "las", "el", "los", "a", "de", "del", "y", "al",
          "se", "para", "por", "ya"}

conteo_util = {p: c for p, c in conteo.items() if p not in vacias}
ordenadas_util = sorted(conteo_util.items(), key=la_cuenta,
                        reverse=True)
print(ordenadas_util[:5])
graficar_frecuentes(ordenadas_util[:8], "Sin las palabras vacías")
[('pan', 4), ('panadería', 2), ('barrio', 2), ('colegio', 2), ('galletas', 2)]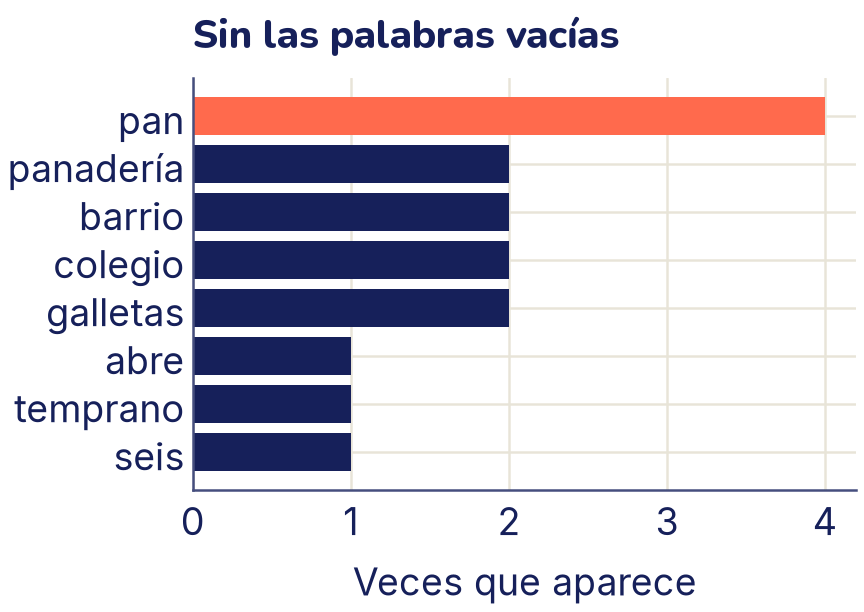
Ahora sí se ve de qué habla el texto: pan, panadería, barrio, galletas, colegio. Con dos funciones cortas, limpiar y contar, convertiste un texto en números que se pueden comparar y graficar. En el tema 21 vas a ver que así empieza un modelo que clasifica textos: cada texto se convierte en las cuentas de sus palabras.
Archivos y CSV
Los datos casi nunca están escritos dentro del programa: vienen en archivos. El formato más común para tablas es el CSV (comma-separated values, valores separados por comas): un archivo de texto con una fila por línea y las columnas separadas por comas. La primera línea suele tener los nombres de las columnas.
Escribir un archivo
Para trabajar con un archivo, primero se abre con open. Con with, Python lo cierra solo al terminar el bloque, aunque haya un error. El módulo csv sabe escribir filas con las comas en su lugar. Vamos a crear un CSV pequeño con las notas de un curso inventado:
import csv

filas = [
    ["nombre", "matematica", "lenguaje", "ciencias"],
    ["Ana", 78, 85, 90],
    ["Bruno", 55, 62, 48],
    ["Carla", 92, 88, 95],
    ["Diego", 40, 71, 66],
    ["Elena", 67, 59, 73],
    ["Franco", 85, 77, 81],
]

# "w" abre el archivo para escribir (lo crea o lo reemplaza)
with open("notas.csv", "w", newline="", encoding="utf-8") as f:
    escritor = csv.writer(f)
    escritor.writerows(filas)
Si trabajas en Colab, el archivo aparece en el panel de archivos de la izquierda. encoding="utf-8" hace que las tildes y la ñ se guarden bien, y newline="" es lo que pide el módulo csv para no dejar líneas en blanco de más.
Leer con open, línea por línea
Un archivo abierto para leer se recorre con un for, una línea a la vez. Cada línea es un texto que termina en un salto de línea: strip() lo quita y split(",") corta en las comas:
with open("notas.csv", encoding="utf-8") as f:
    for linea in f:
        print(linea.strip().split(","))
['nombre', 'matematica', 'lenguaje', 'ciencias']
['Ana', '78', '85', '90']
['Bruno', '55', '62', '48']
['Carla', '92', '88', '95']
['Diego', '40', '71', '66']
['Elena', '67', '59', '73']
['Franco', '85', '77', '81']Mira las comillas: '78' es un texto, no un número. Todo lo que se lee de un archivo llega como texto, y hay que convertirlo con int o float antes de hacer cuentas.
Leer con el módulo csv
Cortar en las comas a mano falla cuando un valor tiene una coma adentro (por ejemplo, «La Paz, Bolivia» entre comillas). csv.DictReader lo hace bien y, además, convierte cada fila en un diccionario cuyas claves son los nombres de las columnas. Con eso, el promedio, el mínimo y el máximo de una columna salen sin ninguna librería extra:
def leer_columna(archivo, columna):
    """Los valores de una columna de un CSV, como números."""
    valores = []
    with open(archivo, encoding="utf-8") as f:
        for fila in csv.DictReader(f):
            valores.append(float(fila[columna]))
    return valores

matematica = leer_columna("notas.csv", "matematica")
print(matematica)
print(f"Promedio: {promedio(matematica):.1f}")
print(f"Mínimo: {min(matematica)}   Máximo: {max(matematica)}")
[78.0, 55.0, 92.0, 40.0, 67.0, 85.0]
Promedio: 69.5
Mínimo: 40.0 Máximo: 92.0La función leer_columna sirve para cualquier columna de cualquier CSV: cambia "matematica" por "lenguaje" y listo. En el tema 4, la librería pandas hará esto en una línea, pero por dentro hace lo mismo que acabas de programar.
Módulos, import y pip
Un módulo es un archivo de Python con funciones ya escritas que puedes usar. Python trae muchos de fábrica (la «biblioteca estándar»): csv es uno, y también math para matemáticas, random para el azar y collections, que tiene un contador ya hecho. Se cargan con import:
import math
import random
from collections import Counter

print(math.sqrt(81), math.pi)

random.seed(1)              # semilla fija: siempre sale lo mismo
print(random.choice(["piedra", "papel", "tijera"]))

# Counter hace en una línea lo que hizo nuestra función contar
print(Counter(palabras).most_common(3))
9.0 3.141592653589793
piedra
[('la', 7), ('a', 5), ('pan', 4)]import mathcarga el módulo entero; sus funciones se usan con el nombre del módulo adelante:math.sqrt.from collections import Countertrae soloCounter, que se usa sin prefijo.import matplotlib.pyplot as plt(lo usaste arriba) le pone un apodo corto al módulo.
Counter da el mismo resultado que tu función contar seguida de sorted. Saber programarlo tú te deja entender qué hace por dentro; usar Counter te ahorra tiempo. Las dos cosas valen.
Instalar paquetes con pip
Las librerías que no vienen con Python, como numpy, pandas o scikit-learn, se llaman paquetes y se instalan con pip, el instalador de Python. Si intentas importar un paquete que no está instalado, ves este error:
import paquete_inventadoTraceback (most recent call last):
...
ModuleNotFoundError: No module named 'paquete_inventado'En Colab ya vienen instalados casi todos los paquetes que usa esta ruta. Cuando falte alguno, se instala escribiendo en una celda el nombre del paquete detrás de !pip install. El signo de exclamación le dice a Colab que esa línea no es Python, sino una orden para la computadora:
!pip install wordcloudEn tu propia computadora, la misma orden se escribe sin el signo de exclamación en la terminal: pip install wordcloud. Instalas una vez; después, en cada programa, basta con el import. Ojo: el nombre para instalar y el nombre para importar no siempre coinciden. Por ejemplo, se instala scikit-learn y se importa sklearn.
Clases: una pista de lo que viene
Desde el tema 6 vas a escribir líneas como estas:
modelo = LinearRegression()
modelo.fit(X, y)
modelo.predict(X_nuevo)
modelo es un objeto: un valor que guarda sus propios datos y trae sus propias funciones (los métodos, como fit y predict). Una lista también es un objeto, por eso tiene notas.append(...). El molde con que se fabrican objetos de un tipo se llama clase. No necesitas escribir muchas clases en esta ruta, pero sí entender cómo funcionan. Esta guarda el conteo de palabras adentro:
class Contador:
    """Cuenta cuántas veces aparece cada cosa."""

    def __init__(self):
        # Se ejecuta al crear el objeto: empieza con el conteo vacío
        self.conteo = {}

    def agregar(self, cosa):
        self.conteo[cosa] = self.conteo.get(cosa, 0) + 1

    def agregar_todas(self, cosas):
        for cosa in cosas:
            self.agregar(cosa)

    def mas_comunes(self, k):
        pares = sorted(self.conteo.items(), key=lambda par: par[1],
                       reverse=True)
        return pares[:k]

c = Contador()                 # crear un objeto de la clase
c.agregar_todas(palabras)
c.agregar("pan")
print(c.mas_comunes(3))
print(c.conteo["pan"])
[('la', 7), ('a', 5), ('pan', 5)]
5class Contador:define el molde.Contador()fabrica un objeto nuevo, con su propio conteo.__init__(con dos guiones bajos a cada lado) se ejecuta solo al crear el objeto y prepara sus datos.selfes el propio objeto.self.conteoes un dato que el objeto guarda y que todos sus métodos pueden leer y cambiar. Por eso, después deagregar_todas, el conteo sigue ahí paramas_comunes.
Ahora mira un «modelo» de juguete con la misma forma que los de scikit-learn. fit aprende algo de los datos y lo guarda en el objeto; predict lo usa:
class ModeloPromedio:
    """El modelo más simple: siempre predice el promedio."""

    def fit(self, valores):
        # «Aprender» aquí es guardar el promedio de los datos
        self.media = sum(valores) / len(valores)

    def predict(self, cantidad):
        return [self.media] * cantidad

modelo = ModeloPromedio()
modelo.fit(matematica)
print(modelo.media)
print(modelo.predict(3))
69.5
[69.5, 69.5, 69.5]Es un modelo muy malo (a todos les predice lo mismo), pero tiene la misma forma que los buenos: después de fit, el objeto recuerda lo que aprendió. Cuando en el tema 6 veas modelo.fit(X, y), piensa en esto: el modelo está guardando, dentro de sí, los números que aprendió de los datos.
Lo que aprendiste y lo que sigue
- Una función (
def) recibe datos por sus parámetros y entrega un resultado conreturn. Sus variables son locales: lo que quieras sacar, sácalo conreturn. - Una lista guarda valores en orden y se recorre con
for; una comprensión como[n + 5 for n in notas if n >= 51]crea una lista nueva a partir de otra en una línea. - Una tupla agrupa valores fijos; un diccionario es una tabla de búsqueda clave → valor; un conjunto guarda valores sin repetir.
- Para contar frecuencias: limpiar el texto, recorrer las palabras y sumar 1 en el diccionario.
sorted(..., key=...)ordena por lo que tú digas. - Un CSV se escribe y se lee con
openy el módulocsv; lo que se lee llega como texto y hay que convertirlo a número. importcarga módulos;pip installinstala paquetes que no vienen con Python.- Un objeto guarda datos y métodos;
fitguarda en el objeto lo que aprendió.
En el tema 3 vas a cambiar las listas de números por los arreglos de NumPy, que hacen cuentas con millones de valores a la vez y sin bucles. Las notas de este tema van a volver allí.