Antes de empezar
Los ejercicios usan lo que definiste en la teoría: los datos X_ent, y_ent, X_val e y_val, las funciones cargadores, mlp, entrenar, evaluar, red_grande y entrenar_con_paciencia, y el diccionario regs con los historiales de la sección de regularización. Ejecuta en orden los bloques de la ficha Código en un cuaderno de Colab y trabaja debajo. Intenta cada ejercicio antes de abrir la respuesta.
Ejercicios
1. Momentum a mano
Bajamos por f(w) = w², cuyo gradiente es 2w, desde w = 1 con tasa α = 0,1. Calcula a mano los tres primeros pasos de SGD y los tres primeros de momentum con β = 0,9 (empieza con v = 0). ¿Cuál llega más cerca del mínimo, w = 0? ¿Qué crees que le pasa al momentum en los pasos siguientes? Después compruébalo con torch.optim.SGD.
Respuesta
SGD: cada paso multiplica w por 1 − 0,1 · 2 = 0,8. Queda 0,8, después 0,64 y después 0,512.
Momentum:
- Paso 1: g = 2, v = 0,9 · 0 + 2 = 2, w = 1 − 0,1 · 2 = 0,8.
- Paso 2: g = 1,6, v = 0,9 · 2 + 1,6 = 3,4, w = 0,8 − 0,34 = 0,46.
- Paso 3: g = 0,92, v = 0,9 · 3,4 + 0,92 = 3,98, w = 0,46 − 0,398 = 0,062.
El primer paso es igual (todavía no hay nada acumulado). Desde el segundo, la velocidad suma los gradientes anteriores y el momentum avanza mucho más: en tres pasos queda en 0,062, contra 0,512 de SGD. Pero la velocidad no se frena de golpe: en el paso siguiente se pasa del mínimo y queda del otro lado, y después oscila alrededor de 0 mientras la velocidad se va apagando.
def primeros_pasos(momentum, pasos=5):
    w = torch.tensor([1.0], requires_grad=True)
    optimizador = torch.optim.SGD([w], lr=0.1, momentum=momentum)
    valores = []
    for _ in range(pasos):
        optimizador.zero_grad()
        (w ** 2).sum().backward()
        optimizador.step()
        valores.append(round(w.item(), 3))
    return valores

print("SGD:     ", primeros_pasos(0.0))
print("Momentum:", primeros_pasos(0.9))
SGD: [0.8, 0.64, 0.512, 0.41, 0.328]
Momentum: [0.8, 0.46, 0.062, -0.309, -0.58]2. El primer paso de Adam
Tres pesos, cada uno en una función distinta: f(w) = 0,001 · w, f(w) = w y f(w) = 1000 · w. Sus gradientes son 0,001, 1 y 1000. Con SGD y tasa 0,1, ¿cuánto se mueve cada uno en el primer paso? ¿Y con Adam y tasa 0,1? Usa la fórmula de la teoría y ten en cuenta que, en el primer paso, la corrección de Adam hace que m sea exactamente g y que s sea exactamente g².
Respuesta
Con SGD, el paso es tasa × gradiente: 0,0001, 0,1 y 100. Mil veces más grande cada vez.
Con Adam, el primer paso es α · g / (√(g²) + ε) = α · g / |g|, es decir, α con el signo del gradiente: los tres se mueven 0,1 (salvo el ε, que se nota un poquito cuando el gradiente es diminuto). Es la idea de Adam llevada al extremo: el largo del paso no depende del tamaño del gradiente, solo de su dirección y de la tasa.
for escala in [0.001, 1.0, 1000.0]:
    movimientos = []
    for crear in [lambda q: torch.optim.SGD(q, lr=0.1),
                  lambda q: torch.optim.Adam(q, lr=0.1)]:
        w = torch.tensor([0.0], requires_grad=True)
        optimizador = crear([w])
        (escala * w).sum().backward()
        optimizador.step()
        movimientos.append(-w.item())
    print(f"Gradiente {escala:7g}: SGD se mueve {movimientos[0]:9.4f}, "
          f"Adam {movimientos[1]:.4f}")
Gradiente 0.001: SGD se mueve 0.0001, Adam 0.1000
Gradiente 1: SGD se mueve 0.1000, Adam 0.1000
Gradiente 1000: SGD se mueve 100.0000, Adam 0.10003. Diagnosticar seis entrenamientos
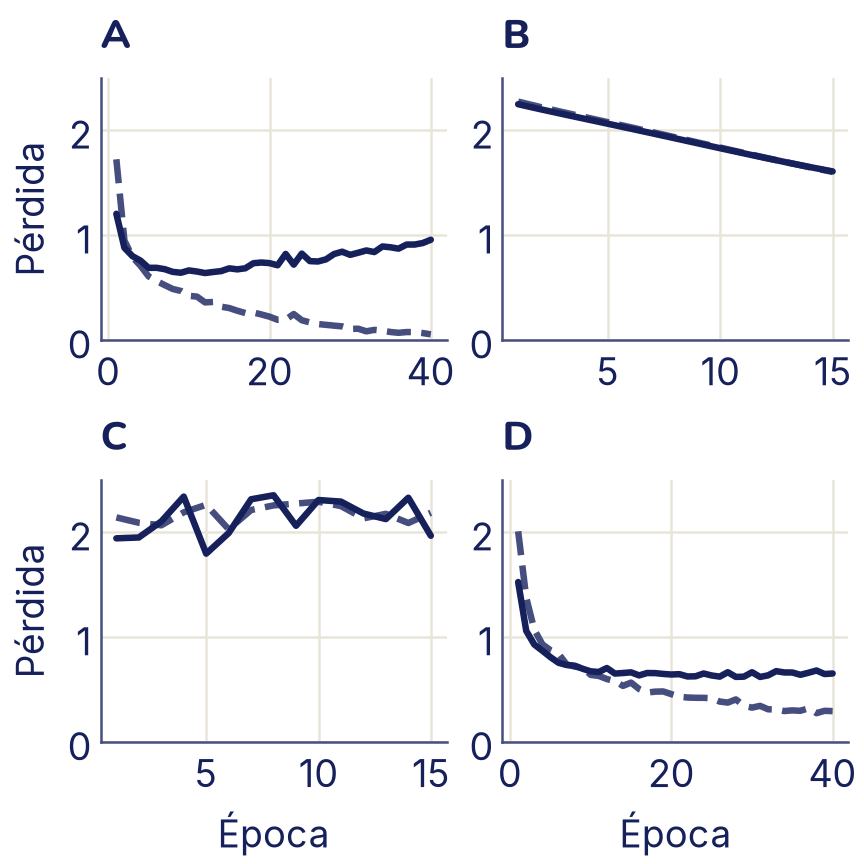
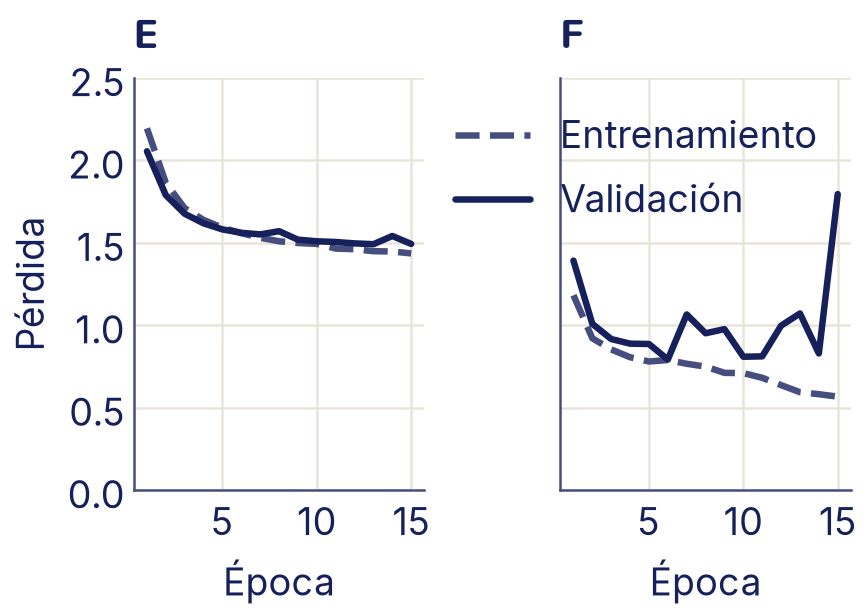
Cada panel muestra la pérdida de entrenamiento (a rayas) y la de validación (continua) de un entrenamiento con FashionMNIST. Para cada uno, di qué está pasando y qué cambiarías. La tabla del final de la teoría te puede ayudar.
El código que hizo las curvas (muestra cómo se entrenó cada una: ábrelo al final)
def curvas_de(crear_modelo, crear_optimizador, lote=64, epocas=15):
    """Entrena 15 épocas y devuelve el historial."""
    torch.manual_seed(0)
    modelo = crear_modelo()
    cargador_ent, cargador_val = cargadores(lote)
    return entrenar(modelo, cargador_ent, cargador_val, epocas,
                    crear_optimizador(modelo.parameters()),
                    dispositivo=device, mostrar=False)

una_neurona = lambda: nn.Sequential(nn.Flatten(), nn.Linear(784, 1),
                                    nn.ReLU(), nn.Linear(1, 10))
casos = {
    "A": regs["Sin regularización"],
    "B": curvas_de(mlp, lambda p: torch.optim.SGD(p, lr=0.001)),
    "C": curvas_de(mlp, lambda p: torch.optim.SGD(p, lr=1.0)),
    "D": regs["Dropout 0,5"],
    "E": curvas_de(una_neurona, lambda p: torch.optim.Adam(p, lr=0.01)),
    "F": curvas_de(mlp, lambda p: torch.optim.SGD(p, lr=0.3), lote=8),
}


def dibujar(eje, letra):
    h = casos[letra]
    epocas = range(1, len(h["perdida_val"]) + 1)
    eje.plot(epocas, h["perdida_ent"], color="C2", linestyle="--",
             label="Entrenamiento")
    eje.plot(epocas, h["perdida_val"], color="C0", label="Validación")
    eje.set_ylim(0, 2.5)
    eje.set_title(letra)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
for eje, letra in zip(ejes.flat, "ABCD"):
    dibujar(eje, letra)
for eje in ejes[1]:
    eje.set_xlabel("Época")
for eje in ejes[:, 0]:
    eje.set_ylabel("Pérdida")
plt.show()

fig, ejes = plt.subplots(1, 2, sharey=True)
for eje, letra in zip(ejes, "EF"):
    dibujar(eje, letra)
    eje.set_xlabel("Época")
ejes[0].set_ylabel("Pérdida")
ejes[1].legend(loc="upper right")
plt.show()
Respuesta
- A, sobreajuste. La pérdida de entrenamiento baja casi a cero y la de validación toca fondo y sube. Probaría dropout, weight decay o parada temprana, y si se puede, más datos o aumentación.
- B, tasa demasiado baja. Las dos bajan juntas, en línea casi recta y muy despacio: después de 15 épocas siguen en 1,6. Subiría la tasa (por ejemplo, ×10), usaría el buscador de tasa o cambiaría a momentum o Adam.
- C, tasa demasiado alta. La pérdida salta alrededor de 2 y nunca baja de verdad (una red que adivina al azar entre diez clases tiene pérdida 2,3). Bajaría la tasa, dividiéndola por 10.
- D, sano. Las dos bajan y la de validación se aplana sin subir. Se puede parar cuando deje de mejorar; si se quiere más, probar una red más grande o más datos.
- E, subajuste. Las dos pérdidas están juntas, pero se quedan altas y planas: la red no tiene capacidad para más. Usaría una red más grande.
- F, demasiado ruido. La pérdida de entrenamiento baja bien, pero la de validación salta de una época a otra y al final da un salto grande: los pasos son demasiado bruscos. Usaría lotes más grandes o una tasa más baja (o un programador que la baje al final).
Cómo se entrenaron: A es la red sin regularizar de la teoría, con 1000 imágenes; B, SGD con tasa 0,001; C, SGD con tasa 1; D, la red con dropout 0,5 de la teoría; E, una red con una sola neurona oculta; F, SGD con tasa 0,3 y lotes de 8 imágenes. Fíjate en que D no es perfecta: su pérdida de entrenamiento queda bastante por debajo de la de validación. Con 1000 imágenes, algo de diferencia es inevitable; lo que importa es que la de validación ya no sube.
4. Tamaño de lote frente a tasa
Entrena el MLP de la teoría con SGD (sin momentum) durante tres épocas, con lotes de 16, 64 y 256 imágenes y tasas de 0,01, 0,05 y 0,2: nueve entrenamientos. Arma una tabla con la exactitud de validación. ¿La mejor tasa es la misma para todos los tamaños de lote? ¿Qué patrón ves?
Respuesta
import pandas as pd

tabla = {}
for lote in [16, 64, 256]:
    fila = {}
    for tasa in [0.01, 0.05, 0.2]:
        torch.manual_seed(0)
        modelo = mlp()
        cargador_ent, cargador_val = cargadores(lote)
        optimizador = torch.optim.SGD(modelo.parameters(), lr=tasa)
        h = entrenar(modelo, cargador_ent, cargador_val, 3, optimizador,
                     dispositivo=device, mostrar=False)
        fila[f"tasa {tasa}"] = h["exactitud_val"][-1]
    tabla[f"lote {lote}"] = fila
print(pd.DataFrame(tabla).T.round(3))
tasa 0.01 tasa 0.05 tasa 0.2
lote 16 0.738 0.803 0.800
lote 64 0.631 0.755 0.776
lote 256 0.590 0.642 0.730La mejor tasa no es la misma. Con lotes de 16, la tasa 0,05 ya da lo mejor (0,803), y 0,2 casi lo mismo (0,800). Con lotes de 64 y de 256, la mejor es 0,2, la más grande que probamos, y con 256 la diferencia es enorme: 0,590 con tasa 0,01 y 0,730 con 0,2.
El patrón: los lotes grandes piden tasas más grandes. Con lotes grandes hay menos pasos por época, así que cada paso tiene que llegar más lejos, y como su gradiente es más confiable (menos ruidoso), aguanta pasos más largos. Una regla práctica muy usada: si multiplicas el lote por k, prueba a multiplicar la tasa por algo parecido a k, hasta cierto límite. Por eso, al cambiar el tamaño del lote, hay que volver a buscar la tasa.
Fíjate también en que, con el mismo número de épocas, los lotes chicos llegan más lejos: dan más pasos. La tabla no mide el tiempo; con lotes más grandes cada época tarda menos, sobre todo en una GPU.
5. Dropout por dentro
Pasa un tensor de diez unos por nn.Dropout(0.5), primero en modo entrenamiento y después en modo evaluación. ¿Qué valores salen? ¿Por qué aparecen doses?
Respuesta
torch.manual_seed(0)
capa = nn.Dropout(0.5)
unos = torch.ones(10)
capa.train()
print("Entrenando:", capa(unos).tolist())
capa.eval()
print("Evaluando: ", capa(unos).tolist())
Entrenando: [0.0, 0.0, 2.0, 0.0, 0.0, 0.0, 2.0, 2.0, 0.0, 2.0]
Evaluando: [1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0, 1.0]En modo entrenamiento, cada valor se apagó (0) o sobrevivió con probabilidad 0,5. Esta vez sobrevivieron 4 de 10 (es al azar: en promedio serían 5). Los que sobreviven se multiplican por 1 / (1 − 0,5) = 2, para que el promedio de la salida siga siendo más o menos 1 y la capa siguiente reciba señales del mismo tamaño que al evaluar. En modo evaluación, el dropout no hace nada: los diez unos pasan iguales.
6. ¿Qué guarda BatchNorm?
¿Cuántos números aprende una capa nn.BatchNorm1d(256)? ¿Y cuántos más guarda sin aprenderlos con el gradiente? Razónalo y compruébalo con parameters() y buffers().
Respuesta
Aprende dos números por neurona: el que multiplica y el que suma después de estandarizar. Son 2 · 256 = 512 parámetros. Además guarda, sin aprenderlos con el gradiente, los promedios acumulados que usa al evaluar: la media y la varianza de cada neurona (otros 512 números) y un contador de cuántos lotes vio.
bn = nn.BatchNorm1d(256)
for nombre, p in bn.named_parameters():
    print("Parámetro:", nombre, tuple(p.shape))
for nombre, b in bn.named_buffers():
    print("Guardado: ", nombre, tuple(b.shape))
print("Total aprendido:", sum(p.numel() for p in bn.parameters()))
Parámetro: weight (256,)
Parámetro: bias (256,)
Guardado: running_mean (256,)
Guardado: running_var (256,)
Guardado: num_batches_tracked ()
Total aprendido: 512Los «guardados» (buffers) forman parte del state_dict: se guardan y se cargan con el modelo, porque sin ellos la capa no sabría qué hacer en modo evaluación.
7. Encuentra el error: predicciones que cambian
Una estudiante entrena una red con dropout y después la usa para clasificar las primeras ocho imágenes de validación. Corre su código dos veces seguidas y obtiene predicciones distintas. ¿Qué le falta?
torch.manual_seed(0)
modelo = red_grande(0.5)
cargador_ent, cargador_val = cargadores()
optimizador = torch.optim.Adam(modelo.parameters(), lr=0.001)
h = entrenar(modelo, cargador_ent, cargador_val, 1, optimizador,
             dispositivo=device, mostrar=False)

modelo.train()            # (así quedó después de entrenar)
with torch.no_grad():
    print("Primera vez:", modelo(X_val[:8]).argmax(dim=1).tolist())
    print("Segunda vez:", modelo(X_val[:8]).argmax(dim=1).tolist())
Primera vez: [5, 2, 8, 0, 0, 9, 2, 1]
Segunda vez: [5, 4, 8, 0, 0, 9, 4, 1]Respuesta
Le falta modelo.eval(). El modelo quedó en modo entrenamiento, así que el dropout sigue apagando neuronas al azar en cada pasada y dos pasadas con las mismas imágenes dan resultados distintos: aquí cambian la segunda y la séptima predicción. La función evaluar llama a eval() por dentro, pero el código de predicción propio tiene que hacerlo a mano.
modelo.eval()
with torch.no_grad():
    print("Primera vez:", modelo(X_val[:8]).argmax(dim=1).tolist())
    print("Segunda vez:", modelo(X_val[:8]).argmax(dim=1).tolist())
print("Etiquetas:  ", y_val[:8].tolist())
Primera vez: [5, 2, 8, 0, 0, 7, 2, 1]
Segunda vez: [5, 2, 8, 0, 0, 7, 2, 1]
Etiquetas: [5, 2, 8, 0, 0, 9, 6, 1]torch.no_grad() y modelo.eval() hacen cosas distintas y casi siempre van juntas al predecir: el primero solo evita guardar lo necesario para calcular gradientes (ahorra memoria y tiempo); el segundo cambia el comportamiento de capas como Dropout y BatchNorm.
8. He para ReLU
Repite el experimento de la inicialización de la teoría con una red de ocho capas de 256 neuronas, pero con ReLU en lugar de tanh. Compara la desviación estándar de las salidas de la capa 1 y de la capa 8 con tres inicializaciones: pesos con σ = 0,01, Xavier y He (nn.init.kaiming_normal_ con nonlinearity="relu"). ¿Cuál mantiene la señal?
Respuesta
def activaciones_relu(inicializar, capas=8, ancho=256):
    torch.manual_seed(0)
    a = X_ent[:1000].reshape(1000, -1)
    salidas = []
    with torch.no_grad():
        for i in range(capas):
            capa = nn.Linear(a.shape[1], ancho)
            inicializar(capa.weight)
            nn.init.zeros_(capa.bias)
            a = torch.relu(capa(a))
            salidas.append(a)
    return salidas

he = lambda w: nn.init.kaiming_normal_(w, nonlinearity="relu")
for nombre, inicializar in [
        ("σ = 0,01", lambda w: nn.init.normal_(w, std=0.01)),
        ("Xavier", nn.init.xavier_normal_), ("He", he)]:
    s = activaciones_relu(inicializar)
    print(f"{nombre:9s} desviación capa 1: {s[0].std():.4f}, "
          f"capa 8: {s[-1].std():.4f}")
σ = 0,01 desviación capa 1: 0.0726, capa 8: 0.0000
Xavier desviación capa 1: 0.3182, capa 8: 0.0348
He desviación capa 1: 0.3665, capa 8: 0.4533Con σ = 0,01 la señal muere: en la capa 8 la desviación es 0,0000. Con Xavier también se va apagando, de 0,32 en la capa 1 a 0,035 en la 8: Xavier está pensada para activaciones como tanh, y ReLU pone en cero más o menos la mitad de los valores, así que cada capa pierde un poco de señal. Con He, que usa pesos un poco más grandes justamente para compensar eso, la señal se mantiene (0,37 en la capa 1 y 0,45 en la 8). Por eso la regla es Xavier para tanh y sigmoide y He para ReLU.
9. ¿Cuánta paciencia?
Vuelve a entrenar la red sin regularizar de la sección de parada temprana (1000 imágenes), ahora con paciencia 2 y con paciencia 15. ¿En qué época se detiene cada una y qué pesos recupera? ¿Qué riesgo tiene una paciencia muy chica? ¿Y una muy grande? Por último: ¿por qué la parada temprana mira la validación y no el conjunto de prueba?
Respuesta
for paciencia in [2, 15]:
    torch.manual_seed(0)
    modelo = red_grande()
    cargador_poco, cargador_val = cargadores(64, X_ent[:1000],
                                             y_ent[:1000])
    optimizador = torch.optim.AdamW(modelo.parameters(), lr=0.001,
                                    weight_decay=0.0)
    _, mejor = entrenar_con_paciencia(modelo, cargador_poco, cargador_val,
                                      optimizador, paciencia=paciencia,
                                      max_epocas=40)
    perdida, _ = evaluar(modelo, cargador_val, nn.CrossEntropyLoss())
    print(f"Paciencia {paciencia}: mejores pesos de la época {mejor}, "
          f"pérdida de validación {perdida:.3f}")
Paro en la época 11: 2 épocas sin mejorar desde la época 9
Paciencia 2: mejores pesos de la época 9, pérdida de validación 0.643
Paro en la época 27: 15 épocas sin mejorar desde la época 12
Paciencia 15: mejores pesos de la época 12, pérdida de validación 0.640- Con paciencia 2, para en la época 11 y recupera los pesos de la época 9 (pérdida 0,643). Un par de épocas sin mejorar por azar bastaron para detenerla antes del verdadero fondo, que estaba en la época 12. Ese es el riesgo de una paciencia muy chica: parar por un tropiezo.
- Con paciencia 15, llega hasta la época 27 y recupera los pesos de la época 12 (pérdida 0,640), los mismos que con paciencia 5 en la teoría. Como siempre se recuperan los mejores pesos, una paciencia grande casi no empeora el resultado: su costo es el tiempo, diez épocas más de entrenamiento que no sirvieron para nada.
La parada temprana usa la validación porque elegir la época es elegir un hiperparámetro. Si se eligiera mirando el conjunto de prueba, ese conjunto dejaría de ser «datos que el modelo nunca vio» y la medida final saldría optimista (tema 7).
Mini-proyecto: subir la exactitud del MLP, una cosa a la vez
Parte del MLP de la teoría (784 → 256 → 10) entrenado con SGD sin momentum, tasa 0,05, lotes de 64 y diez épocas, con las 6000 imágenes de entrenamiento. Tu objetivo es subir su exactitud de validación cambiando una sola cosa por vez y anotando el efecto en una tabla. Si un cambio ayuda, lo conservas para el siguiente; si no, lo descartas.
Una lista de cambios para probar, en este orden:
- Adam con tasa 0,001 en lugar de SGD.
- Una capa oculta más, de 256 neuronas.
nn.BatchNorm1ddespués de cada capa lineal oculta.- Dropout de 0,2 después de cada activación.
- Un programador coseno.
- Veinte épocas con parada temprana (paciencia 4) en lugar de diez fijas.
Al terminar, y solo una vez, mide el modelo final con el conjunto de prueba de FashionMNIST (train=False), que no usaste para nada. Compara ese número con la exactitud de validación.
Una solución
Una función arma la red con las opciones que se le pidan, y otra entrena y anota. Así cada fila de la tabla es una llamada.
def red_opciones(capas=1, bn=False, p_dropout=0.0):
    """Un MLP con `capas` ocultas de 256 y piezas opcionales."""
    piezas, entrada = [nn.Flatten()], 784
    for _ in range(capas):
        piezas.append(nn.Linear(entrada, 256))
        if bn:
            piezas.append(nn.BatchNorm1d(256))
        piezas.append(nn.ReLU())
        if p_dropout > 0:
            piezas.append(nn.Dropout(p_dropout))
        entrada = 256
    piezas.append(nn.Linear(256, 10))
    return nn.Sequential(*piezas)


resultados, modelos = [], {}
def probar(cambio, opciones, adam=True, coseno=False, paciencia=None):
    torch.manual_seed(0)
    modelo = red_opciones(**opciones)
    cargador_ent, cargador_val = cargadores()
    if adam:
        optimizador = torch.optim.Adam(modelo.parameters(), lr=0.001)
    else:
        optimizador = torch.optim.SGD(modelo.parameters(), lr=0.05)
    if paciencia:
        h, mejor = entrenar_con_paciencia(
            modelo, cargador_ent, cargador_val, optimizador,
            paciencia=paciencia, max_epocas=20)
        exactitud = h["exactitud_val"][mejor - 1]
    else:
        programador = None
        if coseno:
            programador = torch.optim.lr_scheduler.CosineAnnealingLR(
                optimizador, T_max=10)
        h = entrenar(modelo, cargador_ent, cargador_val, 10, optimizador,
                     planificador=programador, dispositivo=device,
                     mostrar=False)
        exactitud = h["exactitud_val"][-1]
    resultados.append((cambio, round(exactitud, 3)))
    modelos[cambio] = modelo


probar("Punto de partida (SGD)", {}, adam=False)
probar("1. Adam", {})
probar("2. Dos capas ocultas", {"capas": 2})
probar("3. + BatchNorm", {"capas": 2, "bn": True})
probar("4. + Dropout 0,2", {"capas": 2, "bn": True, "p_dropout": 0.2})
# El dropout no ayudó (0,832 contra 0,836): seguimos sin él
probar("5. + Coseno", {"capas": 2, "bn": True}, coseno=True)
probar("6. Parada temprana", {"capas": 2, "bn": True}, paciencia=4)
print(pd.DataFrame(resultados, columns=["Cambio", "Validación"])
      .to_string(index=False))
Paro en la época 9: 4 épocas sin mejorar desde la época 5
Cambio Validación
Punto de partida (SGD) 0.807
1. Adam 0.822
2. Dos capas ocultas 0.833
3. + BatchNorm 0.836
4. + Dropout 0,2 0.832
5. + Coseno 0.847
6. Parada temprana 0.832Lo que se aprende de la tabla:
- Adam subió 1,5 puntos respecto de SGD (de 0,807 a 0,822) y la segunda capa oculta, 1,1 puntos más (0,833). Los dos se quedan.
- BatchNorm subió apenas 0,3 puntos (0,836). Es tan poco que podría ser azar: con otra semilla podría salir al revés. Lo conservamos, pero con dudas.
- Dropout 0,2 bajó un poco (0,832): con diez épocas esta red no llega a sobreajustar mucho, y el dropout no tiene mucho que frenar. Lo descartamos.
- El coseno fue el cambio que más ayudó al final: 0,847.
- La parada temprana se detuvo en la época 9, con los mejores pesos de la época 5, y quedó en 0,832, peor que el coseno: sin coseno la tasa no baja al final, y la pérdida de validación tocó fondo muy pronto. La descartamos.
El ganador es la red con dos capas, BatchNorm y coseno. Ojo con un detalle: probamos siete variantes y elegimos la que mejor anduvo en validación. Esa elección hace que su exactitud de validación sea un poco optimista.
Y la medida final, con el conjunto de prueba, una sola vez:
# El ganador en validación: dos capas, BatchNorm y coseno
final = modelos["5. + Coseno"]
prueba = datasets.FashionMNIST(root="datos", train=False, download=True)
cargador_prueba = DataLoader(
    TensorDataset(prueba.data.float() / 255, prueba.targets),
    batch_size=1000)
_, exactitud_prueba = evaluar(final, cargador_prueba,
                              nn.CrossEntropyLoss())
print(f"Exactitud con las 10 000 imágenes de prueba: "
      f"{exactitud_prueba:.3f}")
Exactitud con las 10 000 imágenes de prueba: 0.853Con las 10 000 imágenes de prueba, el modelo final acierta 85,3 %, un poco más que en validación (84,7 %). Que salga algo más alto aquí es azar: la validación tiene solo 2000 imágenes y las dos medidas tienen su margen de error. Este es el número que se reporta. Si ahora volvieras a cambiar cosas mirando este número, la prueba dejaría de ser honesta.
Para seguir: todo esto fue con 6000 imágenes de entrenamiento. Prueba la mejor receta con las 60 000 y con más épocas, y anota cuánto cambia.
Errores comunes
- Cambiar varias cosas a la vez. Si mejora, no sabes qué ayudó; si empeora, no sabes qué perjudicó. Una cosa por vez, y anotada.
- Usar con Adam la tasa de SGD (o al revés). Para Adam, 0,001 es un buen comienzo; 0,1 suele ser demasiado. Para SGD, 0,001 suele ser demasiado poco.
- Olvidar
modelo.eval()al evaluar o predecir. Con dropout o BatchNorm, las predicciones cambian y la exactitud medida es peor de lo real. Y olvidarmodelo.train()al volver a entrenar apaga el dropout. La funciónentrenary la funciónevaluarlo hacen por ti; tu propio código de predicción, no. - Inicializar todos los pesos iguales (en cero o en una constante). Las neuronas quedan como copias y la red no aprende.
- Usar
weight_decayentorch.optim.Adamcreyendo que es AdamW. EnAdames la versión L2, que se mezcla con la adaptación del paso. Si quieres weight decay con Adam, usaAdamW. - Llamar al programador de tasa después de cada lote cuando se pensó por época (o al revés).
CosineAnnealingLR(T_max=10)constep()en cada lote termina su coseno en diez lotes, no en diez épocas. La funciónentrenarllama astep()una vez por época. - Usar el conjunto de prueba para la parada temprana o para elegir hiperparámetros. Esa elección «ve» el conjunto, y la medida final deja de ser honesta. Para eso está la validación.
- Leer solo la pérdida de entrenamiento. Sin la curva de validación no se puede distinguir un modelo que aprende de uno que memoriza.
- Sacar conclusiones de un solo entrenamiento corto. Con otra semilla, otra submuestra o más épocas, diferencias de unas décimas pueden darse vuelta.
¿Lo lograste?
Al terminar este tema deberías poder hacer lo siguiente. Al lado, dónde lo practicaste.
- Comparar el descenso de gradiente completo, el estocástico y por mini-lotes (ejercicio 4 y la sección de mini-lotes de la teoría).
- Elegir entre SGD con momentum, Adam y AdamW, y una tasa de aprendizaje razonable con un buscador y un programador de tasa (ejercicios 1, 2 y 4, y los pasos 1 y 5 del mini-proyecto).
- Explicar para qué sirven la inicialización Xavier y He y la normalización por lotes (ejercicios 6 y 8, y el paso 3 del mini-proyecto).
- Combatir el sobreajuste con dropout, weight decay y parada temprana (ejercicios 5, 7 y 9, y los pasos 4 y 6 del mini-proyecto).
- Diagnosticar un entrenamiento con sus curvas (ejercicio 3).