La pregunta
Imagina un mapa con dos barrios, uno a cada lado de un terreno vacío, y que te piden trazar una carretera recta que los separe. Hay muchísimas rectas que dejan cada barrio de su lado. Pero algunas pasan rozando las casas de un barrio, y otras van por el medio, lejos de los dos. ¿Cuál elegirías?
Seguramente la del medio, con la calle más ancha posible. Si mañana se construye una casa nueva cerca del borde de su barrio, esa recta todavía la deja del lado correcto; la que pasaba rozando, no. Esa intuición es todo el método de este tema: las máquinas de vectores de soporte (support vector machines, SVM) eligen, entre todas las fronteras que separan las clases, la que deja el margen más grande.
En este tema vas a:
- explicar qué son el margen y los vectores de soporte, y por qué unos pocos puntos deciden toda la frontera;
- explicar el papel del hiperparámetro C (el margen suave) y su relación con el sobreajuste;
- programar una SVM lineal desde cero con el descenso de subgradiente sobre la pérdida bisagra;
- explicar el truco del kernel con un ejemplo de levantar los datos a 3D;
- ajustar C y gamma del kernel RBF con validación cruzada.
Necesitas lo del tema 8 (la frontera lineal z = 0 y la entropía cruzada), el descenso de gradiente del tema 6 y lo del tema 10 sobre escalar, pipelines y GridSearchCV.
Actividad: el camino más ancho
Hay puntos de dos clases: círculos tinta y cuadrados coral, como en el tema 8. La recta gruesa es la frontera que elige una SVM y la franja sombreada es la calle: el camino más ancho que se puede abrir entre las dos clases. Los puntos con un anillo alrededor son los vectores de soporte. La computadora recalcula la frontera cada vez que mueves algo.
El camino más ancho
Este es el estado inicial, con C = 10. Con JavaScript activado puedes arrastrar los puntos y cambiar C.
Cada punto se puede enfocar con Tab y mover con las flechas; con Mayúsculas, el paso es más largo.
C bajo: calle ancha, se toleran puntos dentro. C alto: ningún punto puede meterse sin una multa cara.
- Ancho de la calle
- 0,58
- Vectores de soporte
- 3 de 17
- Dentro de la calle
- 0
- Del lado equivocado
- 0
Arrastra un punto o cambia C: la frontera se recalcula sola. Los puntos con anillo son los vectores de soporte.
Prueba esto, en orden:
- Arrastra un punto que esté lejos de la calle, sin anillo. ¿Se mueve la frontera?
- Ahora arrastra un punto con anillo hacia la otra clase. ¿Qué le pasa a la calle?
- Hay un círculo tinta metido entre los cuadrados coral: es un atípico. Con C alto, ¿cómo queda la calle? Baja C poco a poco y mira qué pasa con el ancho y con ese punto.
- Con C muy bajo, cuenta los anillos. ¿Por qué hay tantos ahora?
Lo que acabas de ver es la idea central: solo unos pocos puntos definen la frontera. Los que están lejos de la calle no cuentan; los que la tocan (o se meten en ella) la sostienen, como los soportes de un puente. Y C decide cuánto pesan los puntos que se meten en la calle o quedan del lado equivocado.
Muchas rectas separan, ¿cuál elegir?
Empecemos con datos sintéticos: dos grupos de 20 puntos que se pueden separar con una recta. Para las SVM es costumbre escribir las clases como −1 y +1 en lugar de 0 y 1, porque así el signo dice la clase. La variable signo guarda esas etiquetas.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs

# 40 puntos sintéticos en dos grupos, 20 de cada clase
X, y = make_blobs(n_samples=40, centers=[[-1.5, -1], [1.5, 1]],
                  cluster_std=0.8, random_state=1)
# Las SVM usan las clases -1 y +1 en lugar de 0 y 1
signo = np.where(y == 1, 1, -1)
print("Clases como 0 y 1:  ", y[:8])
print("Clases como signos: ", signo[:8])

def dibujar_clases(X, y, ax=None, s=30):
    """Clase 0: círculos de color C0. Clase 1: cuadrados de color C1."""
    ax = ax or plt.gca()
    ax.scatter(X[y == 0, 0], X[y == 0, 1], s=s, color="C0",
               marker="o", label="Clase 0")
    ax.scatter(X[y == 1, 0], X[y == 1, 1], s=s, color="C1",
               marker="s", label="Clase 1")

# Tres rectas w1·x1 + w2·x2 + b = 0: nombre, (w1, w2), b
# y dónde escribir el nombre en el dibujo
rectas = [("A", (1, 1), 0, (-2.9, 3)),
          ("B", (3, 1), 0, (-0.8, 3)),
          ("C", (1, 3), 0.5, (3, -0.9))]
x1 = np.array([-4, 4])
dibujar_clases(X, y)
for nombre, (w1, w2), b, (tx, ty) in rectas:
    # Despejamos x2 de la ecuación de la recta
    plt.plot(x1, -(w1 * x1 + b) / w2, color="C2")
    plt.text(tx, ty, nombre, color="C2", fontsize=16)
plt.xlim(-3.5, 3.5)
plt.ylim(-3.5, 3.5)
plt.xlabel("$x_1$")
plt.ylabel("$x_2$")
plt.title("Tres rectas que separan las clases")
plt.show()
Clases como 0 y 1: [0 1 0 0 1 0 1 1]
Clases como signos: [-1 1 -1 -1 1 -1 1 1]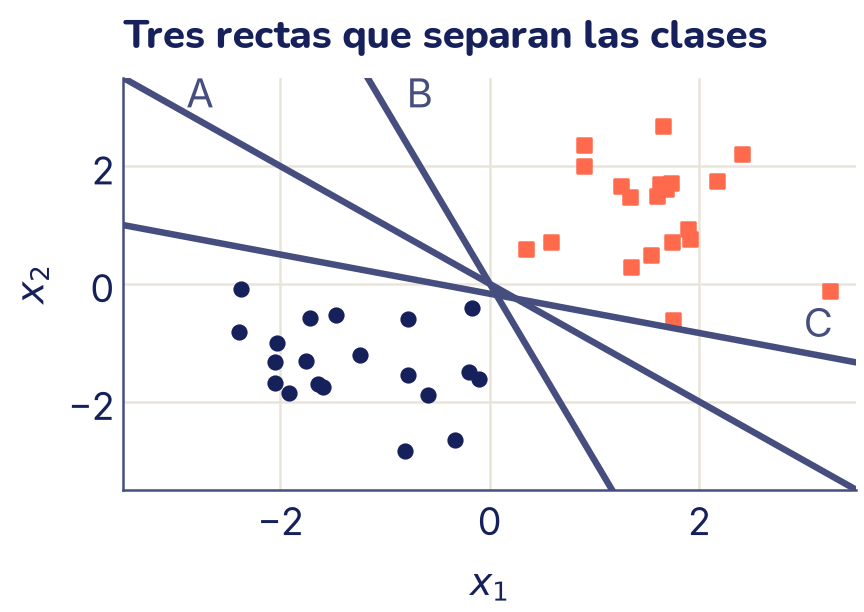
Las tres rectas aciertan con los 40 puntos, así que la tasa de aciertos no sirve para elegir. Lo que cambia es qué tan cerca pasan de los puntos. Como en el tema 8, cada recta da un puntaje a cada punto:
La recta es donde z = 0; de un lado z es positivo (se predice +1) y del otro, negativo (se predice −1). El puntaje solo no es una distancia: si multiplicas w₁, w₂ y b por 10, la recta es la misma, pero los puntajes se multiplican por 10. Para obtener la distancia de un punto a la recta, se divide el puntaje (sin signo) por el largo del vector de pesos, ‖w‖:
donde
Midamos, para cada recta, la distancia al punto más cercano:
def distancias(X, w, b):
    """Distancia de cada fila de X a la recta w·x + b = 0."""
    return np.abs(X @ w + b) / np.linalg.norm(w)

for nombre, (w1, w2), b, _ in rectas:
    w = np.array([w1, w2])
    aciertos = np.mean(np.sign(X @ w + b) == signo)
    cerca = distancias(X, w, b).min()
    print(f"Recta {nombre}, w = ({w1}, {w2}), b = {b}:  aciertos"
          f" {aciertos:.0%}   punto más cercano a {cerca:.2f}")
Recta A, w = (1, 1), b = 0: aciertos 100% punto más cercano a 0.41
Recta B, w = (3, 1), b = 0: aciertos 100% punto más cercano a 0.29
Recta C, w = (1, 3), b = 0.5: aciertos 100% punto más cercano a 0.13La recta A deja más espacio libre a cada lado que las otras dos: su punto más cercano está a 0,41, mientras que C pasa a 0,13 de un punto. Esa distancia al punto más cercano se llama margen, y la SVM busca la recta con el margen más grande posible.
El margen y la calle
Como podemos escalar w y b sin mover la recta, la SVM fija la escala con una convención: los puntos más cercanos tienen puntaje exactamente +1 o −1. Las rectas z = +1 y z = −1 son entonces los bordes de la calle, y ningún punto bien ubicado queda entre ellas. Con la fórmula de la distancia, cada borde está a 1/‖w‖ de la frontera, así que
Una calle ancha significa pesos chicos. Ahora fíjate en el producto y·z, la clase (−1 o +1) por el puntaje: es positivo cuando el punto está del lado correcto y vale 1 o más cuando además está fuera de la calle. Encontrar la calle más ancha que deja todos los puntos fuera de ella es entonces resolver
(minimizar ‖w‖ o su cuadrado da lo mismo; el cuadrado y el ½ solo hacen más fácil la derivada). Esto se llama margen duro: no se permite ningún punto dentro de la calle.
Los puntos que quedan justo sobre los bordes de la calle son los vectores de soporte (cada punto es un vector de dos números, y estos «sostienen» la calle). Si mueves cualquier otro punto sin meterlo en la calle, la solución no cambia: los demás ni siquiera aparecen en la respuesta. Es lo que viste en la actividad.
La pérdida bisagra
El margen duro tiene dos problemas. Si las clases no se pueden separar con una recta, no hay solución. Y aunque se puedan separar, un solo punto raro puede obligar a una calle angostísima. Para tolerar algunos puntos dentro de la calle, o incluso del lado equivocado, la SVM les cobra una multa con la pérdida bisagra (en inglés, hinge):
Se lee así: si el punto está del lado correcto y fuera de la calle (y·z ≥ 1), no paga nada. Si se mete en la calle, paga lo que le falta para llegar al borde, y si cruza al lado equivocado paga todavía más, en línea recta. Comparémosla con la entropía cruzada del tema 8, escrita con las clases −1 y +1 (es la misma fórmula, −log p de la clase correcta):
yz = np.linspace(-2, 3, 300)          # la clase por el puntaje
bisagra = np.maximum(0, 1 - yz)
entropia = np.log(1 + np.exp(-yz))

for valor in [-1, 0, 0.5, 1, 2, 3]:
    print(f"y·z = {valor:4}:  bisagra {max(0, 1 - valor):.2f}"
          f"   entropía cruzada {np.log(1 + np.exp(-valor)):.2f}")

plt.plot(yz, bisagra, color="C1", linewidth=2.6, label="Bisagra")
plt.plot(yz, entropia, color="C2", linestyle="--",
         label="Entropía cruzada")
plt.axvline(1, color="C2", linewidth=1)
plt.xlabel("y·z  (positivo: lado correcto)")
plt.ylabel("Pérdida")
plt.title("La bisagra no cobra fuera de la calle")
plt.legend()
plt.show()
y·z = -1: bisagra 2.00 entropía cruzada 1.31
y·z = 0: bisagra 1.00 entropía cruzada 0.69
y·z = 0.5: bisagra 0.50 entropía cruzada 0.47
y·z = 1: bisagra 0.00 entropía cruzada 0.31
y·z = 2: bisagra 0.00 entropía cruzada 0.13
y·z = 3: bisagra 0.00 entropía cruzada 0.05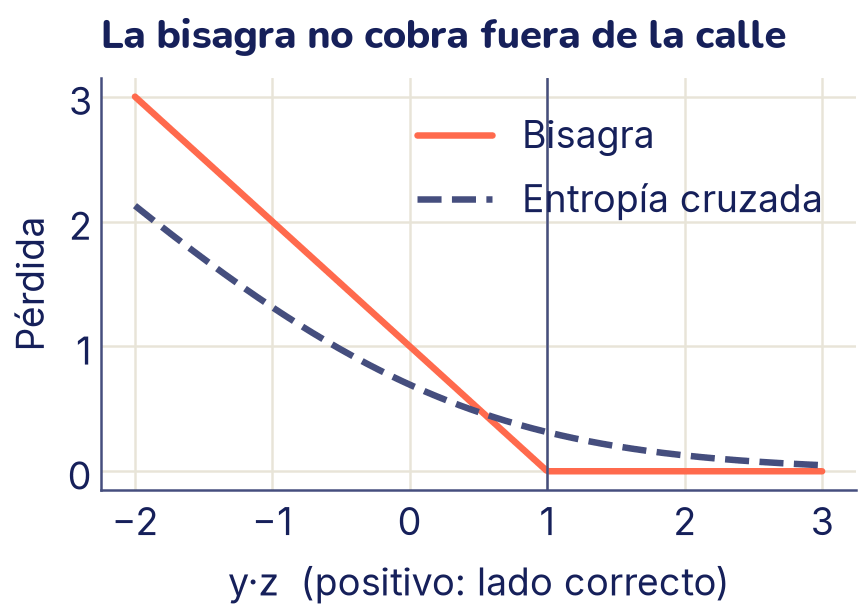
Las dos se parecen para los puntos mal clasificados: crecen casi en línea recta. La diferencia está a la derecha. La entropía cruzada nunca llega a cero: aunque un punto esté lejísimos y bien clasificado, todavía empuja un poquito los pesos. La bisagra es exactamente cero desde y·z = 1. Por eso en una SVM los puntos bien ubicados fuera de la calle no influyen en nada, y solo los vectores de soporte deciden la frontera. La esquina en y·z = 1 es la que le da el nombre: se dobla como una bisagra.
Margen suave: lo que pesa C
Juntamos las dos ideas en una sola función a minimizar: queremos una calle ancha (pesos chicos) y pocas multas.
Esto se llama margen suave. El número C es un hiperparámetro que decide cuánto vale cada multa frente al ancho de la calle:
- Con C grande, las multas son carísimas: la SVM prefiere una calle angosta antes que dejar un punto adentro. Se parece al margen duro y persigue cada punto, aunque sea ruido. Es el camino al sobreajuste.
- Con C chico, las multas son baratas: la SVM abre una calle ancha y acepta que algunos puntos se metan o queden del lado equivocado. Si C es demasiado chico, ignora hasta lo que importa: subajuste.
Si lo comparas con la regularización del tema 7, el término ½‖w‖² hace el papel de la penalización de Ridge, y C es su inverso: más C, menos regularización. Es el mismo C que viste en LogisticRegression.
Programar la SVM desde cero
Para minimizar J usamos el descenso de gradiente del tema 6. Hay un detalle: la bisagra tiene una esquina en y·z = 1, y en una esquina la derivada no existe (la pendiente es −1 de un lado y 0 del otro). La solución es elegir una de las dos pendientes y seguir: eso se llama un subgradiente, y bajar con él es el descenso de subgradiente. En la práctica casi ningún punto cae justo en la esquina, así que basta decidir qué hacer en ese caso.
Para cada punto, la derivada de su multa es:
- si yᵢ·zᵢ ≥ 1 (fuera de la calle, del lado correcto): 0, porque no paga nada;
- si yᵢ·zᵢ menor que 1: −yᵢ·xᵢ respecto de w y −yᵢ respecto de b.
Sumando la derivada de ½‖w‖², que es el mismo w:
Las sumas recorren solo los puntos que pagan multa. Se leen con sentido común: cada punto que se mete en la calle empuja los pesos para quedar más de su lado, y el primer término, w, tira de los pesos hacia cero para ensanchar la calle. El paso es el de siempre:
def objetivo(X, signo, w, b, C):
    """J = ½‖w‖² + C · (suma de las pérdidas bisagra)."""
    multas = np.maximum(0, 1 - signo * (X @ w + b))
    return 0.5 * w @ w + C * multas.sum()

def svm_subgradiente(X, signo, C, tasa, pasos):
    """SVM lineal con descenso de subgradiente.

    Devuelve los pesos w, el sesgo b y el objetivo J antes de cada paso.
    """
    n, d = X.shape
    w = np.zeros(d)                   # un peso por característica
    b = 0.0
    historial = []
    for paso in range(pasos):
        historial.append(objetivo(X, signo, w, b, C))
        yz = signo * (X @ w + b)      # la clase por el puntaje
        multa = yz < 1                # los que se meten en la calle
        dw = w - C * X[multa].T @ signo[multa]
        db = -C * signo[multa].sum()
        w = w - tasa * dw             # un paso en contra
        b = b - tasa * db
    return w, b, np.array(historial)

w_svm, b_svm, historial = svm_subgradiente(X, signo, C=1, tasa=0.001,
                                           pasos=20000)
for paso in [0, 10, 100, 1000, 19999]:
    print(f"Paso {paso:5d}:   J = {historial[paso]:.4f}")
print("w =", np.round(w_svm, 3), "  b =", round(b_svm, 3))
Paso 0: J = 40.0000
Paso 10: J = 4.6549
Paso 100: J = 1.5627
Paso 1000: J = 1.4176
Paso 19999: J = 1.4069
w = [0.798 0.923] b = 0.173Al empezar, con w = 0 y b = 0, todos los puntos tienen z = 0 y pagan una multa de 1: J vale 40. Baja muy rápido y después se estabiliza. Comparemos con SVC de scikit-learn, el clasificador de vectores de soporte, con un kernel lineal (en un rato vas a ver qué es un kernel) y el mismo C:
from sklearn.svm import SVC

svm = SVC(kernel="linear", C=1).fit(X, y)
print("scikit-learn:   w =", np.round(svm.coef_[0], 3),
      "  b =", np.round(svm.intercept_[0], 3))
print(f"Ancho de la calle: {2 / np.linalg.norm(w_svm):.2f}")

# Vectores de soporte: los que tocan la calle o se meten en ella
yz = signo * (X @ w_svm + b_svm)
nuestros = np.flatnonzero(yz < 1.01)
print("Vectores de soporte (nuestro):     ", nuestros)
print("Vectores de soporte (scikit-learn):", np.sort(svm.support_))
print("Su y·z:", np.round(yz[nuestros], 2))
scikit-learn: w = [0.797 0.925] b = 0.174
Ancho de la calle: 1.64
Vectores de soporte (nuestro): [ 8 11 29 35]
Vectores de soporte (scikit-learn): [ 8 11 29 35]
Su y·z: [1. 1. 1. 0.34]Los mismos pesos, salvo en la tercera cifra decimal, y los mismos cuatro vectores de soporte de 40 puntos. Tres tienen y·z = 1: están justo sobre los bordes de la calle. El cuarto tiene y·z = 0,34: está del lado correcto, pero dentro de la calle, y paga una multa de 0,66. Con C = 1, a la SVM le convino aceptar esa multa a cambio de una calle más ancha. (Usamos yz < 1.01 y no yz <= 1 porque el descenso no llega exactamente al mínimo: los puntos del borde quedan en 0,999 o 1,002.)
Dibujemos la calle:
def dibujar_svm(w, b, ax=None, vectores=None):
    """La frontera (z = 0), los bordes (z = -1 y z = 1) y la calle."""
    ax = ax or plt.gca()
    A, B = np.meshgrid(np.linspace(-4, 4, 300), np.linspace(-4, 4, 300))
    Z = w[0] * A + w[1] * B + b
    ax.contourf(A, B, Z, levels=[-1, 1], colors=["C2"], alpha=0.18)
    ax.contour(A, B, Z, levels=[-1, 0, 1], colors=["C2", "C0", "C2"],
               linestyles=["--", "-", "--"], linewidths=[1.4, 2.6, 1.4])
    if vectores is not None:
        # Un anillo alrededor de cada vector de soporte
        ax.scatter(vectores[:, 0], vectores[:, 1], s=190,
                   facecolors="none", edgecolors="C0", linewidths=1.5)
    ax.set_xlim(-3.5, 3.5)
    ax.set_ylim(-3.5, 3.5)

dibujar_svm(w_svm, b_svm, vectores=X[nuestros])
dibujar_clases(X, y)
plt.xlabel("$x_1$")
plt.ylabel("$x_2$")
plt.title("La calle más ancha (C = 1)")
plt.show()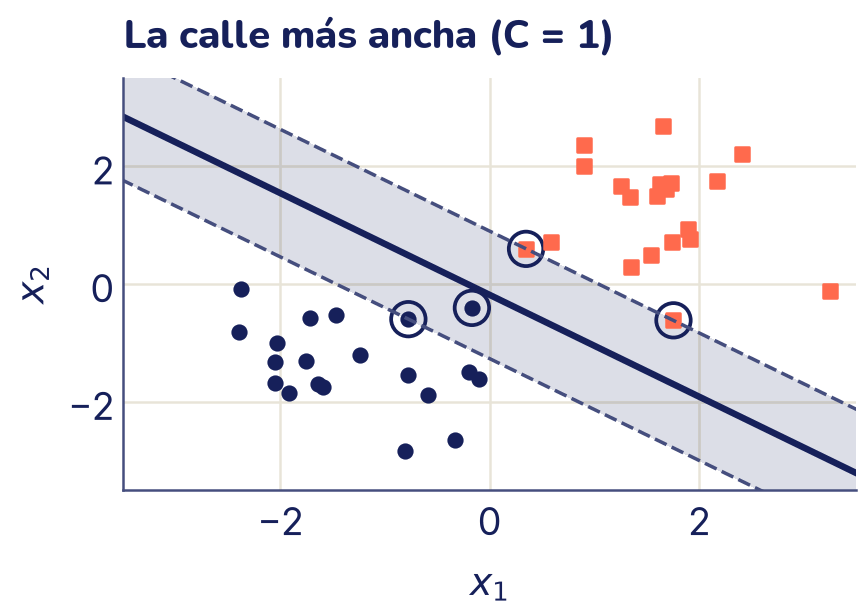
Si borraras cualquiera de los 36 puntos sin anillo y volvieras a entrenar, la recta sería exactamente la misma. Lo vas a comprobar en el ejercicio 1.
C: cuánto manda un atípico
Agreguemos a los datos un punto atípico: un círculo de la clase 0 metido en la zona de los cuadrados. Las clases todavía se pueden separar con una recta, pero muy forzada. Entrenamos con cuatro valores de C. Desde aquí usamos SVC, que ya comprobamos que da lo mismo que nuestro código.
# Un círculo de la clase 0 metido en la zona de la clase 1
X_atip = np.vstack([X, [[0.3, 1.0]]])
y_atip = np.append(y, 0)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for eje, C in zip(ejes.flat, [0.01, 0.1, 1, 100]):
    modelo = SVC(kernel="linear", C=C).fit(X_atip, y_atip)
    w, b = modelo.coef_[0], modelo.intercept_[0]
    ancho = 2 / np.linalg.norm(w)
    dibujar_svm(w, b, ax=eje, vectores=modelo.support_vectors_)
    dibujar_clases(X_atip, y_atip, ax=eje, s=10)
    eje.set_title(f"C = {C}\nancho {ancho:.2f}")
    print(f"C = {C:5}:  ancho {ancho:.2f}"
          f"   vectores de soporte {len(modelo.support_):2d}"
          f"   el atípico va a la clase {modelo.predict([[0.3, 1.0]])[0]}")
plt.show()
C = 0.01: ancho 4.67 vectores de soporte 28 el atípico va a la clase 1
C = 0.1: ancho 2.56 vectores de soporte 10 el atípico va a la clase 1
C = 1: ancho 1.85 vectores de soporte 5 el atípico va a la clase 1
C = 100: ancho 0.19 vectores de soporte 3 el atípico va a la clase 0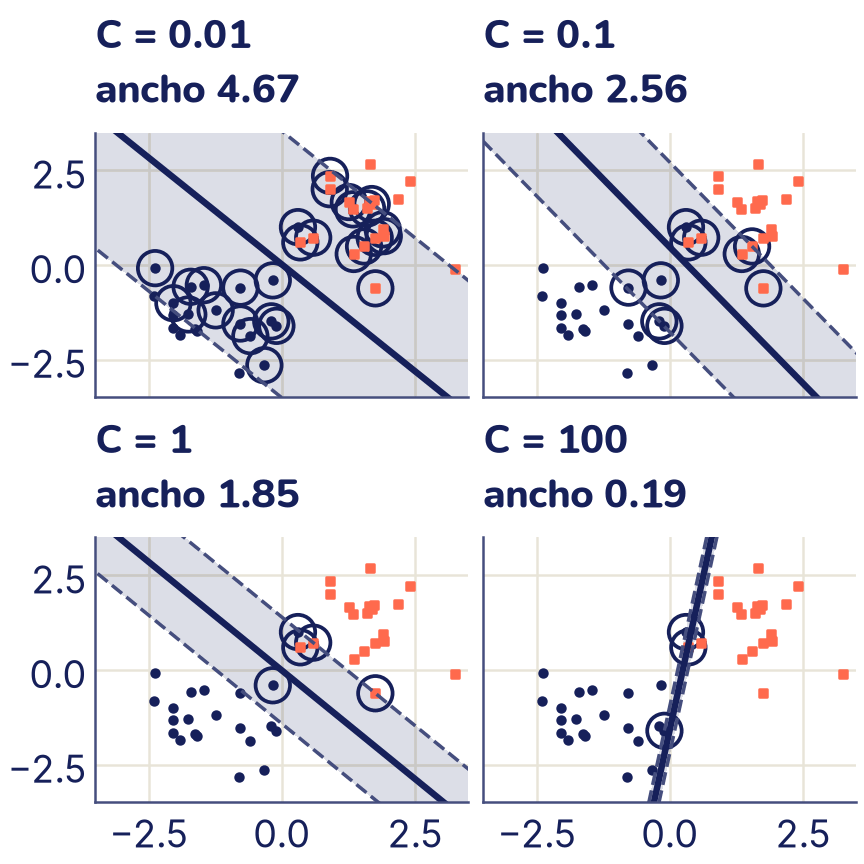
Léelo de abajo hacia arriba:
- Con C = 100, una multa es carísima, así que la SVM gira la frontera hasta dejar al atípico de su lado, con una calle de 0,19 de ancho. Acierta con todos los puntos de entrenamiento, pero esa recta casi vertical no describe los dos grupos: un solo punto, quizá un error al anotar los datos, decidió todo. Es sobreajuste.
- Con C = 1 o 0,1, la SVM acepta perder al atípico (lo clasifica como clase 1) y a cambio abre una calle diagonal y ancha que sigue la forma de los dos grupos.
- Con C = 0,01, la calle es tan ancha que 28 de los 41 puntos quedan dentro o sobre sus bordes: son vectores de soporte. La frontera ya casi no depende de ningún punto en particular; si C bajara todavía más, dejaría de separar bien. Es el lado del subajuste.
Cuando C baja, más puntos son vectores de soporte: la frontera se decide entre muchos, y ninguno manda solo. Es lo que viste con el deslizador de la actividad. El mejor C no se adivina: se busca con validación cruzada, como cualquier hiperparámetro.
Escalar es obligatorio
La SVM mide distancias: el ancho de la calle y el puntaje dependen de los números de cada característica. Si una va de 0 a 1 y otra de 0 a 1000, la segunda decide sola, como pasaba con k-NN en el tema 8. Probémoslo con el conjunto de datos vinos (load_wine, incluido en scikit-learn): 178 vinos de tres productores, con 13 medidas químicas en escalas muy distintas (la prolina varía en más de 1400 unidades; el tono del color, en poco más de 1). SVC maneja tres clases por su cuenta, entrenando una SVM por cada par de clases.
from sklearn.datasets import load_wine
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X_vino, y_vino = load_wine(return_X_y=True)
# Columna 12: prolina. Columna 10: tono del color
print(f"La prolina varía en {np.ptp(X_vino[:, 12]):.0f};"
      f" el tono, en {np.ptp(X_vino[:, 10]):.2f}")

sin_escalar = cross_val_score(SVC(), X_vino, y_vino, cv=5).mean()
escalado = cross_val_score(make_pipeline(StandardScaler(), SVC()),
                           X_vino, y_vino, cv=5).mean()
print(f"Exactitud sin escalar: {sin_escalar:.3f}")
print(f"Exactitud estandarizando: {escalado:.3f}")
La prolina varía en 1402; el tono, en 1.23
Exactitud sin escalar: 0.663
Exactitud estandarizando: 0.983De 0,66 a 0,98 con una sola línea. Como en el tema 10, el escalador va dentro del pipeline, para que en cada pliegue de la validación cruzada aprenda la media y la desviación solo con los datos de entrenamiento.
Fronteras curvas: el truco del kernel
Una recta no alcanza para todo. make_circles genera dos clases sintéticas en forma de anillos, una dentro de la otra: ninguna recta las separa. Pero mira lo que pasa si a cada punto le agregamos una tercera coordenada, su distancia al cuadrado al centro:
from sklearn.datasets import make_circles
from sklearn.svm import LinearSVC

# 200 puntos sintéticos: la clase 1 es el anillo de adentro
X_circ, y_circ = make_circles(n_samples=200, factor=0.4, noise=0.08,
                              random_state=0)
# Levantamos cada punto: la altura es su distancia al cuadrado al centro
x3 = X_circ[:, 0] ** 2 + X_circ[:, 1] ** 2
X_3d = np.column_stack([X_circ, x3])

plano = LinearSVC().fit(X_circ, y_circ)
espacio = LinearSVC().fit(X_3d, y_circ)
print(f"Recta en el plano:     aciertos {plano.score(X_circ, y_circ):.2f}")
print(f"Plano en 3D:           aciertos {espacio.score(X_3d, y_circ):.2f}")
print(f"Altura de la clase 1:  hasta {x3[y_circ == 1].max():.2f}")
print(f"Altura de la clase 0:  desde {x3[y_circ == 0].min():.2f}")

fig = plt.figure()
eje = fig.add_subplot(projection="3d")
for clase, color, marca in [(0, "C0", "o"), (1, "C1", "s")]:
    m = y_circ == clase
    eje.scatter(X_circ[m, 0], X_circ[m, 1], x3[m], color=color,
                marker=marca, s=12, depthshade=False)
# Un plano horizontal a media altura separa las dos clases
A, B = np.meshgrid(np.linspace(-1.2, 1.2, 2), np.linspace(-1.2, 1.2, 2))
eje.plot_surface(A, B, np.full_like(A, 0.48), color="C2", alpha=0.3)
eje.set_xlabel("$x_1$")
eje.set_ylabel("$x_2$")
eje.set_zlabel("$x_3$")
eje.set_title("Levantar los anillos a 3D")
plt.show()
Recta en el plano: aciertos 0.50
Plano en 3D: aciertos 1.00
Altura de la clase 1: hasta 0.34
Altura de la clase 0: desde 0.62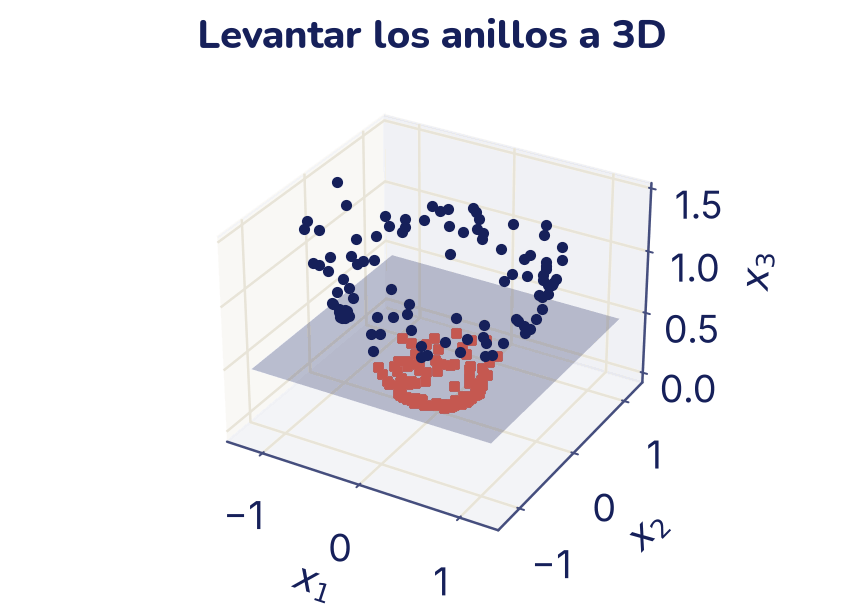
En el plano, la mejor recta acierta la mitad: lo mismo que tirar una moneda. Al levantar los puntos, los del anillo de adentro quedan abajo (altura hasta 0,34) y los de afuera, arriba (desde 0,62). Un plano horizontal los separa a todos, y una SVM lineal lo encuentra. Si vuelves a mirar desde arriba, ese plano corta al dibujo en un círculo: una frontera lineal en 3D es una frontera curva en el plano original.
Esa es la idea de fondo: agregar características nuevas convierte un problema curvo en uno lineal. El problema es que, para fronteras complicadas, harían falta muchísimas características nuevas. Aquí entra el truco del kernel.
Similitudes en lugar de coordenadas
Se puede demostrar (no lo haremos aquí) que la SVM nunca necesita las coordenadas de los puntos por separado: solo usa los productos punto entre pares de puntos, x·x′ (el tema 3: multiplicar coordenada por coordenada y sumar). Un kernel es una función K(x, x′) que calcula directamente el producto punto de los puntos ya levantados, sin levantarlos nunca. Comprobémoslo con un levantamiento concreto: φ(x) = (x₁², √2·x₁x₂, x₂²).
def levantar(p):
    """Tres características nuevas a partir de (x1, x2)."""
    return np.array([p[0] ** 2, np.sqrt(2) * p[0] * p[1], p[1] ** 2])

a = np.array([1.0, 2.0])
c = np.array([3.0, -1.0])
print("Levantando y multiplicando:", round(levantar(a) @ levantar(c), 6))
print("Con el kernel (a·c)²:      ", (a @ c) ** 2)
Levantando y multiplicando: 1.0
Con el kernel (a·c)²: 1.0Dan lo mismo: el producto punto en el espacio de tres características se calcula con el producto punto original, elevado al cuadrado. Para dos números no ahorra nada, pero con kernels de grado alto o con muchas características el ahorro es enorme. Los tres kernels más usados son:
El polinomial de grado d equivale a agregar todos los productos de hasta d características. El RBF (radial basis function, función de base radial; es el que usa SVC si no le dices otro) mide parecido: vale 1 si los dos puntos coinciden y baja hacia 0 cuando se alejan. Con él, el puntaje de un punto nuevo es una suma de «montañitas», una centrada en cada vector de soporte, que suman hacia su clase. El número gamma (γ) decide qué tan angosta es cada montañita: con γ grande, cada vector de soporte solo influye muy cerca de sí mismo.
for nombre, modelo in [("lineal", SVC(kernel="linear")),
                       ("polinomial, grado 2", SVC(kernel="poly",
                                                   degree=2)),
                       ("RBF", SVC(kernel="rbf"))]:
    modelo.fit(X_circ, y_circ)
    print(f"Kernel {nombre:20s} aciertos {modelo.score(X_circ, y_circ):.2f}")
Kernel lineal aciertos 0.62
Kernel polinomial, grado 2 aciertos 1.00
Kernel RBF aciertos 1.00El kernel lineal no puede con los anillos. El polinomial de grado 2 incluye x₁² y x₂², las piezas del levantamiento que hicimos a mano, y el RBF encuentra la forma solo.
C y gamma juntos
Volvamos a las dos medias lunas del tema 8, con la misma división en entrenamiento y validación. El kernel RBF tiene dos perillas: C, cuánto cuesta cada multa, y γ, el alcance de cada vector de soporte.
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split

# Las dos lunas del tema 8, con la misma división
X_lunas, y_lunas = make_moons(n_samples=200, noise=0.3, random_state=0)
X_entr, X_val, y_entr, y_val = train_test_split(
    X_lunas, y_lunas, test_size=0.3, random_state=0)

A, B = np.meshgrid(np.linspace(-2, 3, 200), np.linspace(-1.5, 2, 200))
rejilla = np.column_stack([A.ravel(), B.ravel()])

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for eje, (gamma, C) in zip(ejes.flat,
                           [(0.1, 1), (0.1, 100), (10, 1), (10, 100)]):
    modelo = SVC(kernel="rbf", C=C, gamma=gamma).fit(X_entr, y_entr)
    zona = modelo.predict(rejilla).reshape(A.shape)
    # Cada región, del color de su clase y muy clara
    eje.contourf(A, B, zona, levels=[-0.5, 0.5, 1.5],
                 colors=["C0", "C1"], alpha=0.2)
    dibujar_clases(X_entr, y_entr, ax=eje, s=8)
    eje.set_title(f"gamma = {gamma}\nC = {C}")
    print(f"γ = {gamma:4}, C = {C:3}:  aciertos al entrenar "
          f"{modelo.score(X_entr, y_entr):.2f}"
          f"   en validación {modelo.score(X_val, y_val):.2f}")
plt.show()
γ = 0.1, C = 1: aciertos al entrenar 0.82 en validación 0.83
γ = 0.1, C = 100: aciertos al entrenar 0.85 en validación 0.88
γ = 10, C = 1: aciertos al entrenar 0.94 en validación 0.93
γ = 10, C = 100: aciertos al entrenar 0.98 en validación 0.83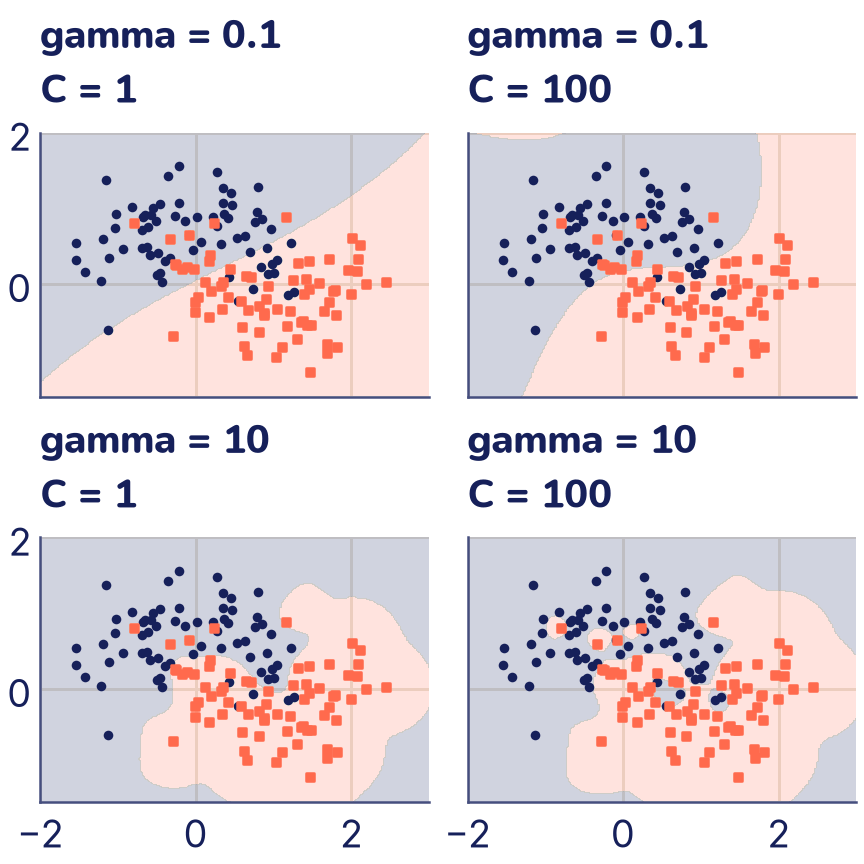
- Con γ = 0,1, cada vector de soporte influye en una zona enorme y la frontera queda casi recta, o apenas curvada: no logra seguir las lunas. Subir C la curva un poco y ayuda algo, pero no alcanza. Es subajuste, como la logística del tema 8.
- Con γ = 10 y C = 1, la frontera se curva con las lunas y le va bien en validación.
- Con γ = 10 y C = 100, la SVM persigue cada punto: acierta casi todo al entrenar, arma islas alrededor de puntos sueltos y en validación le va peor. Es sobreajuste, como k-NN con k = 1.
Un γ grande y un C grande empujan en la misma dirección: hacia una frontera más complicada.
Elegir C y gamma con validación cruzada
Como en el tema 10, los hiperparámetros se eligen con GridSearchCV sobre un pipeline que incluye el escalador. C y γ se prueban en escala logarítmica (0,1, 1, 10, 100), porque lo que importa es su orden de magnitud. Los nombres de los pasos de make_pipeline son los de las clases en minúsculas: svc__C es el C del paso svc.
from sklearn.model_selection import GridSearchCV
import pandas as pd

pipe = make_pipeline(StandardScaler(), SVC(kernel="rbf"))
rejilla_hp = {"svc__C": [0.1, 1, 10, 100],
              "svc__gamma": [0.1, 1, 10, 100]}
busqueda = GridSearchCV(pipe, rejilla_hp, cv=5)
busqueda.fit(X_entr, y_entr)

# La exactitud media de validación cruzada de las 16 combinaciones
tabla = pd.DataFrame(busqueda.cv_results_["params"])
tabla["exactitud"] = busqueda.cv_results_["mean_test_score"]
print(tabla.pivot(index="svc__C", columns="svc__gamma",
                  values="exactitud").round(2))
print("Mejor combinación:", busqueda.best_params_)
print(f"Exactitud en validación cruzada: {busqueda.best_score_:.3f}")
print(f"Exactitud en el conjunto de validación: "
      f"{busqueda.score(X_val, y_val):.3f}")
svc__gamma 0.1 1.0 10.0 100.0
svc__C
0.1 0.82 0.84 0.51 0.51
1.0 0.83 0.87 0.86 0.69
10.0 0.84 0.89 0.82 0.71
100.0 0.85 0.86 0.83 0.70
Mejor combinación: {'svc__C': 10, 'svc__gamma': 1}
Exactitud en validación cruzada: 0.886
Exactitud en el conjunto de validación: 0.950Las peores casillas tienen γ grande. Con γ = 100, cada vector de soporte solo ve su vecindad inmediata y la exactitud cae a 0,7 o menos. Con γ = 10 o 100 y C = 0,1, el modelo casi no aprende y acierta la mitad, lo mismo que tirar una moneda. En la columna de γ = 0,1 la frontera es demasiado simple y se queda entre 0,82 y 0,85. La mejor combinación, C = 10 y γ = 1, llega a 0,886 en validación cruzada y a 0,95 en el conjunto de validación. Entre las casillas buenas las diferencias son de uno o dos puntos, del mismo tamaño que el vaivén entre pliegues: no te tomes al pie de la letra cuál ganó. La SVM con kernel RBF le gana en validación a la logística del tema 8 (0,85), que solo puede trazar una recta.
Muchos datos: LinearSVC frente a SVC
SVC trabaja con el kernel entre pares de puntos. Con n ejemplos hay del orden de n² pares, así que duplicar los datos hace el entrenamiento entre cuatro y ocho veces más lento. Con cientos de miles de ejemplos se vuelve impracticable. Si una frontera lineal alcanza, LinearSVC resuelve el mismo tipo de problema con un método pensado para el caso lineal, que crece más o menos en proporción a n. Comparemos con 5000 ejemplos sintéticos de 20 características:
import time
from sklearn.datasets import make_classification

X_grande, y_grande = make_classification(n_samples=5000, n_features=20,
                                         random_state=0)
inicio = time.perf_counter()
lento = SVC(kernel="linear").fit(X_grande, y_grande)
t_svc = time.perf_counter() - inicio

inicio = time.perf_counter()
rapido = LinearSVC().fit(X_grande, y_grande)
t_lineal = time.perf_counter() - inicio

print(f"SVC:       aciertos {lento.score(X_grande, y_grande):.3f}"
      f"   vectores de soporte {len(lento.support_)}")
print(f"LinearSVC: aciertos {rapido.score(X_grande, y_grande):.3f}")
print("¿LinearSVC fue más de 10 veces más rápido?", t_svc > 10 * t_lineal)
SVC: aciertos 0.955 vectores de soporte 646
LinearSVC: aciertos 0.954
¿LinearSVC fue más de 10 veces más rápido? TrueAciertan lo mismo, pero LinearSVC termina muchísimo antes. (No imprimimos los segundos porque cambian de una computadora a otra; en Colab vas a ver la diferencia.) Fíjate además en cuántos vectores de soporte hay: 646 de 5000. Con datos que se mezclan, muchos ejemplos quedan dentro de la calle, y SVC tiene que guardarlos todos para predecir. La regla práctica: con pocos miles de ejemplos, SVC con kernel RBF es una excelente opción; con muchos más, LinearSVC o, si la frontera tiene que ser curva, un bosque o una red neuronal.
Lo que aprendiste y lo que sigue
- Una SVM elige, entre todas las fronteras que separan las clases, la que deja la calle más ancha. El ancho de la calle es 2/‖w‖, así que una calle ancha significa pesos chicos.
- Los vectores de soporte son los puntos que tocan la calle o se meten en ella. Solo ellos definen la frontera: los demás se pueden mover o borrar sin cambiar nada.
- La pérdida bisagra, max(0, 1 − y·z), vale cero para los puntos bien ubicados fuera de la calle. La entropía cruzada nunca llega a cero, por eso en la logística todos los puntos influyen.
- El margen suave suma ½‖w‖² y C veces las multas. Con C grande la SVM persigue cada punto (sobreajuste); con C chico abre la calle y tolera errores (subajuste si se pasa).
- Se puede entrenar con descenso de subgradiente: el mismo bucle del tema 6, eligiendo una pendiente en la esquina de la bisagra.
- Hay que escalar las características, siempre dentro de un pipeline.
- El truco del kernel da fronteras curvas: levantar los datos a más dimensiones vuelve lineal un problema curvo, y el kernel calcula los productos punto de los puntos levantados sin construirlos. El RBF tiene un γ que controla el alcance de cada vector de soporte; C y γ se eligen con validación cruzada.
SVCse vuelve lento con muchos ejemplos;LinearSVCescala mucho mejor si una frontera lineal alcanza.
En el próximo tema los datos traen algo nuevo: un orden en el tiempo, que cambia cómo se divide en entrenamiento y validación. Y en la fase 4 vas a ver otra forma de conseguir fronteras curvas: en lugar de elegir un kernel, una red neuronal aprende sus propias características.