La pregunta
¿Conoces el juego de adivinar un personaje con preguntas de sí o no? «¿Es mujer?», «¿Tiene más de 30 años?», «¿Usa lentes?». Un buen jugador no pregunta cualquier cosa: elige la pregunta que más reduce las posibilidades, y según la respuesta decide cuál es la siguiente.
Un árbol de decisión es un modelo que juega a eso con los datos. En lugar de una fórmula con pesos, como la regresión lineal o la logística, aprende una lista de preguntas encadenadas: «¿el pasajero es mujer? Si sí, ¿viajaba en primera o segunda clase?…». Al final de cada camino hay una predicción. Es uno de los modelos más fáciles de leer, y hay un giro: un árbol solo se equivoca bastante, pero cientos de árboles juntos están entre los mejores modelos que existen para datos en tablas.
En este tema vas a:
- entender cómo un árbol elige cada pregunta con la impureza de Gini (o la entropía) y la ganancia;
- programar desde cero, con NumPy, el mejor corte de una variable;
- controlar el sobreajuste de un árbol con
max_depthymin_samples_leaf; - explicar bagging y random forest como el promedio de muchos árboles distintos;
- explicar gradient boosting como una cadena de árboles en la que cada uno corrige los errores de los anteriores;
- comparar los modelos y medir qué variables importan con la importancia por permutación.
Necesitas lo de los temas anteriores: dividir en entrenamiento, validación y prueba, y la validación cruzada (tema 7), la exactitud como métrica (temas 8 y 9) y armar un Pipeline con ColumnTransformer (tema 10).
Actividad: corta el plano
Hay puntos de dos clases, tinta (círculos) y coral (cuadrados). Tu trabajo es separarlos solo con cortes rectos: líneas verticales u horizontales. Cada corte divide una región en dos, y cada lado puede volver a cortarse. Lo que vas armando, sin saberlo, es un árbol de decisión.
Corta el plano
Este es el estado inicial: una sola región, sin cortes. Con JavaScript activado puedes cortar el plano, pedir el mejor corte, armar el árbol automático y el bosque.
Con 0 se ve tu árbol. Con 1 o más, el voto de árboles entrenados con muestras bootstrap de los puntos.
región: 44 puntos (28 tinta, 16 coral), Gini 0,463lados: —ganancia: —regiones: 1, puntos mal clasificados: 16
Pasa el puntero por el plano o mueve la posición para ver un corte de prueba; tócalo o pulsa «Cortar aquí» para cortarlo.
Prueba esto, en orden:
- Elige «Vertical», pasa el puntero sobre el plano (o mueve el deslizador de posición) y mira cómo cambian el Gini de cada lado y la ganancia. Busca el corte con la ganancia más grande y córtalo.
- Sigue cortando las regiones que todavía mezclan colores. ¿Cuántos cortes necesitas para que cada región quede de un solo color?
- Pulsa «Empezar de nuevo» y luego «Mejor corte» en la región entera. ¿La computadora eligió el mismo corte que tú?
- Pulsa «Árbol automático». El árbol corta hasta que cada región es pura. Mira las regiones angostas que encierran a un solo punto: ¿te parecen una regla que serviría para puntos nuevos?
- Mueve el deslizador «Árboles del bosque». Con 1 árbol ves un solo árbol entrenado con una muestra al azar de los puntos; con 25, el promedio de 25 árboles distintos. ¿Cómo cambia la frontera?
La idea del tema completa está aquí: un árbol corta el plano en rectángulos eligiendo cada vez el corte que más «limpia» las regiones; uno solo memoriza detalles, y muchos promediados dibujan una frontera más suave y más confiable.
Los datos: el Titanic
Vamos a trabajar con los pasajeros del Titanic, el barco que se hundió en 1912. La tabla trae, para 891 pasajeros, la clase en que viajaban, el sexo, la edad, cuántos familiares iban con ellos, la tarifa que pagaron, el puerto donde subieron y si sobrevivieron. Viene con la librería seaborn. Es un caso real y triste: los números que vas a ver son personas. Nos sirve porque las reglas que va a encontrar el árbol cuentan una historia que se puede comprobar.
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

titanic = sns.load_dataset("titanic")

# Las columnas que vamos a usar, con nombres en español
columnas = {"pclass": "clase", "sex": "sexo", "age": "edad",
            "sibsp": "hermanos_pareja", "parch": "padres_hijos",
            "fare": "tarifa", "embarked": "puerto"}
X = titanic[list(columnas)].rename(columns=columnas)
X["sexo"] = X["sexo"].map({"male": "hombre", "female": "mujer"})
y = titanic["survived"]               # 1 = sobrevivió, 0 = murió

print(X.shape)
print(X.head(3))
print("Faltantes:", X.isna().sum()[X.isna().sum() > 0].to_dict())
print(f"Sobrevivió el {y.mean():.1%} de los pasajeros")
(891, 7)
clase sexo edad hermanos_pareja padres_hijos tarifa puerto
0 3 hombre 22.0 1 0 7.2500 S
1 1 mujer 38.0 1 0 71.2833 C
2 3 mujer 26.0 0 0 7.9250 S
Faltantes: {'edad': 177, 'puerto': 2}
Sobrevivió el 38.4% de los pasajerosHay edades que faltan y dos pasajeros sin puerto. Antes de entrenar, separamos un conjunto de prueba que no vamos a mirar hasta el final (tema 7) y armamos el mismo tipo de preparación del tema 10: un ColumnTransformer que imputa la mediana en las columnas numéricas y, en las categóricas, imputa el valor más frecuente y las pasa a columnas one-hot.
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline, make_pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder
from sklearn.base import clone

X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=0)

numericas = ["clase", "edad", "hermanos_pareja", "padres_hijos", "tarifa"]
categoricas = ["sexo", "puerto"]
categoricas_a_numeros = make_pipeline(
    SimpleImputer(strategy="most_frequent"),
    # drop="if_binary": «sexo» queda en una sola columna, sexo_mujer
    OneHotEncoder(drop="if_binary", handle_unknown="ignore",
                  sparse_output=False))
preparar = ColumnTransformer(
    [("num", SimpleImputer(strategy="median"), numericas),
     ("cat", categoricas_a_numeros, categoricas)],
    verbose_feature_names_out=False)

def con_preparacion(modelo):
    """Un Pipeline: preparar los datos y después el modelo."""
    return Pipeline([("preparar", clone(preparar)), ("modelo", modelo)])

A = preparar.fit_transform(X_ent)     # solo con entrenamiento
nombres = preparar.get_feature_names_out()
y_arr = y_ent.to_numpy()
print(len(X_ent), "pasajeros para entrenar,",
      len(X_prueba), "para la prueba final")
print("Columnas:", ", ".join(nombres[:5]))
print("         ", ", ".join(nombres[5:]))
668 pasajeros para entrenar, 223 para la prueba final
Columnas: clase, edad, hermanos_pareja, padres_hijos, tarifa
sexo_mujer, puerto_C, puerto_Q, puerto_SFíjate en algo que no hicimos: escalar. Un árbol solo pregunta «¿esta variable es menor que tal número?», y la respuesta no cambia si la variable se mide en bolivianos o en dólares, en años o en meses. Por eso a los árboles no les importa la escala, a diferencia de k-NN o la regresión logística.
¿Qué es un buen corte? La impureza de Gini
Un árbol empieza con todos los pasajeros juntos y busca una pregunta de sí o no que los separe en dos grupos. Una pregunta es buena si los grupos que deja son lo más «puros» posible: idealmente, en uno solo sobrevivientes y en el otro solo no sobrevivientes.
Para medir qué tan mezclado está un grupo se usa la impureza de Gini. Si en el grupo una fracción pk de los ejemplos es de la clase k:
Tiene una lectura muy concreta: es la probabilidad de equivocarte si tomas un ejemplo del grupo al azar y le pones una etiqueta también al azar, sorteada con las proporciones del grupo. Con dos clases:
- Un grupo puro (todos de la misma clase) tiene Gini = 1 − 1² = 0.
- Un grupo mitad y mitad tiene Gini = 1 − 0,5² − 0,5² = 0,5, el máximo con dos clases.
def gini(etiquetas):
    """Impureza de Gini de un grupo de etiquetas."""
    _, cuentas = np.unique(etiquetas, return_counts=True)
    p = cuentas / len(etiquetas)      # proporción de cada clase
    return 1 - np.sum(p ** 2)

print("Puro:          ", gini([1, 1, 1, 1]))
print("Mitad y mitad: ", gini([0, 1, 0, 1]))
print("Tres a uno:    ", gini([0, 0, 0, 1]))
print(f"Titanic entero: {gini(y_arr):.3f}")
Puro: 0.0
Mitad y mitad: 0.5
Tres a uno: 0.375
Titanic entero: 0.473Un corte divide un grupo en dos lados, izquierdo y derecho. La impureza después del corte es el promedio de las dos impurezas, ponderado por cuántos ejemplos quedan en cada lado (un lado con 3 pasajeros no puede pesar lo mismo que uno con 300). La ganancia es cuánto bajó la impureza:
El árbol elige, entre todas las preguntas posibles, la de mayor ganancia. Es lo que hacías en la actividad al buscar el corte con el número más grande.
La entropía, la otra medida. En lugar de Gini se puede usar la entropía de la teoría de la información:
También vale 0 en un grupo puro, y con dos clases llega a 1 en el grupo mitad y mitad. La ganancia calculada con la entropía se llama ganancia de información. En la práctica, Gini y entropía casi siempre eligen los mismos cortes; scikit-learn usa Gini por defecto (criterion="gini") y acepta criterion="entropy". En los ejercicios vas a comparar las dos.
El mejor corte, desde cero
Para una variable numérica, las preguntas posibles son «¿x ≤ u?» para distintos umbrales u. No hace falta probar infinitos umbrales: basta con los puntos medios entre valores distintos consecutivos, porque entre dos valores vecinos cualquier umbral separa a los pasajeros igual. La función prueba todos y se queda con el de menor impureza ponderada, que es el de mayor ganancia.
def mejor_corte(x, etiquetas):
    """El umbral u de la pregunta «¿x <= u?» con mayor ganancia.

    Devuelve el mejor umbral, su ganancia, y todos los umbrales
    probados con su impureza ponderada (para graficarlos).
    """
    valores = np.unique(x)            # ordenados y sin repetir
    umbrales = (valores[:-1] + valores[1:]) / 2
    n = len(etiquetas)
    ponderadas = []
    for u in umbrales:
        izq = etiquetas[x <= u]
        der = etiquetas[x > u]
        ponderadas.append((len(izq) * gini(izq)
                           + len(der) * gini(der)) / n)
    ponderadas = np.array(ponderadas)
    k = np.argmin(ponderadas)
    ganancia = gini(etiquetas) - ponderadas[k]
    return umbrales[k], ganancia, umbrales, ponderadas

# El mejor corte de cada columna, para la raíz del árbol
for j, nombre in enumerate(nombres):
    u, ganancia, _, _ = mejor_corte(A[:, j], y_arr)
    print(f"{nombre:16s} ¿<= {u:6.2f}?   ganancia = {ganancia:.3f}")
clase ¿<= 2.50? ganancia = 0.059
edad ¿<= 0.96? ganancia = 0.007
hermanos_pareja ¿<= 0.50? ganancia = 0.006
padres_hijos ¿<= 0.50? ganancia = 0.010
tarifa ¿<= 50.74? ganancia = 0.049
sexo_mujer ¿<= 0.50? ganancia = 0.145
puerto_C ¿<= 0.50? ganancia = 0.010
puerto_Q ¿<= 0.50? ganancia = 0.000
puerto_S ¿<= 0.50? ganancia = 0.008La pregunta ganadora es la del sexo, con mucha diferencia: «¿sexo_mujer ≤ 0,5?», es decir, «¿es hombre?». La segunda es la clase del pasaje. Es lo que cuenta la historia: en la evacuación se priorizó a las mujeres y a los niños, y los pasajeros de primera clase tenían los camarotes más cerca de los botes salvavidas.
El árbol no se detiene ahí. Repite la misma búsqueda dentro de cada lado. Mira lo que pasa con la edad, pero ahora solo entre los hombres:
hombres = A[:, list(nombres).index("sexo_mujer")] == 0
edad_h = A[hombres, list(nombres).index("edad")]
u, ganancia, umbrales, ponderadas = mejor_corte(edad_h, y_arr[hombres])
print(f"Entre los hombres: ¿edad <= {u:g}?   ganancia = {ganancia:.3f}")
menores = y_arr[hombres][edad_h <= u]
print(f"Hombres de {u:g} años o menos: {len(menores)},"
      f" sobrevivió el {menores.mean():.0%}")

plt.plot(umbrales, ponderadas, color="C0")
plt.scatter([u], [ponderadas.min()], color="C1", s=120, zorder=3,
            label=f"Mejor corte: {u:g} años")
plt.xlabel("Umbral de edad (años)")
plt.ylabel("Gini ponderado")
plt.title("Hombres: Gini según el corte")
plt.legend(loc="center right")
plt.show()
Entre los hombres: ¿edad <= 13? ganancia = 0.022
Hombres de 13 años o menos: 30, sobrevivió el 57%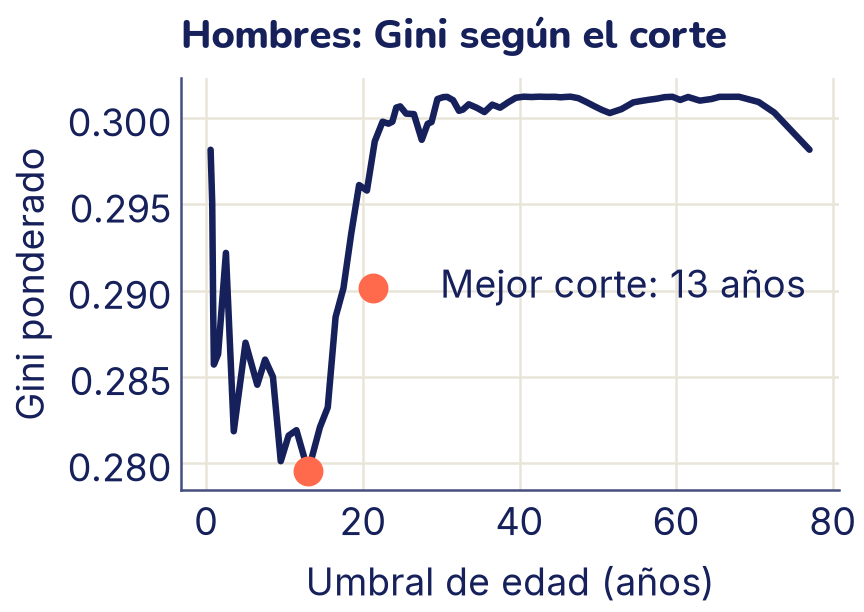
Entre los hombres, la edad casi no separa nada, salvo por un pozo muy claro: los niños. Esa pregunta no aparecía entre las mejores de la raíz (con todos los pasajeros juntos, la edad sola casi no ayuda), pero dentro de un grupo puede ser la mejor. Así trabaja un árbol: cada pregunta se elige mirando solo a los ejemplos que llegaron a ese lugar. Este procedimiento, que elige el mejor corte en cada paso sin pensar en los siguientes, se llama voraz (greedy).
Un árbol con scikit-learn
DecisionTreeClassifier hace exactamente esto, para todas las columnas y en cada rama. Lo ponemos dentro de nuestro pipeline y le limitamos la profundidad a 2 (dos preguntas como máximo) para poder dibujarlo. plot_tree lo dibuja; el bucle de después solo cambia los colores de las cajas y traduce «True» y «False».
from sklearn.tree import DecisionTreeClassifier, plot_tree

arbol2 = con_preparacion(DecisionTreeClassifier(max_depth=2,
                                                random_state=0))
arbol2.fit(X_ent, y_ent)

plt.figure(figsize=(4.8, 3.6))
cajas = plot_tree(arbol2["modelo"], feature_names=nombres,
                  class_names=["murió", "vivió"], label="none",
                  impurity=False, proportion=True, precision=2,
                  rounded=True, fontsize=12)
for caja in cajas:
    texto = caja.get_text().strip()
    if texto in ("True", "False"):
        caja.set_text("sí" if texto == "True" else "no")
    elif texto.endswith("vivió"):
        caja.get_bbox_patch().set(facecolor="C3", edgecolor="C3")
    else:
        caja.get_bbox_patch().set(facecolor="white", edgecolor="C2")
plt.show()

print(f"Exactitud en entrenamiento: {arbol2.score(X_ent, y_ent):.3f}")
Exactitud en entrenamiento: 0.801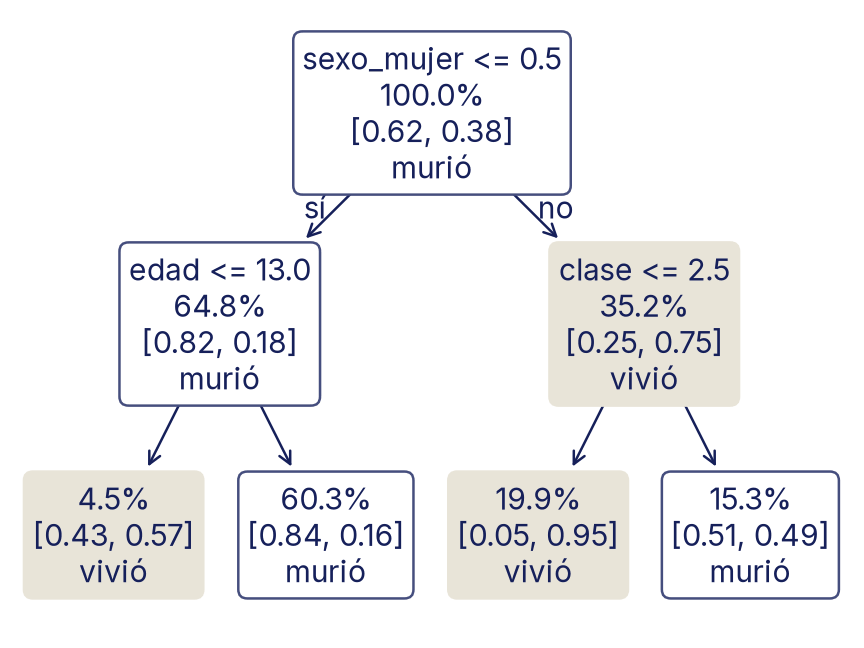
Cómo se lee cada caja:
- La primera línea es la pregunta (las hojas, abajo, no tienen pregunta). Si la respuesta es sí, se sigue por la izquierda.
- El porcentaje es la parte de los pasajeros de entrenamiento que llega a esa caja.
- El par de números es la proporción de cada clase en la caja: [murió, vivió].
- La última línea es la predicción: la clase mayoritaria de la caja.
Son los mismos cortes que encontraste con mejor_corte: el sexo en la raíz y, entre los hombres, la edad de 13 años. Para predecir un pasajero nuevo se lo hace bajar por el árbol, respondiendo las preguntas, hasta llegar a una hoja. La probabilidad que da predict_proba es la proporción de la hoja: una mujer de primera clase cae en la hoja con [0,05, 0,95] y recibe 95 % de probabilidad de sobrevivir.
En el plano de la actividad, cada pregunta es un corte recto y cada hoja es un rectángulo. Con muchas variables pasa lo mismo, en más dimensiones: un árbol divide el espacio en cajas y en cada caja predice una constante.
Profundidad y sobreajuste
¿Qué pasa si dejamos crecer el árbol sin límite? Sigue cortando hasta que cada hoja es pura, aunque tenga un solo ejemplo. Para verlo en un dibujo usamos datos sintéticos de dos variables, las «dos lunas» de make_moons, con bastante ruido.
from sklearn.datasets import make_moons

X2, y2 = make_moons(n_samples=300, noise=0.3, random_state=0)
X2_ent, X2_val, y2_ent, y2_val = train_test_split(
    X2, y2, test_size=0.5, random_state=0)

# Una rejilla fina para pintar la región de cada clase
xx, yy = np.meshgrid(np.linspace(-2, 3, 300), np.linspace(-1.5, 2, 300))
rejilla = np.column_stack([xx.ravel(), yy.ravel()])

def dibujar_puntos(eje):
    """Clase 1: puntos llenos. Clase 0: puntos huecos."""
    eje.scatter(*X2_ent[y2_ent == 1].T, s=12, color="C0")
    eje.scatter(*X2_ent[y2_ent == 0].T, s=12, facecolors="white",
                edgecolors="C0", linewidths=0.8)
    eje.set_xticks([])
    eje.set_yticks([])

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
dibujar_puntos(ejes[0, 0])
ejes[0, 0].set_title("Los datos")
for eje, prof in zip([ejes[0, 1], ejes[1, 0], ejes[1, 1]], [1, 3, 10]):
    a = DecisionTreeClassifier(max_depth=prof, random_state=0)
    a.fit(X2_ent, y2_ent)
    z = a.predict(rejilla).reshape(xx.shape)
    # Se pinta solo la región donde el árbol predice la clase 1
    eje.contourf(xx, yy, z, levels=[0.5, 1.5], colors=["C0"], alpha=0.15)
    dibujar_puntos(eje)
    eje.set_title(f"Profundidad {prof}")
    print(f"Profundidad {prof:2d}: {a.get_n_leaves():2d} hojas,"
          f" entrenamiento {a.score(X2_ent, y2_ent):.2f},"
          f" validación {a.score(X2_val, y2_val):.2f}")
plt.show()
Profundidad 1: 2 hojas, entrenamiento 0.83, validación 0.78
Profundidad 3: 6 hojas, entrenamiento 0.89, validación 0.89
Profundidad 10: 20 hojas, entrenamiento 1.00, validación 0.85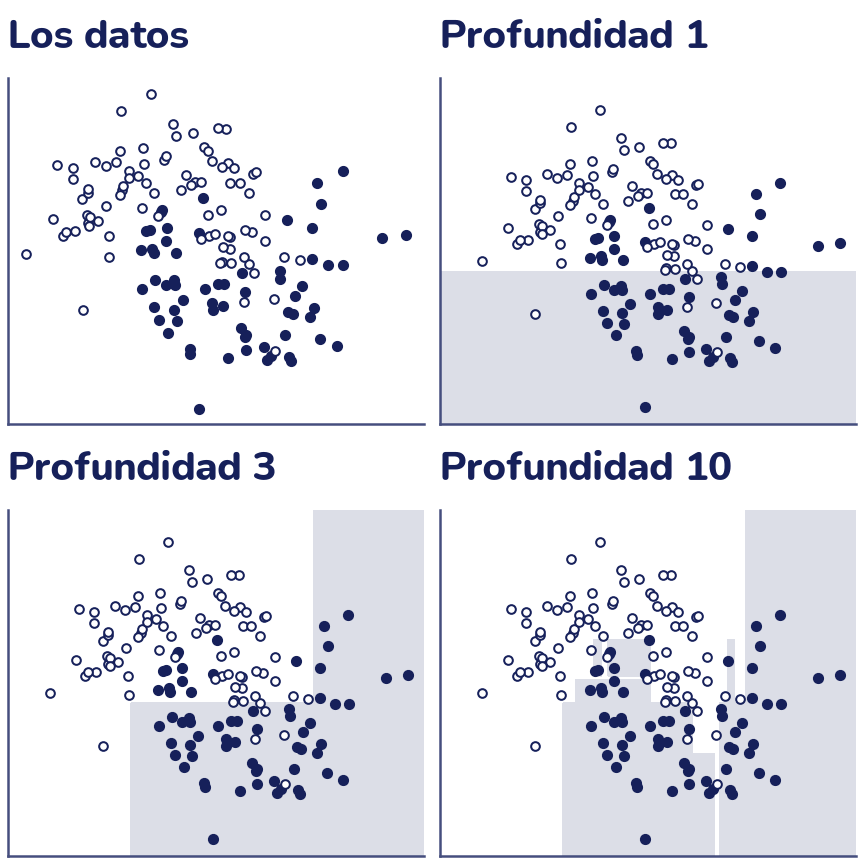
Las fronteras de un árbol son siempre escaleras: líneas verticales y horizontales. Con profundidad 1 hay un solo corte y el modelo es demasiado simple (subajuste). Con profundidad 10, el árbol acierta todos los puntos de entrenamiento, pero lo logra dibujando rectángulos chiquitos alrededor de puntos que están del lado «equivocado» por el ruido: memoriza (sobreajuste), y en validación le va peor que con profundidad 3. Es la «U» del tema 7, otra vez.
Los dos frenos más usados son:
max_depth: el número máximo de preguntas en cualquier camino.min_samples_leaf: cuántos ejemplos debe tener cada hoja como mínimo. Con 10, el árbol no puede crear una hoja para un solo pasajero raro.
Busquemos los dos con validación cruzada en el Titanic. Como el árbol está dentro del pipeline, en cada pliegue la imputación se calcula solo con la parte de entrenamiento, sin fuga de datos.
from sklearn.model_selection import cross_val_score

print("max_depth   entrenamiento   validación cruzada")
for prof in [1, 2, 3, 4, 6, 8, None]:
    modelo = con_preparacion(DecisionTreeClassifier(max_depth=prof,
                                                    random_state=0))
    vc = cross_val_score(modelo, X_ent, y_ent, cv=5).mean()
    ent = modelo.fit(X_ent, y_ent).score(X_ent, y_ent)
    print(f"{str(prof):>9s}   {ent:13.3f}   {vc:18.3f}")

print("\nmin_samples_leaf   entrenamiento   validación cruzada")
for hoja in [1, 5, 10, 20]:
    modelo = con_preparacion(DecisionTreeClassifier(
        min_samples_leaf=hoja, random_state=0))
    vc = cross_val_score(modelo, X_ent, y_ent, cv=5).mean()
    ent = modelo.fit(X_ent, y_ent).score(X_ent, y_ent)
    print(f"{hoja:16d}   {ent:13.3f}   {vc:18.3f}")
max_depth entrenamiento validación cruzada
1 0.792 0.792
2 0.801 0.789
3 0.843 0.819
4 0.847 0.819
6 0.874 0.811
8 0.910 0.793
None 0.982 0.771
min_samples_leaf entrenamiento validación cruzada
1 0.982 0.771
5 0.885 0.823
10 0.870 0.805
20 0.828 0.804Sin límites (None), el árbol acierta casi todo en entrenamiento y es de los peores en validación. Lo mejor está en un punto medio: profundidad 3 o 4, o un mínimo de 5 pasajeros por hoja.
La varianza de un árbol
Un árbol profundo tiene otro problema, más escondido: es inestable. Si cambias un poco los datos de entrenamiento, las primeras preguntas pueden cambiar, y con ellas todas las de abajo. Para verlo, entrenemos cinco árboles sin límite de profundidad, cada uno con una muestra bootstrap de los pasajeros: una muestra del mismo tamaño, sacada con reposición (un pasajero puede salir dos o tres veces y otro ninguna).
rng = np.random.default_rng(0)
# Un pliegue de validación dentro del entrenamiento
A_e, A_v, y_e, y_v = train_test_split(A, y_arr, test_size=0.25,
                                      stratify=y_arr, random_state=1)
predicciones = []
for i in range(5):
    muestra = rng.integers(0, len(A_e), size=len(A_e))  # bootstrap
    a = DecisionTreeClassifier(random_state=0)
    a.fit(A_e[muestra], y_e[muestra])
    predicciones.append(a.predict(A_v))
    acierto = np.mean(predicciones[-1] == y_v)
    print(f"Árbol {i + 1}: ve {len(np.unique(muestra))} de"
          f" {len(A_e)} pasajeros, validación {acierto:.3f}")

predicciones = np.array(predicciones)
# Un pasajero tiene desacuerdo si no todos los árboles dicen lo mismo
distintos = predicciones.min(axis=0) != predicciones.max(axis=0)
desacuerdo = np.mean(distintos)
print(f"Los 5 árboles no coinciden en el {desacuerdo:.0%}"
      " de los pasajeros de validación")
votos = (predicciones.mean(axis=0) > 0.5).astype(int)
print(f"Votación de los 5 árboles: validación {np.mean(votos == y_v):.3f}")
Árbol 1: ve 316 de 501 pasajeros, validación 0.743
Árbol 2: ve 308 de 501 pasajeros, validación 0.743
Árbol 3: ve 316 de 501 pasajeros, validación 0.766
Árbol 4: ve 313 de 501 pasajeros, validación 0.784
Árbol 5: ve 314 de 501 pasajeros, validación 0.754
Los 5 árboles no coinciden en el 37% de los pasajeros de validación
Votación de los 5 árboles: validación 0.778Cada árbol ve cerca de dos tercios de los pasajeros distintos (el resto de su muestra son repetidos), y aunque los cinco aciertan parecido, no se equivocan en los mismos pasajeros: discrepan en más de un tercio de los casos. Esa es la varianza del modelo: el resultado depende mucho de qué datos le tocaron. Y aparece la idea clave de los ensambles: si cada árbol se equivoca en lugares distintos, al votar muchos de ellos los errores se compensan en parte. Con solo cinco árboles, la votación (0,778) ya acierta más que el promedio de los cinco por separado (0,758).
Bagging y random forest
Bagging (de bootstrap aggregating) es justo lo que hicimos: entrenar muchos árboles, cada uno con su muestra bootstrap, y predecir por votación (o promediando sus probabilidades). Cada árbol se deja crecer profundo, con poco sesgo y mucha varianza; el promedio conserva el poco sesgo y baja la varianza.
El random forest (bosque aleatorio) agrega una vuelta más: en cada corte, cada árbol solo puede elegir entre un subconjunto de variables sorteado al azar (en clasificación, por defecto, la raíz cuadrada del número de variables). Así los árboles se parecen menos entre sí. Si una variable domina, como el sexo, en el bagging casi todos los árboles empiezan con la misma pregunta y se equivocan parecido; en el bosque, algunos árboles se ven obligados a empezar por otra, y el promedio gana.
Otra ventaja del bootstrap: cada árbol deja afuera cerca de un tercio de los pasajeros. Esos pasajeros «fuera de la bolsa» (out of bag, OOB) sirven como validación gratis: cada pasajero se predice solo con los árboles que no lo vieron. Es el error OOB.
from sklearn.ensemble import BaggingClassifier, RandomForestClassifier

bagging = con_preparacion(BaggingClassifier(
    DecisionTreeClassifier(), n_estimators=200, random_state=0))
bosque = con_preparacion(RandomForestClassifier(
    n_estimators=200, oob_score=True, random_state=0))

for nombre, modelo in [("Bagging", bagging), ("Random forest", bosque)]:
    vc = cross_val_score(modelo, X_ent, y_ent, cv=5).mean()
    print(f"{nombre:14s} validación cruzada = {vc:.3f}")

bosque.fit(X_ent, y_ent)
print(f"Random forest, exactitud OOB: {bosque['modelo'].oob_score_:.3f}")
Bagging validación cruzada = 0.814
Random forest validación cruzada = 0.813
Random forest, exactitud OOB: 0.808Los dos ensambles superan con claridad al árbol sin límites (0,771) y quedan cerca del mejor árbol podado, sin que hayamos elegido ninguna profundidad. La exactitud OOB se parece a la de la validación cruzada, y salió de un solo entrenamiento.
En el plano de las lunas, el bosque se ve así. A cada árbol le pedimos al menos 5 puntos por hoja, y sombreamos la probabilidad de la clase 1 en cuatro bandas: más oscuro, más árboles votan por ella.
bosque2 = RandomForestClassifier(n_estimators=200, min_samples_leaf=5,
                                 random_state=0)
bosque2.fit(X2_ent, y2_ent)
prob = bosque2.predict_proba(rejilla)[:, 1].reshape(xx.shape)

fig, eje = plt.subplots()
for desde in [0.5, 0.625, 0.75, 0.875]:
    eje.contourf(xx, yy, prob, levels=[desde, 1.01], colors=["C0"],
                 alpha=0.08)
eje.contour(xx, yy, prob, levels=[0.5], colors=["C1"], linewidths=2.5)
dibujar_puntos(eje)
eje.set_title("Bosque de 200 árboles: frontera y votos")
plt.show()

print(f"Bosque: entrenamiento {bosque2.score(X2_ent, y2_ent):.2f},"
      f" validación {bosque2.score(X2_val, y2_val):.2f}")
Bosque: entrenamiento 0.95, validación 0.90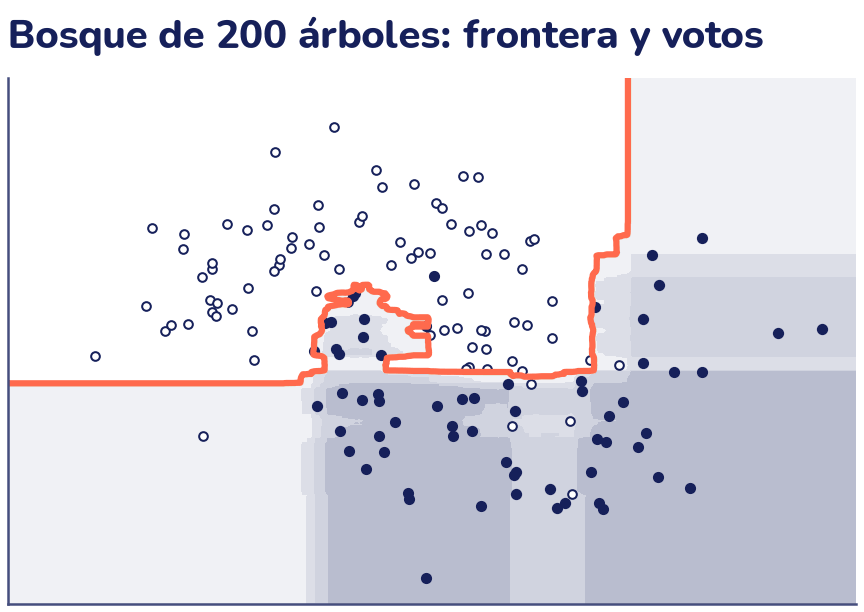
La frontera todavía tiene escalones (cada árbol corta en rectángulos), pero ya no encierra puntos sueltos como el árbol de profundidad 10, y en validación acierta 0,90, más que cualquiera de los árboles solos de la figura anterior. Las bandas muestran algo que un árbol solo no da: dónde el modelo está seguro (bandas oscuras, casi todos los árboles de acuerdo) y dónde duda (bandas claras, cerca de la frontera). Es lo que viste en la actividad al subir el número de árboles.
Boosting: árboles que corrigen errores
El bagging entrena los árboles en paralelo, cada uno por su cuenta. El boosting los entrena en cadena: cada árbol nuevo se dedica a corregir lo que los anteriores todavía hacen mal. Los árboles de boosting son chiquitos (profundidad 2 o 3): ninguno sabe mucho, pero la suma sí.
La idea se ve más clara en regresión. Tomemos unos datos sintéticos: una onda con ruido. El gradient boosting con error cuadrático hace esto:
- Empieza prediciendo el promedio de y para todos.
- Calcula los residuos, y menos lo predicho: lo que falta corregir.
- Entrena un árbol chico para predecir esos residuos.
- Suma a la predicción lo que dice ese árbol, multiplicado por una tasa de aprendizaje pequeña.
- Vuelve al paso 2.
¿Por qué «gradient»? Con el MSE, el residuo es (salvo un factor 2) el gradiente de la pérdida con el signo cambiado respecto de cada predicción. Cada árbol da un paso de descenso de gradiente, como en el tema 6, pero en lugar de mover dos parámetros mueve directamente las predicciones.
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(0)
x = np.sort(rng.uniform(0, 6, 80))
onda = np.sin(x) + rng.normal(0, 0.25, 80)   # datos sintéticos
Xx = x.reshape(-1, 1)

tasa = 0.1
pred = np.full(len(x), onda.mean())   # paso 1: el promedio
historia = {}                         # predicción tras algunos árboles
errores = []
for m in range(1, 101):
    residuos = onda - pred            # paso 2: lo que falta
    a = DecisionTreeRegressor(max_depth=2, random_state=0)
    a.fit(Xx, residuos)               # paso 3: aprender los residuos
    pred = pred + tasa * a.predict(Xx)  # paso 4: corregir un poco
    errores.append(np.mean((onda - pred) ** 2))
    if m in (1, 5, 50):
        historia[m] = pred.copy()

for m in (1, 5, 50, 100):
    print(f"Después de {m:3d} árboles: MSE = {errores[m - 1]:.3f}")

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
for eje, m in zip([ejes[0, 0], ejes[0, 1], ejes[1, 0]], (1, 5, 50)):
    eje.vlines(x, historia[m], onda, color="C2", linewidth=0.8)
    eje.scatter(x, onda, s=8, color="C0")
    eje.plot(x, historia[m], color="C1" if m == 50 else "C0")
    eje.set_title(f"{m} {'árbol' if m == 1 else 'árboles'}")
    eje.set_xticks([])
    eje.set_yticks([])
ejes[1, 1].plot(range(1, 101), errores, color="C0")
ejes[1, 1].set_title("MSE")
ejes[1, 1].set_xlabel("Árboles")
plt.show()
Después de 1 árboles: MSE = 0.448
Después de 5 árboles: MSE = 0.234
Después de 50 árboles: MSE = 0.026
Después de 100 árboles: MSE = 0.017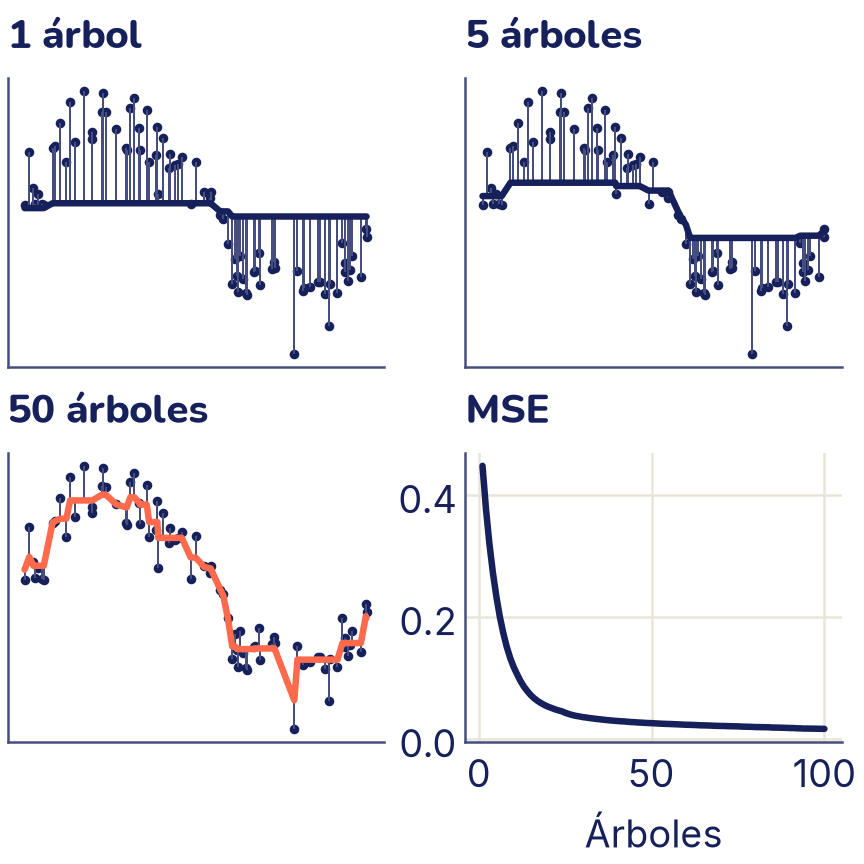
Con un árbol, la predicción apenas se movió del promedio, porque la tasa de 0,1 solo deja pasar una décima parte de cada corrección. A los 5 árboles empieza a aparecer la onda, y a los 50 los residuos son cortos. GradientBoostingRegressor de scikit-learn hace exactamente este bucle:
from sklearn.ensemble import GradientBoostingRegressor

gb = GradientBoostingRegressor(n_estimators=100, learning_rate=0.1,
                               max_depth=2, random_state=0)
gb.fit(Xx, onda)
diferencia = np.abs(gb.predict(Xx) - pred).max()
print(f"MSE de scikit-learn: {np.mean((onda - gb.predict(Xx)) ** 2):.3f}")
print(f"Mayor diferencia con nuestro bucle: {diferencia:.1e}")
MSE de scikit-learn: 0.017
Mayor diferencia con nuestro bucle: 2.2e-16Dos hiperparámetros van de la mano:
learning_rate: cuánto de cada corrección se suma. Más chica, más árboles hacen falta, pero el resultado suele generalizar mejor.n_estimators: cuántos árboles. A diferencia del bosque, en boosting demasiados árboles sobreajustan: después de corregir los errores de verdad, los árboles nuevos empiezan a perseguir el ruido.
En clasificación la idea es la misma, con la entropía cruzada del tema 8 como pérdida: los árboles corrigen el log-odds de cada pasajero.
¿Cuántos árboles?
Comparemos el bosque y el boosting en el Titanic según el número de árboles, con validación cruzada de 5 pliegues. Para el boosting no hace falta reentrenar: staged_predict da las predicciones después de cada árbol.
from sklearn.model_selection import StratifiedKFold
from sklearn.ensemble import GradientBoostingClassifier

cantidades = [1, 2, 5, 10, 20, 50, 100, 200, 400, 1000]
pliegues = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
acierto_bosque = np.zeros(len(cantidades))
acierto_boost = np.zeros(len(cantidades))
for ent, val in pliegues.split(A, y_arr):
    for i, n in enumerate(cantidades):
        rf = RandomForestClassifier(n_estimators=n, random_state=0)
        rf.fit(A[ent], y_arr[ent])
        acierto_bosque[i] += rf.score(A[val], y_arr[val]) / 5
    gbc = GradientBoostingClassifier(n_estimators=1000, learning_rate=0.1,
                                     max_depth=3, random_state=0)
    gbc.fit(A[ent], y_arr[ent])
    etapas = list(gbc.staged_predict(A[val]))  # tras cada árbol
    for i, n in enumerate(cantidades):
        acierto_boost[i] += np.mean(etapas[n - 1] == y_arr[val]) / 5

for n, b, g in zip(cantidades, acierto_bosque, acierto_boost):
    print(f"{n:4d} árboles:  bosque {b:.3f}   boosting {g:.3f}")

plt.plot(cantidades, acierto_bosque, marker="o", color="C1",
         label="Random forest")
plt.plot(cantidades, acierto_boost, marker="o", color="C2",
         label="Gradient boosting")
plt.xscale("log")
plt.xlabel("Número de árboles (escala logarítmica)")
plt.ylabel("Exactitud (validación)")
plt.title("Más árboles: el bosque se estabiliza")
plt.legend()
plt.show()
1 árboles: bosque 0.751 boosting 0.617
2 árboles: bosque 0.753 boosting 0.636
5 árboles: bosque 0.787 boosting 0.808
10 árboles: bosque 0.789 boosting 0.822
20 árboles: bosque 0.799 boosting 0.816
50 árboles: bosque 0.807 boosting 0.813
100 árboles: bosque 0.811 boosting 0.811
200 árboles: bosque 0.807 boosting 0.819
400 árboles: bosque 0.805 boosting 0.814
1000 árboles: bosque 0.801 boosting 0.792
Lectura:
- El bosque mejora al agregar árboles y después se aplana alrededor de 0,80 y 0,81 (las pequeñas subidas y bajadas son ruido de la validación): agregar árboles no lo hace sobreajustar, solo lo hace más lento. Por eso el número de árboles de un bosque no se «afina»: se pone suficientemente grande.
- El boosting con 1 o 2 árboles acierta solo 0,617: es lo que se logra diciendo «murió» para todos, porque con tasa 0,1 las primeras correcciones todavía no alcanzan para cambiar ninguna predicción. Después mejora muy rápido (con 10 árboles ya llega a 0,822, lo más alto) y con cientos de árboles empeora (0,792 con 1000): empieza a memorizar el ruido. Su número de árboles sí se elige con validación (o con
early_stopping, que lo corta solo cuando la validación deja de mejorar).
HistGradientBoosting, XGBoost y LightGBM
Con miles o millones de filas, GradientBoostingClassifier se vuelve lento. HistGradientBoostingClassifier es una versión moderna de scikit-learn: agrupa cada variable en hasta 255 intervalos (un histograma) y busca los cortes solo entre esos intervalos, lo que lo hace mucho más rápido. Además acepta valores faltantes sin imputar y, por defecto, se detiene solo cuando la validación deja de mejorar si hay más de 10 000 filas.
Fuera de scikit-learn existen XGBoost y LightGBM, dos librerías de boosting muy usadas en la industria para datos en tablas, con la misma interfaz fit y predict. En Colab, XGBoost suele venir instalado (from xgboost import XGBClassifier); la idea es la misma que acabas de programar.
Comparar los modelos
Pongamos lado a lado los cuatro modelos del tema, cada uno dentro del pipeline, con validación cruzada sobre el conjunto de entrenamiento.
from sklearn.ensemble import HistGradientBoostingClassifier

modelos = {
    "Árbol (profundidad 4)": DecisionTreeClassifier(max_depth=4,
                                                    random_state=0),
    "Bagging": BaggingClassifier(DecisionTreeClassifier(),
                                 n_estimators=200, random_state=0),
    "Random forest": RandomForestClassifier(n_estimators=200,
                                            min_samples_leaf=3,
                                            random_state=0),
    "HistGradientBoosting": HistGradientBoostingClassifier(
        max_depth=3, learning_rate=0.05, random_state=0),
}
for nombre, modelo in modelos.items():
    vc = cross_val_score(con_preparacion(modelo), X_ent, y_ent, cv=5)
    print(f"{nombre:22s} {vc.mean():.3f} ± {vc.std():.3f}")
Árbol (profundidad 4) 0.819 ± 0.020
Bagging 0.814 ± 0.025
Random forest 0.819 ± 0.024
HistGradientBoosting 0.820 ± 0.020Las diferencias son chicas comparadas con cuánto varía la exactitud entre pliegues (el ± es la desviación estándar de los 5 pliegues). Con 668 pasajeros y pocas variables, un árbol bien podado queda casi empatado con los ensambles; en tablas más grandes y con más variables, los ensambles, y sobre todo el boosting, suelen sacar una ventaja clara. Elegimos el random forest, que además es el más estable ante cambios en los datos, y lo medimos una sola vez con el conjunto de prueba:
final = con_preparacion(modelos["Random forest"]).fit(X_ent, y_ent)
print(f"Exactitud en la prueba: {final.score(X_prueba, y_prueba):.3f}")
Exactitud en la prueba: 0.830Es parecida a la de la validación cruzada; con solo 223 pasajeros de prueba, un par de puntos arriba o abajo es azar. Ese número es el que se reporta: ya no se toca el modelo después de verlo.
¿Qué variables importan?
Un bosque de 200 árboles ya no se puede leer pregunta por pregunta. Para saber en qué se apoya se usa la importancia por permutación: se toma una columna del conjunto de prueba, se desordenan sus valores al azar (así esa columna ya no dice nada de cada pasajero) y se mide cuánto baja la exactitud. Si baja mucho, el modelo dependía de esa variable; si no baja, la ignoraba. Como trabaja con el pipeline completo, mide las columnas originales, antes del one-hot.
from sklearn.inspection import permutation_importance

imp = permutation_importance(final, X_prueba, y_prueba, n_repeats=20,
                             random_state=0)
orden = np.argsort(imp.importances_mean)
for j in orden[::-1]:
    print(f"{X.columns[j]:16s} {imp.importances_mean[j]:+.3f}")

colores = ["C1" if j == orden[-1] else "C0" for j in orden]
plt.barh(X.columns[orden], imp.importances_mean[orden], color=colores)
plt.xlabel("Exactitud que se pierde")
plt.title("Importancia")
plt.show()
sexo +0.172
clase +0.070
edad +0.057
tarifa +0.034
puerto +0.030
hermanos_pareja +0.009
padres_hijos -0.001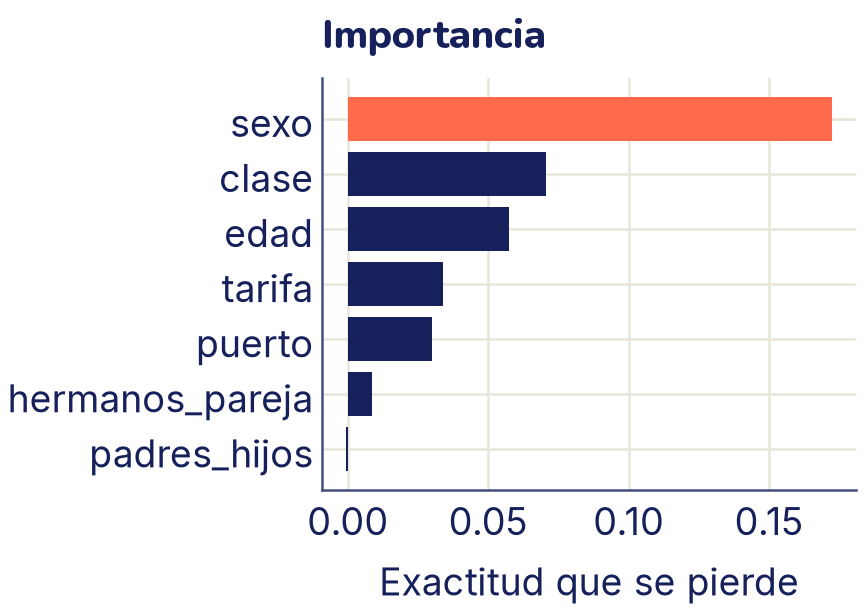
El sexo es, de lejos, la variable de la que más depende el modelo; después vienen la clase y la edad. Coincide con lo que mostró el árbol de profundidad 2.
Los árboles de scikit-learn también traen feature_importances_, una importancia que suma cuánto bajó el Gini en los cortes de cada variable. Es gratis, pero tiene un sesgo: favorece a las variables con muchos valores distintos (como la tarifa o la edad), que ofrecen muchos umbrales para cortar, aunque sea ruido. La importancia por permutación, medida en datos que el modelo no vio, no tiene ese problema; lo vas a comprobar en los ejercicios. Y una advertencia de siempre: una variable importante ayuda a predecir; eso no prueba que cause el resultado.
Lo que aprendiste y lo que sigue
- Un árbol de decisión predice con preguntas de sí o no encadenadas; divide el espacio en cajas con fronteras en escalera.
- Cada corte se elige de forma voraz: el de mayor ganancia, la caída de la impureza de Gini (o de la entropía) ponderada por el tamaño de cada lado.
- Un árbol sin límites memoriza: se frena con
max_depthymin_samples_leaf, elegidos con validación cruzada. A los árboles no les importa la escala de las variables. - Un árbol profundo tiene mucha varianza. El bagging promedia árboles entrenados con muestras bootstrap, y el random forest además sortea las variables en cada corte; los dos traen el error OOB gratis.
- El boosting encadena árboles chicos que corrigen los residuos de los anteriores, como un descenso de gradiente sobre las predicciones; la tasa de aprendizaje y el número de árboles se eligen juntos.
- La importancia por permutación dice de qué variables depende un modelo, medida en datos que no vio.
En el tema 12 vas a ver otro modelo clásico, las máquinas de vectores de soporte, que separan las clases con el margen más ancho posible en lugar de con preguntas.