La pregunta
En el tema 4 exploraste la lista de pasajeros del Titanic: quién viajaba en qué clase, cuántos sobrevivieron, a quién le falta la edad. Ahora queremos ir un paso más allá y entrenar un modelo que, a partir de los datos de un pasajero, prediga si sobrevivió.
Ya conoces modelos que sirven para eso, como los vecinos cercanos y la regresión logística del tema 8. Pero si intentas darle la tabla tal cual a fit, no funciona: a 177 pasajeros les falta la edad, el sexo está escrito como texto ("male", "female") y la tarifa va de 0 a más de 500 mientras que el número de hermanos va de 0 a 8. Antes de entrenar hay que preparar los datos, y en los proyectos reales eso suele llevar más tiempo que elegir el modelo.
Hay una segunda dificultad, más traicionera: es muy fácil preparar los datos de una forma que hace trampa sin que te des cuenta, y que te muestra un modelo mucho mejor de lo que es. A eso se le llama fuga de datos, y aprender a evitarla es lo más importante de este tema.
En este tema vas a:
- imputar valores faltantes con la media o la mediana, y justificar cuál elegir;
- convertir variables de texto en números con one-hot, y escalar las numéricas (estandarizar y normalizar);
- reconocer la fuga de datos y evitarla con un
Pipeliney unColumnTransformer; - buscar hiperparámetros con
GridSearchCVyRandomizedSearchCV; - crear variables nuevas y medir si de verdad ayudan.
Necesitas lo del tema 4 (pandas), el puntaje z del tema 5, la división en entrenamiento y prueba y la validación cruzada del tema 7, los vecinos cercanos y la regresión logística del tema 8, y la exactitud y las métricas del tema 9.
Actividad: la escala importa
Los vecinos cercanos deciden por distancia: el ejemplo nuevo se parece a los que tiene más cerca. Pero ¿cerca en qué unidades? Aquí hay 40 personas inventadas (datos sintéticos) con dos variables: su ingreso mensual en bolivianos y su edad en años. El punto coral es una persona nueva, y los anillos marcan sus 5 vecinos más cercanos.
La escala importa
Este es el estado inicial, sin estandarizar. Con JavaScript activado puedes estandarizar y mover a la persona nueva.
Con el foco en la persona nueva, las flechas izquierda y derecha cambian el ingreso y las flechas arriba y abajo cambian la edad; con Mayúsculas, el cambio es más grande.
distancia = √(Δingreso² + Δedad²)
| Vecino | Ingreso (Bs) | Edad | Distancia |
|---|---|---|---|
| 1 | 6 050 | 28 | 50 |
| 2 | 5 850 | 49 | 152 |
| 3 | 5 800 | 33 | 200 |
| 4 | 5 350 | 35 | 650 |
| 5 | 6 750 | 35 | 750 |
Persona nueva: 6 000 Bs, 24 años
Los vecinos tienen entre 5 350 y 6 750 Bs y entre 28 y 49 años.
Sin estandarizar, 1 boliviano de diferencia pesa lo mismo que 1 año. Activa «Estandarizar» y mira qué pasa con los vecinos.
Prueba esto, en orden:
- Sin estandarizar, mira la lista de vecinos. ¿En qué se parecen entre sí? ¿Y en qué no se parecen nada?
- Fíjate en la forma de la zona sombreada alrededor del punto coral. ¿Por qué es una franja tan angosta y alta?
- Activa «Estandarizar». La nube casi no se mueve, pero los ejes cambian de unidades. ¿Qué pasa con los vecinos y con la zona?
- Mueve el punto coral (tocando el gráfico o con las flechas del teclado) a una persona de 60 años y compara los vecinos con y sin estandarizar.
Sin estandarizar, una diferencia de 1000 bolivianos pesa lo mismo que una diferencia de 1000 años. Como las edades solo varían unas decenas, la edad casi no cuenta y los vecinos son simplemente las personas con ingreso parecido. Sin escalar, la variable con números grandes manda. Al estandarizar, cada variable se mide en desviaciones estándar y las dos pesan parecido.
Los datos tal como llegan
Cargamos el Titanic como en el tema 4 y miramos unas filas:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

titanic = sns.load_dataset("titanic")
print(titanic.shape)
print(titanic[["survived", "pclass", "sex", "age", "fare",
               "embarked", "deck"]].head())
(891, 15)
survived pclass sex age fare embarked deck
0 0 3 male 22.0 7.2500 S NaN
1 1 1 female 38.0 71.2833 C C
2 1 3 female 26.0 7.9250 S NaN
3 1 1 female 35.0 53.1000 S C
4 0 3 male 35.0 8.0500 S NaNCada fila es un pasajero. survived es la respuesta (1 si sobrevivió), pclass la clase del pasaje (1, 2 o 3), age la edad, sibsp cuántos hermanos o pareja viajaban con él, parch cuántos padres o hijos, fare la tarifa que pagó, embarked el puerto donde subió (S, C o Q) y deck la cubierta de su camarote.
El primer paso de cualquier preparación es saber qué falta y dónde. Un mapa de faltantes pinta de oscuro cada casilla vacía: una fila de píxeles por pasajero y una columna por variable.
from matplotlib.colors import LinearSegmentedColormap

cols = ["survived", "pclass", "sex", "age", "sibsp", "parch",
        "fare", "embarked", "deck"]
faltan = titanic[cols].isna()
print((faltan.mean() * 100).round(1))

blanco_tinta = LinearSegmentedColormap.from_list("bt", ["white", "C0"])
plt.imshow(faltan, aspect="auto", cmap=blanco_tinta,
           interpolation="nearest")
plt.xticks(range(len(cols)), cols, rotation=90)
plt.grid(False)                       # sin rejilla encima del mapa
plt.ylabel("Pasajero (fila)")
plt.title("Casillas vacías (oscuras)")
plt.show()
survived 0.0
pclass 0.0
sex 0.0
age 19.9
sibsp 0.0
parch 0.0
fare 0.0
embarked 0.2
deck 77.2
dtype: float64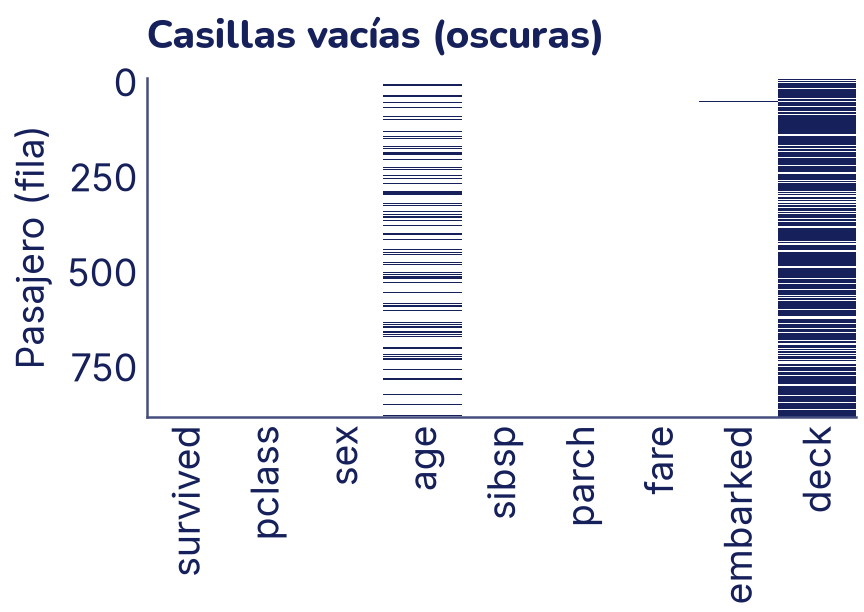
Tres columnas tienen huecos: a deck le falta el 77 % (casi todo), a age el 20 % y a embarked solo dos pasajeros. Con deck no hay mucho que rescatar, así que la dejamos fuera. Las otras dos las vamos a rellenar.
El dataset de seaborn trae además columnas que son copias o resúmenes de otras: class repite pclass, embark_town repite embarked, who y adult_male salen de la edad y el sexo, y alive es survived escrito con palabras ("yes" o "no"). Esa última es peligrosa: si la usaras como entrada, el modelo acertaría siempre, porque le estarías dando la respuesta. Es la forma más burda de fuga de datos, y la vas a cazar en los ejercicios. Nos quedamos con siete columnas:
columnas = ["pclass", "sex", "age", "sibsp", "parch", "fare",
            "embarked"]
X = titanic[columnas]
y = titanic["survived"]
print(X.shape, "  sobrevivió:", round(y.mean() * 100, 1), "%")
(891, 7) sobrevivió: 38.4 %Primero, dividir
Antes de tocar un solo dato, separamos el conjunto de prueba, como en el tema 7. La prueba hace de «examen final»: representa a los pasajeros que el modelo nunca vio. Todo lo que aprendamos (cuál es la edad típica, cuánto varía la tarifa, qué modelo conviene) lo vamos a aprender solo del entrenamiento.
from sklearn.model_selection import train_test_split

# stratify=y: la misma proporción de sobrevivientes en las dos partes
X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=0)
print("Entrenamiento:", X_ent.shape, "  prueba:", X_prueba.shape)
print("Edades faltantes:", X_ent["age"].isna().sum(), "y",
      X_prueba["age"].isna().sum())
Entrenamiento: (668, 7) prueba: (223, 7)
Edades faltantes: 136 y 41Esta regla, dividir primero y preparar después, parece un detalle. Más abajo vas a ver con números por qué no lo es.
Valores faltantes
Un dato puede faltar por razones muy distintas, y la razón importa:
- Falta al azar: se perdió una hoja, alguien se olvidó de anotar. Que falte no dice nada del pasajero.
- Falta por algo que sí vemos: por ejemplo, si a los de tercera clase se les anotó la edad con menos cuidado. Que falte depende de otra columna.
- Falta por el propio valor: por ejemplo, si las personas con ingresos muy altos prefieren no decir su ingreso. Es el caso más difícil, porque los que faltan son distintos de los que están.
Hay dos salidas. Borrar las filas incompletas (dropna, como en el tema 4) es simple, pero aquí tiraría el 20 % de los pasajeros, y cuando llegue un pasajero nuevo sin edad el modelo no sabría qué hacer con él. Imputar es rellenar el hueco con un valor razonable, casi siempre la media o la mediana de la columna. ¿Cuál de las dos?
for col in ["age", "fare"]:
    print(f"{col}:  media = {X_ent[col].mean():5.2f}"
          f"   mediana = {X_ent[col].median():5.2f}"
          f"   máximo = {X_ent[col].max():6.2f}")
age: media = 29.80 mediana = 29.00 máximo = 80.00
fare: media = 33.27 mediana = 14.45 máximo = 512.33En la edad, la media y la mediana casi coinciden: la distribución es bastante simétrica y cualquiera de las dos sirve. En la tarifa no: unos pocos pasajes carísimos (más de 500) tiran la media hacia arriba, hasta más del doble de la mediana. La media de la tarifa no describe a un pasajero típico; la mediana, sí. Por eso la regla práctica es: mediana si la columna está sesgada o tiene atípicos, media si es simétrica. La mediana casi nunca sale muy mal, así que es la opción por defecto más segura.
Para las columnas de texto no hay media ni mediana: se rellena con el valor más frecuente (la moda).
scikit-learn lo hace con SimpleImputer. Funciona como un modelo: fit aprende el valor de relleno (aquí, la mediana del entrenamiento) y transform lo aplica, a los datos que sea:
from sklearn.impute import SimpleImputer

imputar_edad = SimpleImputer(strategy="median")
imputar_edad.fit(X_ent[["age"]])      # aprende con el entrenamiento
print("Mediana aprendida:", imputar_edad.statistics_)

edad_ent = imputar_edad.transform(X_ent[["age"]])
edad_prueba = imputar_edad.transform(X_prueba[["age"]])
print("Faltantes después:", np.isnan(edad_ent).sum(), "y",
      np.isnan(edad_prueba).sum())

imputar_puerto = SimpleImputer(strategy="most_frequent")
imputar_puerto.fit(X_ent[["embarked"]])
print("Puerto más frecuente:", imputar_puerto.statistics_)
Mediana aprendida: [29.]
Faltantes después: 0 y 0
Puerto más frecuente: ['S']Fíjate en que la prueba se rellena con la mediana del entrenamiento, no con la suya. Es lo que va a pasar cuando el modelo esté en uso: llega un pasajero nuevo sin edad y lo único que conocemos es lo que aprendimos antes.
Imputar tiene un costo: 136 pasajeros del entrenamiento quedan con exactamente la misma edad, 29 años, y la columna se vuelve un poco más «picuda» de lo que era. Si sospechas que el hecho de que falte dice algo, puedes guardar esa información en una columna aparte con SimpleImputer(add_indicator=True), que agrega una columna con 1 donde el dato faltaba.
Variables categóricas: one-hot
Los modelos solo entienden números. ¿Cómo convertimos el puerto embarked, que vale S, C o Q? La idea ingenua es numerarlos: S = 0, C = 1, Q = 2. Pero así le estás diciendo al modelo que Q es «el doble» de C y que C está «entre» S y Q. Para los vecinos cercanos, Southampton quedaría más cerca de Cherburgo que de Queenstown solo por cómo los numeraste. Los puertos no tienen orden: son una variable nominal.
La solución es one-hot (uno caliente): una columna por cada valor posible, con un 1 en la que corresponde y 0 en las demás.
from sklearn.preprocessing import OneHotEncoder

puertos = pd.DataFrame({"embarked": ["S", "C", "Q", "S"]})
onehot = OneHotEncoder(sparse_output=False, handle_unknown="ignore")
onehot.fit(puertos)
print(onehot.get_feature_names_out())
print(onehot.transform(puertos))
# Un puerto que no apareció en el entrenamiento queda todo en cero
nuevo = pd.DataFrame({"embarked": ["X"]})
print(onehot.transform(nuevo))
['embarked_C' 'embarked_Q' 'embarked_S']
[[0. 0. 1.]
[1. 0. 0.]
[0. 1. 0.]
[0. 0. 1.]]
[[0. 0. 0.]]Ahora los tres puertos están a la misma distancia entre sí. handle_unknown="ignore" evita un error cuando, ya en uso, aparece un valor que no estaba en el entrenamiento.
¿Y la clase del pasaje, pclass? Ahí sí hay un orden: primera es «más» que segunda, y segunda más que tercera. Una variable así se llama ordinal, y muchas veces se puede dejar como número. Es lo que vamos a hacer. El sexo tiene dos valores; one-hot lo convierte en dos columnas que dicen lo mismo, y eso no le hace daño a ningún modelo de este tema.
Escalar: estandarizar y normalizar
La actividad mostró el problema: las distancias, y también el descenso de gradiente del tema 6, se dejan llevar por las columnas con números grandes. Hay dos formas comunes de poner todas las columnas en una escala parecida.
Estandarizar es lo que hiciste en el tema 5 con el puntaje z: restar la media y dividir por la desviación estándar. Cada columna queda con media 0 y desviación 1.
Normalizar (o escalar al rango) lleva el mínimo a 0 y el máximo a 1:
En scikit-learn son StandardScaler y MinMaxScaler, y funcionan igual que el imputador: fit aprende la media y la desviación (o el mínimo y el máximo) del entrenamiento, y transform las aplica.
from sklearn.preprocessing import StandardScaler, MinMaxScaler

# Primero rellenamos la edad; la tarifa no tiene faltantes
edad_tarifa = pd.DataFrame(
    {"edad": edad_ent[:, 0], "tarifa": X_ent["fare"].to_numpy()})

estandarizar = StandardScaler().fit(edad_tarifa)
print("Medias:", estandarizar.mean_.round(2))
print("Desviaciones:", estandarizar.scale_.round(2))
est = estandarizar.transform(edad_tarifa)

normalizar = MinMaxScaler().fit(edad_tarifa)
norm = normalizar.transform(edad_tarifa)
print("Estandarizadas: de", est.min(axis=0).round(2),
      "a", est.max(axis=0).round(2))
print("Normalizadas:   de", norm.min(axis=0).round(2),
      "a", norm.max(axis=0).round(2))

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8))
ejes[0, 0].hist(edad_tarifa["edad"], bins=30)
ejes[0, 0].set_title("Edad (años)")
ejes[0, 1].hist(edad_tarifa["tarifa"], bins=30)
ejes[0, 1].set_title("Tarifa")
ejes[1, 0].hist(est[:, 0], bins=30, color="C2")
ejes[1, 0].set_title("Edad (puntaje z)")
ejes[1, 1].hist(est[:, 1], bins=30, color="C2")
ejes[1, 1].set_title("Tarifa (z)")
plt.show()
Medias: [29.63 33.27]
Desviaciones: [12.91 53.43]
Estandarizadas: de [-2.26 -0.62] a [3.9 8.97]
Normalizadas: de [0. 0.] a [1. 1.]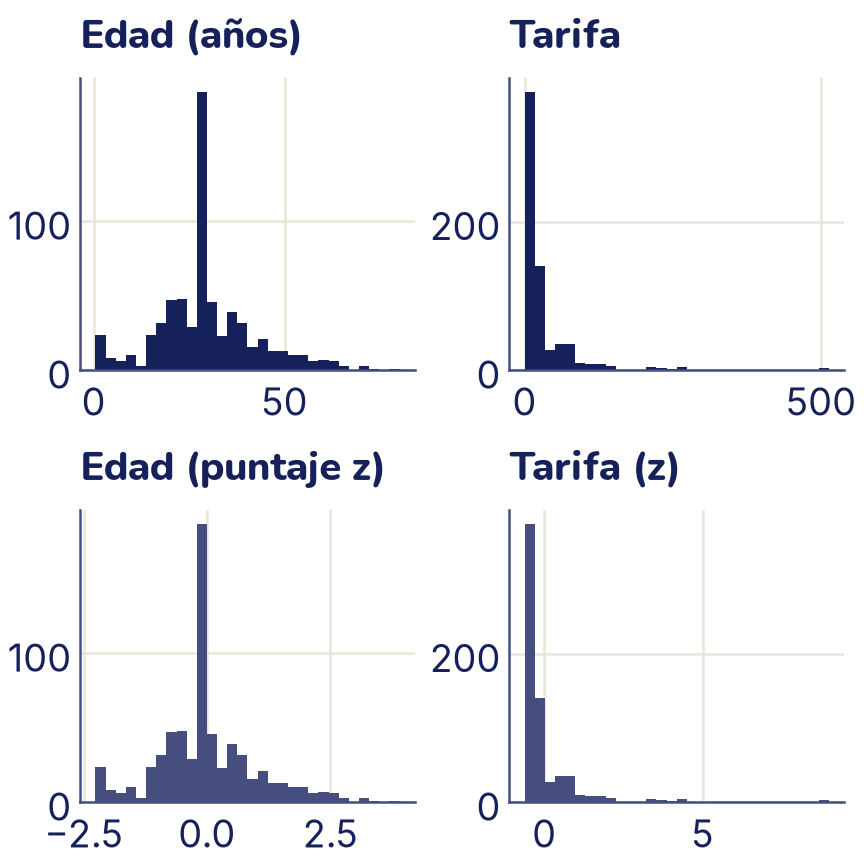
Compara la fila de arriba con la de abajo: las formas son idénticas. Escalar no cambia la distribución, solo las unidades del eje (es estirar y correr la regla). La tarifa estandarizada sigue teniendo su cola larga, con valores de casi 9 desviaciones sobre la media. Por eso la normalización al rango sufre con los atípicos: un solo pasaje de 512 se vuelve el 1, y casi todos los demás quedan apretados cerca de 0.
¿Cuál usar? La estandarización es la opción por defecto y es la que suponen la regresión logística regularizada y el descenso de gradiente. La normalización al rango sirve cuando necesitas valores entre 0 y 1 (por ejemplo, los píxeles de una imagen). Si hay atípicos fuertes, es mejor estandarizar. Y algunos modelos, como los árboles del tema 11, no necesitan escalar nada.
Fuga de datos
Hay fuga de datos cuando, al entrenar o preparar el modelo, se cuela información que en la vida real no vas a tener en el momento de predecir. La forma más común es usar los datos de prueba (o de validación) para preparar los datos. El modelo se evalúa con un examen cuyas preguntas ya vio de reojo, y el puntaje sale mejor de lo que es.
Mira qué pasa si imputamos y escalamos con todos los pasajeros, antes de dividir:
# Con fuga: las cuentas usan también a los pasajeros de prueba
print(f"Mediana de la edad:  todos = {X['age'].median()}"
      f"   solo entrenamiento = {X_ent['age'].median()}")
print(f"Media de la tarifa:  todos = {X['fare'].mean():.2f}"
      f"   solo entrenamiento = {X_ent['fare'].mean():.2f}")
Mediana de la edad: todos = 28.0 solo entrenamiento = 29.0
Media de la tarifa: todos = 32.20 solo entrenamiento = 33.27Las cifras cambian: si preparas con todos, la mediana con que rellenas y la media con que escalas ya «saben» algo de los pasajeros de prueba. Con 891 pasajeros y pasos tan simples como una mediana, el cambio es chico, y más abajo vas a ver que aquí el puntaje casi no se mueve. Pero el error de fondo es el mismo que puede arruinar un proyecto entero. Para verlo en grande, hagamos un experimento con datos sintéticos donde no hay nada que aprender.
Inventamos 200 ejemplos con 5000 columnas de números al azar y una respuesta, 0 o 1, también al azar. Ninguna columna tiene relación con la respuesta, así que ningún modelo honesto puede acertar más que tirando una moneda: alrededor del 50 %. Antes de entrenar, hacemos un paso de preparación muy común: quedarnos con las 20 columnas más relacionadas con la respuesta (SelectKBest). En una versión elegimos las columnas con los 200 ejemplos y después dividimos; en la otra, dividimos primero y elegimos solo con el entrenamiento. Además, generamos 1000 ejemplos nuevos para ver cómo le va de verdad a cada modelo.
from sklearn.feature_selection import SelectKBest
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(0)
X_azar = rng.normal(size=(200, 5000))     # 5000 columnas de ruido
y_azar = rng.integers(0, 2, size=200)     # respuestas al azar
X_nuevo = rng.normal(size=(1000, 5000))   # datos que llegan después
y_nuevo = rng.integers(0, 2, size=1000)

Xa_ent, Xa_prueba, ya_ent, ya_prueba = train_test_split(
    X_azar, y_azar, test_size=0.25, random_state=0)

resultados = {}
for nombre, Xs, ys in [("Con fuga", X_azar, y_azar),
                       ("Sin fuga", Xa_ent, ya_ent)]:
    # La única diferencia: con qué filas se eligen las 20 columnas
    elegir = SelectKBest(k=20).fit(Xs, ys)
    modelo = LogisticRegression().fit(elegir.transform(Xa_ent), ya_ent)
    resultados[nombre] = [
        modelo.score(elegir.transform(Xa_prueba), ya_prueba),
        modelo.score(elegir.transform(X_nuevo), y_nuevo)]
    print(f"{nombre}:  prueba = {resultados[nombre][0]:.2f}"
          f"   datos nuevos = {resultados[nombre][1]:.3f}")

alturas = resultados["Con fuga"] + resultados["Sin fuga"]
nombres = ["Prueba\ncon fuga", "Nuevos\ncon fuga",
           "Prueba\nsin fuga", "Nuevos\nsin fuga"]
# Coral solo para el número engañoso
barras = plt.bar(nombres, alturas, color=["C1", "C2", "C0", "C2"])
plt.bar_label(barras, fmt="%.2f")
plt.axhline(0.5, color="C2", linestyle="--", linewidth=1)
plt.ylim(0, 1)
plt.ylabel("Exactitud")
plt.title("La fuga engaña en la prueba")
plt.show()
Con fuga: prueba = 0.80 datos nuevos = 0.487
Sin fuga: prueba = 0.56 datos nuevos = 0.515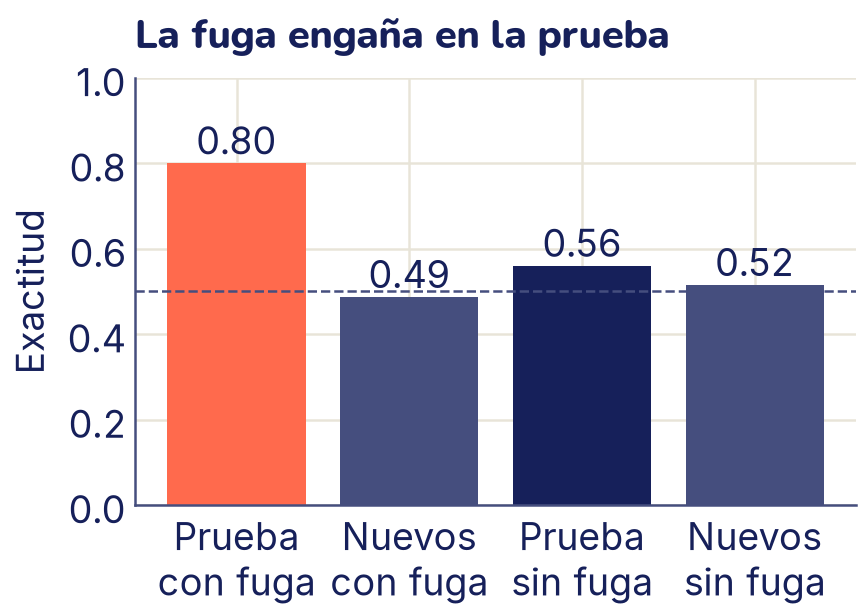
Con fuga, la prueba dice que el modelo acierta el 80 % de las veces con datos que son puro ruido. Es mentira: con los 1000 ejemplos nuevos acierta el 49 %, lo mismo que una moneda. Lo que pasó es que, entre 5000 columnas al azar, siempre hay algunas que por pura casualidad se parecen a la respuesta en esos 200 ejemplos, incluidos los 50 de prueba. Al elegirlas mirando también la prueba, elegimos justo las casualidades que hacen quedar bien al modelo en ese examen. Sin fuga, la prueba da un 56 %, cerca del azar, que es la verdad: no hay nada que aprender.
La lección general: todo paso que aprende algo de los datos (imputar, escalar, elegir columnas, codificar) es parte del modelo y se ajusta solo con el entrenamiento. Esto vale para la división en entrenamiento y prueba, y también para cada pliegue de la validación cruzada del tema 7. Hacerlo a mano en cada pliegue es tedioso y fácil de olvidar. Para eso existe el Pipeline.
Pipeline y ColumnTransformer
Un Pipeline (tubería) encadena pasos: cada uno le pasa su resultado al siguiente, y el último es el modelo. Lo importante es que se comporta como un solo modelo: cuando llamas a fit, ajusta cada paso solo con los datos que le das; cuando llamas a predict o score, aplica lo que aprendió. Así, la validación cruzada y la búsqueda de hiperparámetros reciben el pipeline completo y lo reentrenan entero en cada pliegue, sin fuga.
Nuestras columnas necesitan tratamientos distintos: las numéricas, imputar con la mediana y estandarizar; las de texto, imputar con la más frecuente y pasar a one-hot. Un ColumnTransformer aplica a cada grupo de columnas su propio tratamiento y junta los resultados en una sola tabla.
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.neighbors import KNeighborsClassifier

numericas = ["pclass", "age", "sibsp", "parch", "fare"]
categoricas = ["sex", "embarked"]

prep_numericas = Pipeline([
    ("imputar", SimpleImputer(strategy="median")),
    ("escalar", StandardScaler())])
prep_categoricas = Pipeline([
    ("imputar", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore"))])
preparar = ColumnTransformer([
    ("num", prep_numericas, numericas),
    ("cat", prep_categoricas, categoricas)])

pipe_knn = Pipeline([("preparar", preparar),
                     ("modelo", KNeighborsClassifier(n_neighbors=5))])
pipe_knn.fit(X_ent, y_ent)

print(pipe_knn.named_steps["preparar"].get_feature_names_out())
print("Forma lista para el modelo:",
      pipe_knn.named_steps["preparar"].transform(X_ent).shape)
['num__pclass' 'num__age' 'num__sibsp' 'num__parch' 'num__fare'
'cat__sex_female' 'cat__sex_male' 'cat__embarked_C' 'cat__embarked_Q'
'cat__embarked_S']
Forma lista para el modelo: (668, 10)Las 7 columnas originales se convirtieron en 10: las 5 numéricas (con su prefijo num__) y 5 de one-hot (dos para el sexo, tres para el puerto). Cada paso tiene un nombre, y con ese nombre se llega a sus piezas: named_steps["preparar"], o con doble guion bajo, preparar__num__escalar.
Ahora la validación cruzada del tema 7 recibe el pipeline completo. Comparemos los vecinos cercanos con la estandarización y sin ella; set_params cambia un paso por su nombre, y "passthrough" significa «no hacer nada».
from sklearn.base import clone
from sklearn.model_selection import StratifiedKFold, cross_val_score

pliegues = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)

for escala in [StandardScaler(), "passthrough"]:
    pipe = clone(pipe_knn).set_params(preparar__num__escalar=escala)
    puntajes = cross_val_score(pipe, X_ent, y_ent, cv=pliegues)
    print(f"Escalar = {str(escala):16}  exactitud = "
          f"{puntajes.mean():.3f} ± {puntajes.std():.3f}")
Escalar = StandardScaler() exactitud = 0.808 ± 0.023
Escalar = passthrough exactitud = 0.713 ± 0.026Es la actividad con datos reales: sin escalar, la tarifa (que llega a 512) domina las distancias y los vecinos se eligen casi solo por lo que pagaron. Escalando, la exactitud sube casi 10 puntos. clone hace una copia sin entrenar del pipeline, para no tocar el original.
¿Y la fuga del Titanic, la de imputar y escalar antes de dividir? Medimos lo mismo de dos formas: preparando una sola vez con todo el entrenamiento y después haciendo la validación cruzada (con fuga hacia cada pliegue de validación), o con el pipeline (sin fuga).
# Con fuga: se prepara una vez con todas las filas del entrenamiento
X_preparado = clone(preparar).fit_transform(X_ent)
con_fuga = cross_val_score(KNeighborsClassifier(n_neighbors=5),
                           X_preparado, y_ent, cv=pliegues)
sin_fuga = cross_val_score(pipe_knn, X_ent, y_ent, cv=pliegues)
print(f"Con fuga: {con_fuga.mean():.3f}"
      f"   sin fuga: {sin_fuga.mean():.3f}")
Con fuga: 0.807 sin fuga: 0.808Aquí la diferencia es mínima: una mediana o una media calculadas con 534 pasajeros o con 668 casi no cambian, así que la fuga no alcanza a inflar el puntaje. Con pocos datos, o con pasos que miran la respuesta (como elegir columnas), la diferencia es enorme, como viste con los datos al azar. El pipeline te protege en todos los casos sin que tengas que pensar en cuál estás.
Crear variables nuevas
A veces la información está en los datos, pero no en una forma que el modelo pueda aprovechar. Ingeniería de variables es crear columnas nuevas a partir de las que hay. Algunas ideas típicas:
- Conteos: cuántas personas viajaban juntas,
familia = sibsp + parch + 1. - Cocientes: la tarifa del Titanic se pagaba por pasaje, que a veces cubría a toda una familia;
tarifa_persona = fare / familiase acerca más a lo que pagó cada uno. - Umbrales: la regresión logística trata la edad como una recta, pero en el tema 4 viste que los menores de 12 años sobrevivieron mucho más.
es_ninovale 1 si la edad es menor que 12. (Si falta la edad, queda en 0.) - Momentos estadísticos: cuando una fila tiene muchas medidas del mismo tipo (por ejemplo, cien lecturas de un sensor), se resumen con su media, su desviación estándar, su asimetría o su máximo. Lo vas a practicar en los ejercicios.
Estas variables se calculan con los datos de cada fila, sin mirar a los demás pasajeros, así que se pueden crear antes de dividir sin fuga. Una variable que usara a otros pasajeros (por ejemplo, «tarifa comparada con la media de su clase») sí tendría que aprenderse solo con el entrenamiento.
def agregar_variables(df):
    """Agrega variables nuevas calculadas fila por fila."""
    df = df.copy()
    df["familia"] = df["sibsp"] + df["parch"] + 1
    df["tarifa_persona"] = df["fare"] / df["familia"]
    df["es_nino"] = (df["age"] < 12).astype(int)
    return df

X_ent_mas = agregar_variables(X_ent)
print(X_ent_mas[["sibsp", "parch", "familia", "fare",
                 "tarifa_persona", "age", "es_nino"]].head(4))
sibsp parch familia fare tarifa_persona age es_nino
671 1 0 2 52.0 26.000000 31.0 0
417 0 2 3 13.0 4.333333 18.0 0
634 3 2 6 27.9 4.650000 9.0 1
323 1 1 3 29.0 9.666667 22.0 0¿Ayudan? No basta con que suenen bien: hay que medirlo, con validación cruzada y solo con el entrenamiento. Comparamos una regresión logística con las columnas originales y con cada grupo de variables nuevas.
def pipe_logistica(numericas):
    """Pipeline de regresión logística para unas columnas numéricas."""
    prep = ColumnTransformer([
        ("num", prep_numericas, numericas),
        ("cat", prep_categoricas, categoricas)])
    return Pipeline([("preparar", prep),
                     ("modelo", LogisticRegression(max_iter=1000))])

pruebas = {"originales": [],
           "+ familia y tarifa_persona": ["familia", "tarifa_persona"],
           "+ es_nino": ["es_nino"]}
for nombre, extra in pruebas.items():
    puntajes = cross_val_score(pipe_logistica(numericas + extra),
                               X_ent_mas, y_ent, cv=pliegues)
    print(f"{nombre:27} {puntajes.mean():.3f} ± {puntajes.std():.3f}")
originales 0.805 ± 0.017
+ familia y tarifa_persona 0.802 ± 0.016
+ es_nino 0.819 ± 0.033Mira las desviaciones (el número después de ±): entre un pliegue y otro, la exactitud varía de 2 a 3 puntos. familia y tarifa_persona no ayudan: el promedio hasta baja un poco, aunque esa diferencia también cabe en el vaivén. es_nino sube el promedio más de un punto y tiene una razón clara detrás (los niños se salvaron más), pero su propia variación es de 3 puntos, así que la mejora es prometedora, no segura; para confirmarla harían falta más pliegues o más datos. Crear variables es probar ideas y medir; muchas no ayudan, y está bien descartarlas.
Buscar hiperparámetros
Los parámetros son lo que el modelo aprende solo al entrenar: los pesos de la regresión logística, las medianas del imputador. Los hiperparámetros son lo que decides tú antes de entrenar: el número de vecinos k, la fuerza de la regularización C, e incluso qué escalador usar. No se aprenden con fit; se eligen probando y midiendo con validación cruzada.
GridSearchCV prueba todas las combinaciones de una rejilla de valores y hace una validación cruzada para cada una. Como recibe el pipeline completo, cada combinación se prepara y se mide sin fuga. Los nombres siguen la ruta de los pasos, con doble guion bajo.
from sklearn.model_selection import GridSearchCV

rejilla = {
    "modelo__n_neighbors": [1, 3, 5, 9, 15, 25, 41],
    "preparar__num__escalar": [StandardScaler(), MinMaxScaler(),
                               "passthrough"]}
busqueda = GridSearchCV(pipe_knn, rejilla, cv=pliegues)
busqueda.fit(X_ent, y_ent)
for nombre, valor in busqueda.best_params_.items():
    print(f"Mejor {nombre}: {valor}")
print(f"Exactitud en validación: {busqueda.best_score_:.3f}")

# Los 21 puntajes, como tabla: una fila por escalador
tabla = busqueda.cv_results_["mean_test_score"].reshape(7, 3).T
escaladores = ["Estandarizar", "Normalizar", "Sin escalar"]
ks = rejilla["modelo__n_neighbors"]
fig, ax = plt.subplots(figsize=(4.8, 2.6))
sns.heatmap(tabla, annot=True, fmt=".2f", cmap=blanco_tinta,
            cbar=False, xticklabels=ks, yticklabels=escaladores,
            annot_kws={"fontsize": 11}, ax=ax)
ax.tick_params(axis="y", labelrotation=0)
ax.set_xlabel("Número de vecinos k")
ax.set_title("Exactitud en validación")
plt.show()
Mejor modelo__n_neighbors: 9
Mejor preparar__num__escalar: StandardScaler()
Exactitud en validación: 0.811
El mapa cuenta dos historias. Por filas: escalar (de cualquiera de las dos formas) le gana a no escalar con todos los valores de k. Por columnas: con k = 1 el modelo memoriza el ruido, y desde 3 o 5 vecinos la exactitud ronda el 0,80 sin grandes cambios. Las diferencias entre las casillas oscuras son de un punto o dos, del mismo tamaño que el vaivén entre pliegues: no te tomes al pie de la letra cuál ganó.
La rejilla tiene un problema: el número de combinaciones se multiplica. Con 4 hiperparámetros de 10 valores cada uno serían 10 000 combinaciones, cada una con 5 entrenamientos. RandomizedSearchCV prueba en cambio un número fijo de combinaciones al azar, sacadas de las distribuciones que le das. Con el mismo presupuesto explora más valores distintos de cada hiperparámetro, y suele encontrar algo igual de bueno mucho antes. Para C, que puede ir de 0,001 a 100, conviene sortear en escala logarítmica (loguniform), para que cada orden de magnitud tenga la misma oportunidad.
from scipy.stats import loguniform
from sklearn.model_selection import RandomizedSearchCV

pipe_log = pipe_logistica(numericas + ["es_nino"])
distribuciones = {"modelo__C": loguniform(1e-3, 1e2)}
azar = RandomizedSearchCV(pipe_log, distribuciones, n_iter=20,
                          cv=pliegues, random_state=0)
azar.fit(X_ent_mas, y_ent)
print(f"Mejor C: {azar.best_params_['modelo__C']:.3f}")
print(f"Exactitud en validación: {azar.best_score_:.3f}")
Mejor C: 0.441
Exactitud en validación: 0.822random_state=0 fija el sorteo, para que la búsqueda dé lo mismo cada vez que la corras. Un último cuidado: el mejor puntaje de una búsqueda es un poco optimista, porque elegimos la combinación que mejor salió entre muchas, y parte de su ventaja es suerte. Por eso el conjunto de prueba sigue guardado: es el único número que no usamos para decidir nada.
El pipeline del tema 10
Juntemos todo en un solo bloque que puedas copiar y reutilizar. Va desde la tabla cruda hasta la evaluación final, y deja listas tres piezas con nombre: agregar_variables, crear_pipeline_titanic(modelo) y la división X_ent, X_prueba, y_ent, y_prueba. En el tema 11 vas a usar este mismo pipeline cambiando solo el modelo.
# El pipeline del tema 10: el Titanic, de la tabla cruda a la predicción
import numpy as np
import pandas as pd
import seaborn as sns
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

NUMERICAS = ["pclass", "age", "sibsp", "parch", "fare",
             "familia", "tarifa_persona", "es_nino"]
CATEGORICAS = ["sex", "embarked"]

def agregar_variables(df):
    """Agrega variables nuevas calculadas fila por fila."""
    df = df.copy()
    df["familia"] = df["sibsp"] + df["parch"] + 1
    df["tarifa_persona"] = df["fare"] / df["familia"]
    df["es_nino"] = (df["age"] < 12).astype(int)
    return df

def crear_pipeline_titanic(modelo):
    """Prepara las columnas del Titanic y termina en el modelo dado."""
    numericas = Pipeline([
        ("imputar", SimpleImputer(strategy="median")),
        ("escalar", StandardScaler())])
    categoricas = Pipeline([
        ("imputar", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore"))])
    preparar = ColumnTransformer([
        ("num", numericas, NUMERICAS),
        ("cat", categoricas, CATEGORICAS)])
    return Pipeline([("preparar", preparar), ("modelo", modelo)])

titanic = agregar_variables(sns.load_dataset("titanic"))
X = titanic[NUMERICAS + CATEGORICAS]
y = titanic["survived"]
X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=0)

pipeline_titanic = crear_pipeline_titanic(
    LogisticRegression(C=0.44, max_iter=1000))
pipeline_titanic.fit(X_ent, y_ent)

# La prueba se usa una sola vez, al final
pred = pipeline_titanic.predict(X_prueba)
exactitud = pipeline_titanic.score(X_prueba, y_prueba)
print(f"Exactitud en prueba: {exactitud:.3f}")
print(classification_report(y_prueba, pred,
                            target_names=["murió", "sobrevivió"]))
Exactitud en prueba: 0.785
precision recall f1-score support
murió 0.80 0.87 0.83 137
sobrevivió 0.76 0.65 0.70 86
accuracy 0.78 223
macro avg 0.78 0.76 0.77 223
weighted avg 0.78 0.78 0.78 223Dos detalles. El modelo final usa todas las variables nuevas (las que no ayudaron tampoco estorban a la regresión logística, y los modelos del tema 11 las pueden aprovechar de otra forma) y una C redondeada cerca de la que encontró la búsqueda aleatoria. La exactitud en prueba, 0,785, queda unos 4 puntos por debajo del 0,822 de la validación. Es una diferencia normal: el mejor puntaje de una búsqueda es algo optimista, y con solo 223 pasajeros cada uno vale casi medio punto, así que la prueba también tiene su propio vaivén. Lo que importa es que este número no se usó para elegir nada. El informe con la precisión y la exhaustividad de cada clase es el del tema 9: el modelo reconoce mejor a los que murieron que a los que sobrevivieron.
Como el pipeline es un solo objeto, predecir para un pasajero nuevo, con huecos y todo, es una línea:
nuevo = agregar_variables(pd.DataFrame([{
    "pclass": 3, "sex": "female", "age": np.nan, "sibsp": 0,
    "parch": 2, "fare": 15.0, "embarked": "S"}]))
prob = pipeline_titanic.predict_proba(nuevo[NUMERICAS + CATEGORICAS])
print(f"Probabilidad de sobrevivir: {prob[0, 1]:.2f}")
Probabilidad de sobrevivir: 0.54A esta pasajera le falta la edad, y el pipeline la rellena con la mediana que aprendió del entrenamiento, escala, codifica y predice, todo en el mismo orden en que lo hizo al entrenar.
Lo que aprendiste y lo que sigue
- Los datos reales llegan con faltantes, texto y escalas distintas. Se mira primero qué falta (el mapa de faltantes) y qué columnas sobran o hacen trampa.
- Imputar rellena los huecos: la mediana si la columna está sesgada, la media si es simétrica, la más frecuente para el texto.
- One-hot convierte una variable nominal en columnas de 0 y 1, sin inventar un orden. Estandarizar y normalizar ponen las numéricas en escalas parecidas; no cambian la forma de la distribución.
- Fuga de datos: todo paso que aprende de los datos es parte del modelo y se ajusta solo con el entrenamiento. Preparar con la prueba infla el puntaje, a veces un poco y a veces muchísimo.
- Un
Pipelinecon unColumnTransformerencadena la preparación y el modelo en un solo objeto, que la validación cruzada y la búsqueda reentrenan entero en cada pliegue. - Los hiperparámetros se eligen con
GridSearchCV(todas las combinaciones) oRandomizedSearchCV(combinaciones al azar), siempre con validación cruzada sobre el entrenamiento. - Una variable nueva se queda solo si mejora más que el vaivén entre pliegues.
En el tema 11 vas a reemplazar la regresión logística por árboles de decisión y bosques dentro de crear_pipeline_titanic, sin tocar nada de la preparación.