La pregunta
Una heladería guarda, de cada cliente con tarjeta, cuánto gasta al mes y cuántas veces viene. Al dueño le gustaría saber qué tipos de clientes tiene, para pensar promociones distintas para cada uno. Pero nadie le dijo cuáles son esos tipos, ni cuántos hay. No existe una columna «tipo de cliente» con la respuesta correcta.
Hasta ahora, todos los modelos de la ruta aprendieron de ejemplos con respuesta: la nota del examen, si el pasajero sobrevivió, la especie de la flor. Aquí no hay respuesta. Lo único que podemos hacer es mirar los datos y preguntarnos: ¿hay puntos que se juntan entre sí y se separan de los demás? Buscar esos grupos se llama clustering (agrupamiento), y es el ejemplo más conocido del aprendizaje no supervisado.
En este tema vas a:
- programar K-means desde cero y entender sus dos pasos, asignar y mover;
- elegir cuántos grupos buscar con el método del codo y el coeficiente de silueta;
- usar DBSCAN para grupos de formas raras y para marcar puntos sueltos como ruido;
- construir y leer un dendrograma (clustering jerárquico);
- reconocer cuándo el clustering espectral separa formas que K-means no puede;
- agrupar con probabilidades con una mezcla de gaussianas, estimar una densidad con KDE y usarla para detectar anomalías;
- comprimir los colores de una foto con K-means.
Necesitas lo del tema 3 (arreglos, broadcasting, una imagen como arreglo) y lo del tema 10 (por qué y cómo escalar las columnas, GridSearchCV). Para la sección de mezclas y densidad, también la distribución normal y el logaritmo del tema 5 y la validación cruzada del tema 7.
Actividad: K-means a mano
Antes de programar nada, agrupa tú. En el dibujo hay puntos sin ningún grupo. Toca el dibujo para poner centroides (el centro de cada grupo; puedes poner hasta cuatro) o usa el botón «Agregar centroide». Después alterna los dos botones:
- Asignar: cada punto se une al centroide más cercano y toma su forma (círculo, cuadrado, triángulo o rombo).
- Mover: cada centroide se va al promedio de los puntos de su grupo.
Debajo verás la inercia: la suma de las distancias al cuadrado de cada punto a su centroide. Es el error que K-means intenta bajar.
K-means a mano
Estos son los puntos, todavía sin grupos. Con JavaScript activado puedes poner centroides, asignar, mover y probar DBSCAN.
Con el foco en un centroide, las flechas lo mueven (con Mayúsculas, más lejos) y Suprimir lo quita. Con el foco en el dibujo en modo DBSCAN, las flechas recorren los puntos.
Centroides: 0 de 4Inercia: —
Historial de la inercia: todavía nada
Grupos: 0Núcleo: 0Borde: 0Ruido: 0
Pasa el puntero sobre un punto para ver su círculo.
Toca el dibujo para poner un centroide, o pulsa «Agregar centroide».
Prueba esto, en orden:
- Pon cuatro centroides, uno en cada mancha, y pulsa Asignar y Mover hasta que nada cambie. Anota la inercia.
- Pulsa «Quitar centroides» y pon los cuatro todos en la misma mancha. Repite Asignar y Mover. ¿Llegas a los mismos grupos? ¿Y a la misma inercia?
- Prueba con dos y con tres centroides. ¿La inercia sube o baja? ¿Con cuántos centroides queda más baja?
- Cambia a los datos «Lunas» y haz K-means con dos centroides. ¿Separa las dos lunas?
- Cambia al modo DBSCAN. Pasa el puntero (o mueve el círculo con las flechas) y mira cuántos vecinos caben en el círculo. Mueve el radio eps: ¿qué pasa cuando es muy chico? ¿Y muy grande?
Lo que acabas de hacer es K-means completo: asignar al más cercano y mover al promedio, una y otra vez. Y viste sus dos debilidades: el resultado depende de dónde empiezas, y solo sabe encontrar grupos redondos.
Aprender sin etiquetas
En el aprendizaje supervisado cada ejemplo trae una característica x y un objetivo y, y el modelo aprende a predecir y. En el no supervisado solo hay x: el modelo busca estructura en los datos mismos. Agrupar es una forma de hacerlo; reducir dimensiones (tema 15) es otra.
Como no hay respuesta correcta, «buen grupo» necesita una definición. La más común: los puntos de un mismo grupo están cerca entre sí y lejos de los de otros grupos. Todo depende, entonces, de cómo medimos la cercanía. Usaremos la distancia euclidiana (la de la regla, que calculaste en el tema 3), y eso trae la advertencia del tema 10: si una columna está en bolivianos y otra en años, la de números grandes manda en la distancia. Antes de agrupar datos reales hay que escalar las columnas. Lo vas a comprobar en los ejercicios.
Para aprender los métodos usaremos datos sintéticos: make_blobs de scikit-learn genera puntos alrededor de unos centros, como manchas. Nosotros sabemos de qué mancha salió cada punto (y_verdad), pero el algoritmo no lo va a ver: solo recibe X. Así podremos comprobar si encuentra los grupos.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs

# 300 puntos sintéticos alrededor de 4 centros
X, y_verdad = make_blobs(n_samples=300, centers=4, cluster_std=0.9,
                         random_state=7)
print("Forma de X:", X.shape)
print("Primeros puntos:", X[:3].round(1).tolist())

plt.scatter(X[:, 0], X[:, 1], s=16)
plt.xlabel("Característica 1")
plt.ylabel("Característica 2")
plt.title("300 puntos sin etiqueta (sintéticos)")
plt.show()
Forma de X: (300, 2)
Primeros puntos: [[9.4, -1.3], [-0.5, -8.4], [8.1, 1.8]]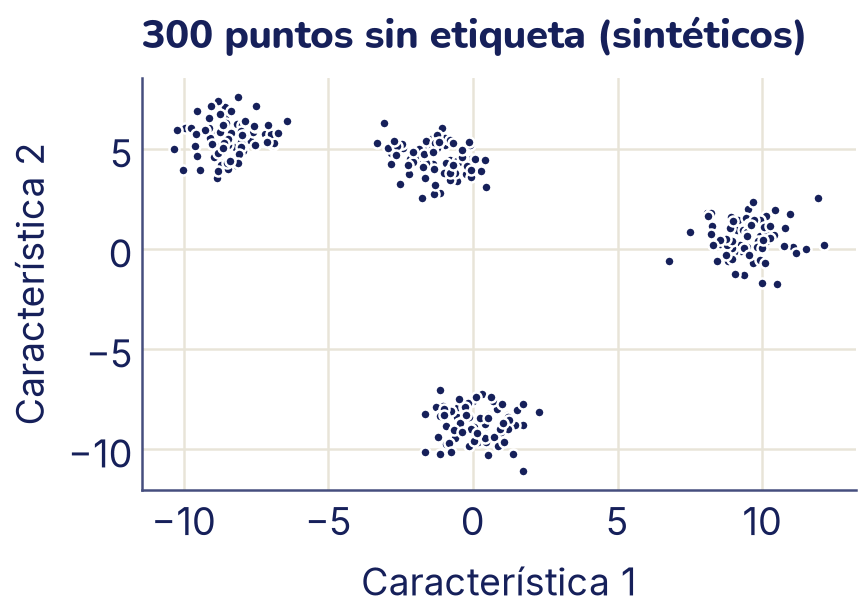
Tú ves cuatro manchas sin esfuerzo. El reto es escribir una receta que las encuentre sola, también cuando hay 10 columnas y no se pueden dibujar.
K-means: asignar y mover
K-means busca k grupos (el número k lo eliges tú). Cada grupo tiene un centroide, un punto que lo representa. La receta:
- Elegir k centroides iniciales; por ejemplo, k puntos de los datos al azar.
- Asignar: cada punto va al grupo del centroide más cercano.
- Mover: cada centroide se reemplaza por el promedio de los puntos de su grupo.
- Repetir 1 y 2 hasta que los centroides dejen de moverse.
¿Qué está optimizando? La inercia: la suma, sobre todos los puntos, de la distancia al cuadrado a su centroide.
Aquí xi es el punto i y cg(i) es el centroide del grupo al que pertenece. Los dos pasos bajan la inercia (o la dejan igual), por eso el método siempre termina:
- Al asignar, cada punto elige el centroide más cercano: su término de la suma no puede subir.
- Al mover, el promedio es justo el punto que hace mínima la suma de distancias al cuadrado de un grupo (es la misma razón por la que, en el tema 5, la media minimizaba el error cuadrático).
En NumPy cabe en unas 15 líneas. El truco está en calcular de una vez la distancia de cada punto a cada centroide con broadcasting: X[:, None, :] tiene forma (300, 1, 2) y centroides[None, :, :], forma (1, 4, 2); al restarlos queda (300, 4, 2), y la norma sobre el último eje da una tabla de distancias de (300, 4).
def kmeans(X, centroides, pasos=100):
    """K-means desde unos centroides iniciales.

    Devuelve el grupo de cada punto, los centroides finales
    y la lista de centroides de cada vuelta.
    """
    k = len(centroides)
    historial = [centroides]
    for _ in range(pasos):
        # 1) Asignar: distancia de cada punto a cada centroide, (n, k)
        d = np.linalg.norm(X[:, None, :] - centroides[None, :, :], axis=2)
        grupo = d.argmin(axis=1)
        # 2) Mover: cada centroide va al promedio de su grupo
        #    (si un grupo quedó vacío, su centroide no se mueve)
        nuevos = np.array([X[grupo == j].mean(axis=0) if np.any(grupo == j)
                           else centroides[j] for j in range(k)])
        if np.allclose(nuevos, centroides):   # ya no se mueven: listo
            break
        centroides = nuevos
        historial.append(centroides)
    return grupo, centroides, historial

def inercia(X, grupo, centroides):
    """Suma de las distancias al cuadrado de cada punto a su centroide."""
    return np.sum((X - centroides[grupo]) ** 2)

rng = np.random.default_rng(6)
# Cuatro puntos de los datos, al azar, como centroides iniciales
iniciales = X[rng.choice(len(X), size=4, replace=False)]
grupo, centroides, historial = kmeans(X, iniciales)

print("Vueltas hasta que los centroides se quedaron quietos:",
      len(historial) - 1)
print("Centroides finales:")
print(centroides.round(2))
print(f"Inercia final: {inercia(X, grupo, centroides):.1f}")
print("Puntos por grupo:", np.bincount(grupo))
Vueltas hasta que los centroides se quedaron quietos: 3
Centroides finales:
[[ 0.09 -8.71]
[ 9.52 0.53]
[-8.44 5.49]
[-1.31 4.54]]
Inercia final: 462.8
Puntos por grupo: [75 75 75 75]centroides[grupo] usa el arreglo grupo como índice: arma una tabla de (300, 2) con el centroide de cada punto, para restarla de X de una sola vez. Los cuatro grupos tienen 75 puntos cada uno, como las manchas que generamos.
Para dibujar varios grupos usaremos una función que les da un color y una forma distinta (círculo, cuadrado, triángulo, rombo). La forma ayuda a distinguirlos aunque los colores se parezcan o la figura se imprima en blanco y negro. Los centroides finales van en coral.
FORMAS = ["o", "s", "^", "D"]          # círculo, cuadrado, triángulo, rombo
COLORES = ["C0", "C2", "C3", "C0"]

def dibujar_grupos(eje, X, grupo, s=14):
    """Un color y una forma por grupo; el ruido (grupo -1) va como x."""
    for g in np.unique(grupo):
        parte = X[grupo == g]
        if g == -1:
            eje.scatter(parte[:, 0], parte[:, 1], s=s, marker="x",
                        color="C2", linewidths=1)
        else:
            eje.scatter(parte[:, 0], parte[:, 1], s=s, marker=FORMAS[g % 4],
                        color=COLORES[g % 4], edgecolors="C0",
                        linewidths=0.6)

fig, ejes = plt.subplots(2, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for vuelta, eje in enumerate(ejes.flat):
    c = historial[vuelta]
    # Asignar cada punto al centroide de esta vuelta
    g = np.linalg.norm(X[:, None, :] - c[None, :, :], axis=2).argmin(axis=1)
    dibujar_grupos(eje, X, g, s=12)
    final = vuelta == len(historial) - 1
    eje.scatter(c[:, 0], c[:, 1], marker="X", s=150, linewidths=1.5,
                color="C1" if final else "C0", edgecolors="white")
    nombre = "Inicio" if vuelta == 0 else f"Vuelta {vuelta}"
    eje.set_title(f"{nombre}\ninercia {inercia(X, g, c):.0f}")
plt.show()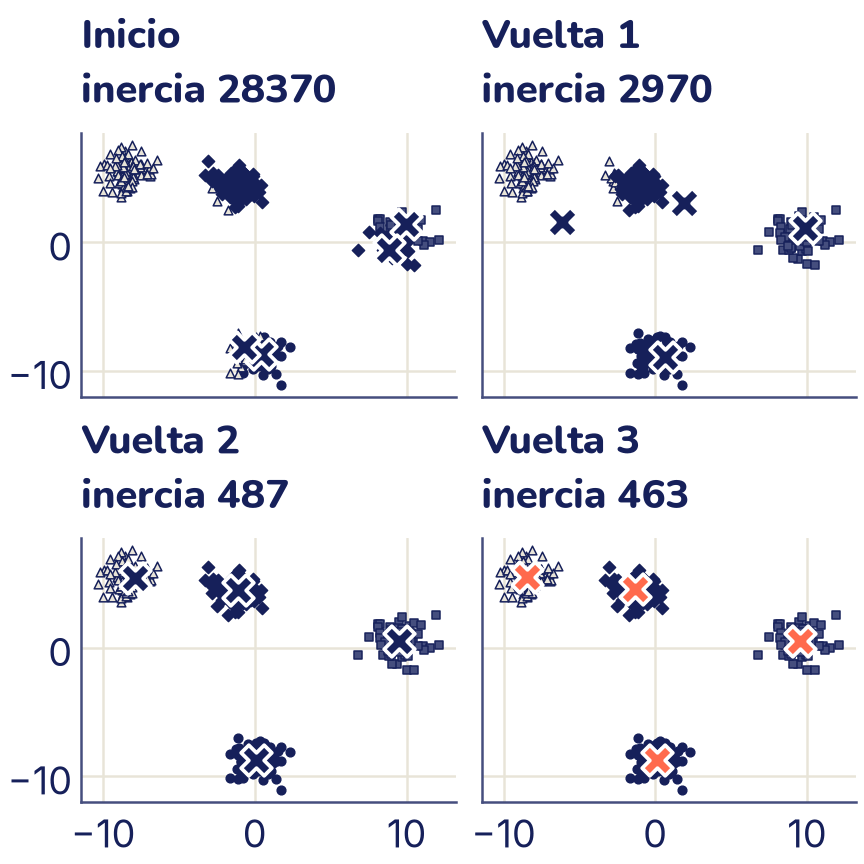
Lee la figura en orden. Al inicio, el azar puso dos centroides en la mancha de la derecha y dos en la de abajo: las dos manchas de arriba no tienen centroide propio y se reparten mal, y la inercia es enorme (28 370). En la primera vuelta, los dos centroides que se quedaron con las manchas de arriba (más unos pocos puntos de otras manchas) se mueven al promedio de esos puntos, que queda entre manchas. En la segunda, cada uno ya encontró su mancha y la inercia baja a 487; en la tercera se acomodan al centro y la inercia queda en 463. Después ya no se mueven: K-means terminó.
Mínimos locales y k-means++
K-means siempre baja la inercia, pero no siempre llega a la mejor agrupación. Como el descenso del tema 6 en un valle con varios pozos, se queda en el primer fondo que encuentra: un mínimo local. Probemos varias semillas para los centroides iniciales:
for semilla in range(6):
    rng = np.random.default_rng(semilla)
    inicio = X[rng.choice(len(X), size=4, replace=False)]
    g, c, h = kmeans(X, inicio)
    print(f"Semilla {semilla}:  {len(h) - 1:2d} vueltas   "
          f"inercia {inercia(X, g, c):7.1f}   "
          f"tamaños {np.bincount(g, minlength=4)}")
Semilla 0: 2 vueltas inercia 462.8 tamaños [75 75 75 75]
Semilla 1: 6 vueltas inercia 2359.7 tamaños [150 35 75 40]
Semilla 2: 7 vueltas inercia 2360.2 tamaños [150 37 38 75]
Semilla 3: 5 vueltas inercia 2360.6 tamaños [150 43 32 75]
Semilla 4: 4 vueltas inercia 2359.7 tamaños [ 75 150 35 40]
Semilla 5: 10 vueltas inercia 6952.8 tamaños [ 75 38 37 150]Las mismas manchas, el mismo método y resultados muy distintos. La semilla 0, igual que la 6 que usamos en la sección anterior, encontró las cuatro manchas (inercia 462,8). Las semillas 1 a 4 se quedaron en un mínimo local con una inercia unas cinco veces mayor. Mira los tamaños: un grupo de 150 puntos son dos manchas unidas, y otra mancha quedó partida en dos grupos de entre 32 y 43 puntos. La semilla 5 es todavía peor. Es lo que viste en la actividad al poner todos los centroides en la misma mancha: K-means no puede «saltar» a otra solución, solo bajar desde donde empezó.
Hay dos remedios, y scikit-learn usa los dos:
- Empezar mejor: k-means++. El primer centroide se elige al azar entre los puntos; cada siguiente se elige también al azar, pero dando más probabilidad a los puntos lejos de los centroides que ya hay (la probabilidad es proporcional a la distancia al cuadrado). Así es raro que dos centroides empiecen en la misma mancha.
- Probar varias veces.
n_init=10corre K-means 10 veces con inicios distintos y se queda con el de menor inercia.
from sklearn.cluster import KMeans

modelo = KMeans(n_clusters=4, n_init=10, random_state=0)
grupos_km = modelo.fit_predict(X)

print(f"Inercia: {modelo.inertia_:.1f}")
print("Centroides:")
print(modelo.cluster_centers_.round(2))
print("Grupo de los 10 primeros puntos:", grupos_km[:10])
Inercia: 462.8
Centroides:
[[ 9.52 0.53]
[-1.31 4.54]
[ 0.09 -8.71]
[-8.44 5.49]]
Grupo de los 10 primeros puntos: [0 2 0 1 0 3 3 2 0 3]La misma inercia que nuestra mejor ejecución. Los centroides son los mismos, aunque pueden salir en otro orden: los números de grupo (0, 1, 2, 3) son solo nombres, y no significan nada por sí mismos. Por eso no se puede comparar grupos_km con y_verdad número a número.
¿Cuántos grupos? El codo y la silueta
Hasta aquí elegimos k = 4 porque vimos el dibujo. Con datos de muchas columnas no hay dibujo. ¿Por qué no elegir el k con menor inercia? Porque la inercia siempre baja al agregar grupos: con un grupo por punto, es cero. Hacen falta otras ideas.
El método del codo. Se grafica la inercia según k. Al principio baja mucho (cada grupo nuevo separa manchas que estaban juntas) y después baja poco (cada grupo nuevo parte una mancha que ya estaba bien). El k donde la curva «dobla», como un codo, es un buen candidato.
El coeficiente de silueta. Mide, para cada punto, si está mejor en su grupo que en el grupo vecino. Para el punto i:
- a es la distancia promedio a los demás puntos de su grupo (qué tan apretado está);
- b es la distancia promedio a los puntos del grupo más cercano que no es el suyo (qué tan lejos está la alternativa).
La silueta va de −1 a 1. Cerca de 1: el punto está bien metido en su grupo y lejos del otro. Cerca de 0: está en la frontera. Negativa: estaría mejor en el otro grupo. silhouette_score da el promedio de todos los puntos; se elige el k con la silueta promedio más alta.
from sklearn.metrics import silhouette_score

ks = range(2, 9)
inercias, siluetas = [], []
for k in ks:
    m = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    inercias.append(m.inertia_)
    siluetas.append(silhouette_score(X, m.labels_))
    print(f"k = {k}:   inercia {m.inertia_:7.1f}   "
          f"silueta {siluetas[-1]:.3f}")

mejor_k = ks[np.argmax(siluetas)]
fig, (arriba, abajo) = plt.subplots(2, 1, figsize=(4.8, 4.8), sharex=True)
arriba.plot(ks, inercias, marker="o", color="C0")
arriba.set_ylabel("Inercia")
arriba.set_title("El codo y la silueta según k")
abajo.plot(ks, siluetas, marker="o", color="C2")
abajo.scatter([mejor_k], [max(siluetas)], s=160, color="C1", zorder=3,
              label=f"La más alta: k = {mejor_k}")
abajo.set_ylabel("Silueta")
abajo.set_xlabel("Cantidad de grupos k")
# Solo para dibujar: margen para que el punto no toque el borde de arriba
abajo.margins(y=0.15)
abajo.legend()
plt.show()
k = 2: inercia 8941.6 silueta 0.599
k = 3: inercia 2402.8 silueta 0.776
k = 4: inercia 462.8 silueta 0.826
k = 5: inercia 414.0 silueta 0.721
k = 6: inercia 370.8 silueta 0.584
k = 7: inercia 326.5 silueta 0.456
k = 8: inercia 282.6 silueta 0.356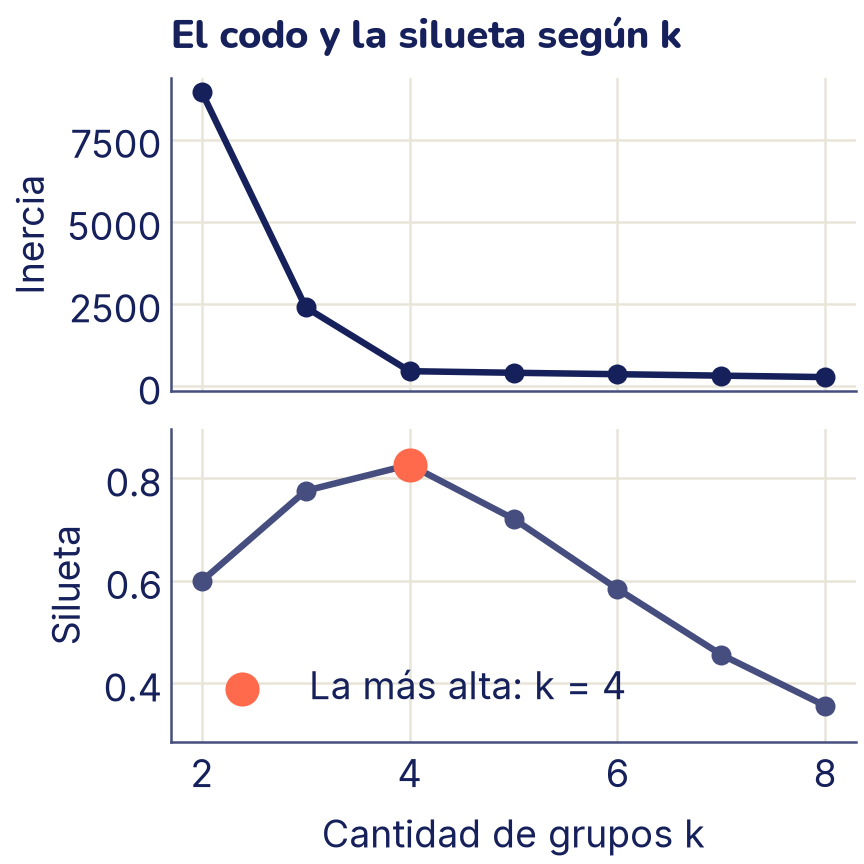
Los dos métodos coinciden en este caso. La inercia cae de 8942 a 2403 y a 463 entre k = 2 y k = 4, y después apenas baja (414 con k = 5): el codo está en 4. La silueta es máxima en k = 4, con 0,826; con 5 grupos baja a 0,721, porque una mancha se parte en dos y sus puntos quedan muy cerca del grupo vecino.
Ninguno de los dos métodos es una ley. Con datos reales el codo suele ser suave y la silueta puede empatar entre dos valores de k. Entonces decide también la pregunta: si el dueño de la heladería puede manejar tres promociones y no siete, eso pesa tanto como cualquier número.
DBSCAN: grupos por densidad
K-means tiene dos límites que viste en la actividad: hay que decirle k, y sus grupos son siempre «redondos», porque cada punto va al centroide más cercano. Si los grupos tienen forma de luna o de anillo, falla.
DBSCAN piensa distinto: un grupo es una zona densa, con muchos puntos apretados, separada de otras zonas densas por zonas casi vacías. Tiene dos parámetros:
eps: el radio del vecindario de cada punto (el círculo de la actividad).min_samples: cuántos puntos tiene que haber dentro de ese círculo (contando al propio punto) para que la zona cuente como densa.
Con ellos, cada punto es de uno de tres tipos:
- Núcleo: tiene al menos
min_samplespuntos a distanciaepso menos. Está en el corazón de un grupo. - Borde: no es núcleo, pero está a distancia
epso menos de algún núcleo. Pertenece al grupo de ese núcleo. - Ruido: ni lo uno ni lo otro. DBSCAN no lo pone en ningún grupo y le da la etiqueta −1.
Un grupo se forma encadenando núcleos vecinos: si dos núcleos están a distancia eps o menos, van al mismo grupo, y así el grupo puede tomar cualquier forma. Además DBSCAN decide solo cuántos grupos hay.
Probemos con make_moons, dos medias lunas encajadas, también sintéticas:
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN

X_lunas, y_lunas = make_moons(n_samples=300, noise=0.08, random_state=0)

db = DBSCAN(eps=0.2, min_samples=5).fit(X_lunas)
grupos_db = db.labels_
nucleo = np.zeros(len(X_lunas), dtype=bool)
nucleo[db.core_sample_indices_] = True
ruido = grupos_db == -1
borde = ~nucleo & ~ruido

print("Grupos encontrados:", len(set(grupos_db) - {-1}))
print(f"Núcleo: {nucleo.sum()}   borde: {borde.sum()}   "
      f"ruido: {ruido.sum()}")
Grupos encontrados: 2
Núcleo: 297 borde: 2 ruido: 1DBSCAN encontró los 2 grupos sin que le dijéramos cuántos. De los 300 puntos, 297 son núcleo, 2 son borde y 1 quedó como ruido: un punto suelto entre las dos lunas, que no tiene suficientes vecinos cerca.
El precio: eps hay que elegirlo, y es delicado. Muy chico, casi todo es ruido y aparecen muchos grupos pequeños; muy grande, todo se une en un solo grupo. Como eps es una distancia, escalar las columnas otra vez es obligatorio. Y si un grupo es mucho más denso que otro, puede que ningún eps sirva para los dos.
Clustering jerárquico y el dendrograma
El clustering aglomerativo construye los grupos de abajo hacia arriba:
- Al principio, cada punto es su propio grupo.
- Se unen los dos grupos más cercanos.
- Se repite hasta que queda un solo grupo con todos.
¿Qué significa «los dos grupos más cercanos»? Depende del enlace (linkage):
| Enlace | Distancia entre dos grupos | Cómo son los grupos |
|---|---|---|
single (simple) |
La de sus dos puntos más cercanos | Sigue cadenas y formas largas, pero un puente de puntos puede unir dos grupos |
complete (completo) |
La de sus dos puntos más lejanos | Compactos y de tamaño parecido |
average (promedio) |
El promedio de todas las distancias entre sus puntos | Un término medio |
ward |
Cuánto sube la inercia si se unen | Redondos, como K-means; es el de scikit-learn por defecto |
Todo el historial de uniones se dibuja como un árbol: el dendrograma. Abajo están los puntos; cada unión es una horquilla, y la altura de la horquilla es la distancia a la que se unieron esos grupos. Para obtener grupos, se corta el árbol con una línea horizontal: cada rama que la línea cruza es un grupo. Las horquillas muy altas indican grupos bien separados, que conviene no unir.
Con 300 puntos el árbol tiene 300 hojas, demasiadas para leerlas. truncate_mode="lastp" dibuja solo las últimas 12 ramas y pone entre paréntesis cuántos puntos tiene cada una.
from scipy.cluster.hierarchy import linkage, dendrogram

# Cada fila de Z es una unión: grupo, grupo, distancia, tamaño
Z = linkage(X, method="ward")
print("Forma de Z:", Z.shape)
print("Altura de las 4 últimas uniones:", Z[-4:, 2].round(1))

# Un corte entre la 4.ª y la 3.ª unión desde arriba deja 4 grupos
corte = (Z[-4, 2] + Z[-3, 2]) / 2
dendrogram(Z, truncate_mode="lastp", p=12, leaf_font_size=11,
           link_color_func=lambda k: "C0")
plt.axhline(corte, color="C1", linestyle="--", label="Corte: 4 grupos")
plt.ylim(0, 210)                      # espacio arriba para la leyenda
plt.ylabel("Distancia de unión")
plt.title("Dendrograma (enlace ward)")
plt.legend(loc="upper left")
plt.show()
Forma de Z: (299, 4)
Altura de las 4 últimas uniones: [ 9.3 62.3 114.4 162.8]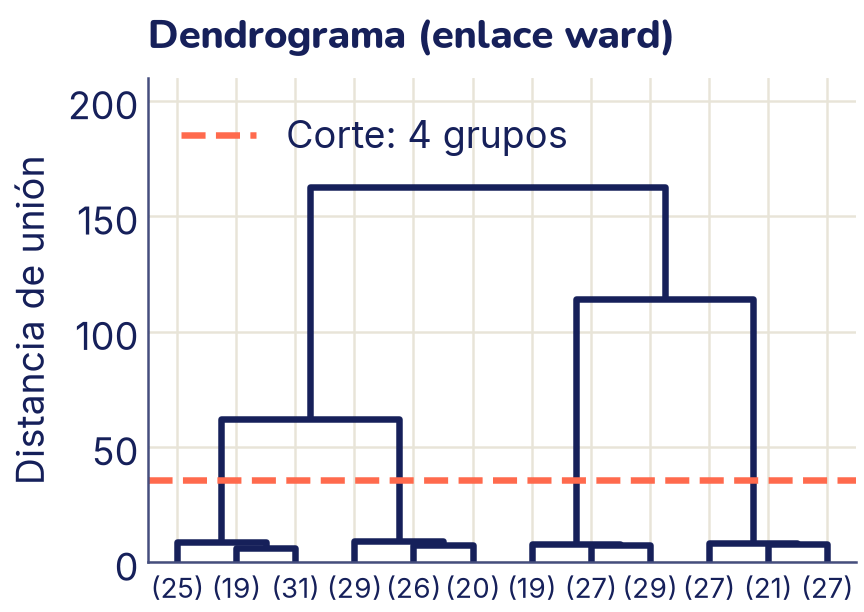
El árbol cuenta la historia de las manchas. Abajo, las 12 ramas se unen de a pares o de a tres a muy poca altura (menos de 10): son puntos de una misma mancha. Después hay un salto grande: la siguiente unión ocurre a 62,3, y las dos últimas a 114,4 y 162,8. Ese salto es la señal de que hay 4 grupos bien separados, y la línea coral corta justo en el espacio vacío. Si cortaras más arriba, entre 62,3 y 114,4, tendrías 3 grupos: dos de las manchas unidas.
En scikit-learn, el aglomerativo es AgglomerativeClustering, con la cantidad de grupos (es decir, dónde cortar) y el enlace:
from sklearn.cluster import AgglomerativeClustering
from sklearn.metrics import adjusted_rand_score

grupos_ag = AgglomerativeClustering(n_clusters=4,
                                    linkage="ward").fit_predict(X)
print("Puntos por grupo:", np.bincount(grupos_ag))
print("Acuerdo con K-means:", adjusted_rand_score(grupos_km, grupos_ag))
print("Acuerdo con la verdad:", adjusted_rand_score(y_verdad, grupos_ag))
Puntos por grupo: [75 75 75 75]
Acuerdo con K-means: 1.0
Acuerdo con la verdad: 1.0Para comparar dos agrupaciones usamos el índice de Rand ajustado (adjusted_rand_score): mira cada par de puntos y cuenta si las dos agrupaciones coinciden en ponerlos juntos o separados. Vale 1 si las agrupaciones son iguales (sin importar los nombres de los grupos) y cerca de 0 si coinciden tanto como dos agrupaciones al azar. Solo lo podemos usar con y_verdad porque los datos son sintéticos; con datos reales sin etiquetas no hay contra qué comparar.
Clustering espectral: pensar en vecinos
El clustering espectral también parte de las cercanías, pero de otra forma. Imagina que cada punto le da la mano a sus 10 vecinos más cercanos: queda una red, un grafo de vecinos. Dentro de una luna, cada punto está conectado con muchos de la misma luna; entre las dos lunas hay muy pocas conexiones. El método busca cortar la red en partes cortando la menor cantidad de conexiones posible.
La matemática detrás usa los vectores propios (el «espectro») de una matriz que describe el grafo; los vectores propios los vas a ver en el tema 15. La intuición basta: dos puntos van al mismo grupo si se puede ir de uno al otro saltando entre vecinos, aunque estén lejos en línea recta. Por eso sigue las formas curvas. Su costo: hay que elegir k, y con muchos miles de puntos se vuelve lento.
Mezclas de gaussianas y densidad: grupos con probabilidad
K-means tiene dos costumbres que a veces molestan. Sus grupos son siempre redondos, porque cada punto va al centroide más cercano en línea recta. Y su respuesta es tajante: un punto que está justo entre dos manchas va a una de ellas con la misma seguridad que uno que está en el centro. Un modelo de mezcla de gaussianas (en inglés, Gaussian mixture model) corrige las dos cosas.
La idea: imagina que los datos salieron de varias campanas como la normal del tema 5, pero en dos dimensiones. Cada campana tiene un centro (como un centroide), una forma, que puede ser una elipse estirada y girada en lugar de un círculo, y un peso, la fracción de los datos que salió de ella. Agrupar es adivinar esas campanas. Y como cada campana dice qué tan probable es un punto, el modelo puede responder «este punto es 97 % del grupo A y 3 % del B»: una asignación suave. Podemos resumirlo así: K-means con elipses y con probabilidades.
Probemos con tres manchas sintéticas estiradas. Las genera make_blobs, y después las estiramos y giramos multiplicando cada punto por una matriz de 2 × 2 con @:
from sklearn.mixture import GaussianMixture

# return_centers=True devuelve también los centros de las manchas
X_m, y_est, centros = make_blobs(n_samples=300, centers=3,
                                 cluster_std=1.15, random_state=170,
                                 return_centers=True)
estirar = np.array([[0.6, -0.6], [-0.4, 0.8]])
# Cada punto (fila) por la matriz: la nube se estira y se gira
X_est = X_m @ estirar

grupos_km3 = KMeans(n_clusters=3, n_init=10,
                    random_state=0).fit_predict(X_est)
gmm = GaussianMixture(n_components=3, n_init=5, random_state=0)
grupos_gmm = gmm.fit_predict(X_est)

print("Acuerdo con la verdad:")
print(f"  K-means: {adjusted_rand_score(y_est, grupos_km3):.2f}")
print(f"  Mezcla:  {adjusted_rand_score(y_est, grupos_gmm):.2f}")
print("Pesos de las campanas:", gmm.weights_.round(2))
Acuerdo con la verdad:
K-means: 0.45
Mezcla: 0.99
Pesos de las campanas: [0.33 0.33 0.34]n_components es la cantidad de campanas (el k de la mezcla), y n_init=5 prueba cinco inicios, como en K-means. La mezcla encontró las tres manchas casi exactamente como las generamos (acuerdo 0,99), y K-means no (0,45): sus fronteras son rectas a mitad de camino entre centroides, y las manchas estiradas se pasan de esa mitad, así que les corta las puntas. Los pesos dicen que cada campana explica más o menos un tercio de los puntos.
La asignación suave sale con predict_proba: una fila por punto y una columna por campana, y cada fila suma 1.
prob = gmm.predict_proba(X_est)
print("Probabilidades de los 3 primeros puntos:")
print(prob[:3].round(3))

seguridad = prob.max(axis=1)        # la probabilidad del grupo elegido
dudoso = seguridad.argmin()
print("El punto más dudoso:", X_est[dudoso].round(2),
      "probabilidades", prob[dudoso].round(2))
print("Puntos con menos de 95 % de seguridad:", (seguridad < 0.95).sum())
Probabilidades de los 3 primeros puntos:
[[1. 0. 0.]
[0. 0. 1.]
[0. 0. 1.]]
El punto más dudoso: [-1.9 0.35] probabilidades [0. 0.28 0.72]
Puntos con menos de 95 % de seguridad: 3Los tres primeros puntos pertenecen a su grupo con probabilidad 1 (redondeada a tres decimales), y así casi todos. Solo los que caen donde dos campanas se tocan quedan repartidos: el más dudoso, en (−1,9; 0,35), es 72 % de una campana y 28 % de otra, y apenas 3 de los 300 puntos tienen menos de 95 % de seguridad. K-means habría puesto a esos tres en un grupo con la misma seguridad que a todos los demás. En el dibujo, las curvas de nivel marcan dónde la densidad de la mezcla es igual (como las curvas de un mapa de montañas): son elipses alrededor de cada mancha, y no círculos. Los puntos dudosos van en coral.
# Una rejilla de puntos que cubre los datos, para calcular la densidad
A, B = np.meshgrid(np.linspace(-7, 4, 200), np.linspace(-4, 6, 200))
rejilla = np.column_stack([A.ravel(), B.ravel()])
# score_samples da el logaritmo de la densidad; exp lo deshace
densidad = np.exp(gmm.score_samples(rejilla)).reshape(A.shape)

fig, eje = plt.subplots()
eje.contour(A, B, densidad, levels=6, colors="C2", linewidths=0.8)
dibujar_grupos(eje, X_est, grupos_gmm, s=12)
dudosos = X_est[seguridad < 0.95]
eje.scatter(dudosos[:, 0], dudosos[:, 1], s=140, facecolors="none",
            edgecolors="C1", linewidths=1.8, label="Menos de 95 % seguro")
eje.set_title("Mezcla de 3 gaussianas: elipses")
eje.legend(loc="lower left")
plt.show()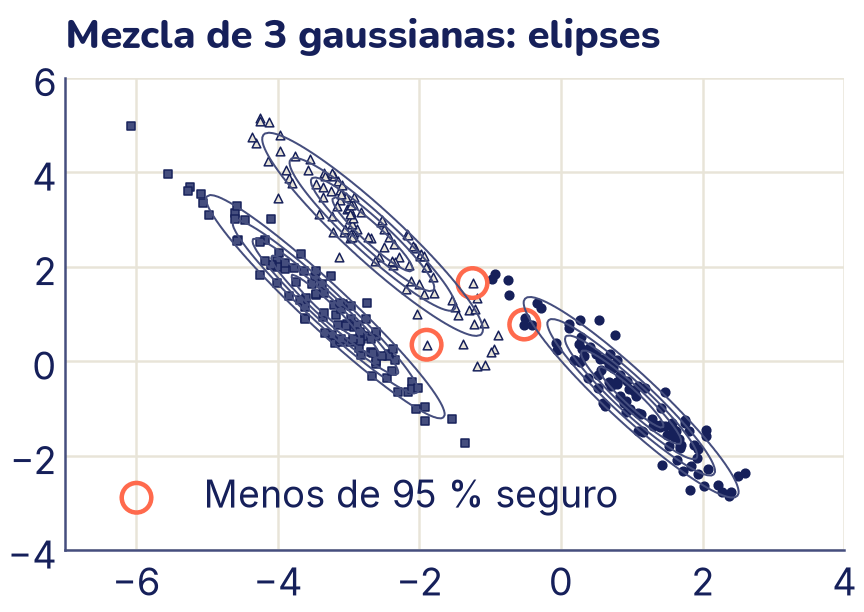
Cómo aprende la mezcla: el algoritmo EM
Nadie le dice a la mezcla dónde están las campanas. Las encuentra con el algoritmo EM (de expectation–maximization, «esperanza y maximización»), que es el mismo baile de K-means en versión suave:
- Empezar con unas campanas cualesquiera (scikit-learn las inicia con K-means).
- Paso E, asignar con probabilidad: cada punto calcula, con la fórmula de cada campana, qué tan probable es que haya salido de ella, y reparte su «voto» entre las campanas (es
predict_proba). Un punto en el centro de una mancha vota casi todo por su campana; uno en la frontera, la mitad y la mitad. - Paso M, mover las campanas: cada campana se va al promedio ponderado de los puntos, donde cada punto cuenta según su voto para ella. Con los mismos votos recalcula su forma (cuánto se estira y hacia dónde) y su peso (la suma de sus votos, dividida entre la cantidad de puntos).
- Repetir hasta que nada cambie.
Si las campanas fueran todas redondas, del mismo tamaño y los votos fueran todo o nada, EM sería exactamente K-means. Y, como K-means, EM siempre mejora (o deja igual) lo que mide en cada vuelta, pero puede quedarse en una solución que no es la mejor, según dónde empezó: por eso n_init. En el ejercicio 9 lo programas tú en una dimensión.
¿Qué mide? La log-verosimilitud: qué tan probables son los datos según el modelo. Se calcula la densidad de cada punto según la mezcla, se toma su logaritmo y se promedia. (Igual que en el tema 5, log es el logaritmo natural, el ln del colegio; se usa porque convierte el producto de muchas probabilidades chicas en una suma.) Más alta es mejor: quiere decir que las campanas ponen mucha densidad donde hay datos.
¿Cuántas campanas? El BIC
Con la log-verosimilitud pasa lo mismo que con la inercia: siempre mejora al agregar campanas, porque más campanas se pegan más a los datos. El BIC (Bayesian information criterion, criterio de información bayesiano) le pone un castigo: cuenta cuántos números tiene que aprender el modelo (centros, formas y pesos) y cobra por cada uno, más cuanto más datos hay.
El primer término baja cuando el modelo se ajusta mejor; el segundo sube con cada campana. Se elige el k con el BIC más bajo: el que explica bien los datos sin campanas de sobra.
for k in range(1, 7):
    m = GaussianMixture(n_components=k, n_init=5,
                        random_state=0).fit(X_est)
    print(f"k = {k}:   log-verosimilitud media {m.score(X_est):6.3f}"
          f"   BIC {m.bic(X_est):6.1f}")
k = 1: log-verosimilitud media -3.615 BIC 2197.5
k = 2: log-verosimilitud media -3.144 BIC 1949.4
k = 3: log-verosimilitud media -2.789 BIC 1770.4
k = 4: log-verosimilitud media -2.772 BIC 1794.4
k = 5: log-verosimilitud media -2.768 BIC 1826.2
k = 6: log-verosimilitud media -2.752 BIC 1851.1La log-verosimilitud media (score) sube con cada campana, aunque de k = 3 en adelante apenas cambia. El BIC baja hasta k = 3 y después sube: la cuarta campana mejora tan poco el ajuste que no paga su castigo. A diferencia del codo, aquí hay un mínimo claro que se puede elegir sin mirar el dibujo.
Densidad sin campanas fijas: KDE
Una mezcla supone que los datos salen de pocas campanas. ¿Y si la forma es cualquiera? La estimación de densidad por kernel (KDE, kernel density estimation) lleva la idea al extremo: pone una campanita sobre cada dato y las promedia. Donde hay muchos datos juntos, las campanitas se apilan y la densidad sube; donde no hay ninguno, queda casi en cero. Es como un histograma suave, sin el problema de dónde empieza cada barra. La campanita se llama kernel (núcleo), una palabra que ya viste en el tema 12 con otro uso: allí era una función que mide el parecido entre dos puntos, y aquí es la forma que se pone sobre cada dato.
El único parámetro es el ancho de banda h (bandwidth), la desviación estándar de cada campanita. Probémoslo en una dimensión, con los minutos que tardan 120 estudiantes en llegar al colegio (datos sintéticos: 70 vienen a pie y tardan unos 12 minutos; 50 vienen en micro y tardan unos 32). Primero desde cero, con la densidad_normal del tema 5, y después con KernelDensity de scikit-learn, para ver que dan lo mismo:
from sklearn.neighbors import KernelDensity

rng = np.random.default_rng(1)
tiempos = np.concatenate([rng.normal(12, 3, 70), rng.normal(32, 6, 50)])

def densidad_normal(x, mu, sigma):
    """La fórmula de la campana, del tema 5."""
    return (np.exp(-(x - mu) ** 2 / (2 * sigma ** 2))
            / (sigma * np.sqrt(2 * np.pi)))

def kde(xs, datos, h):
    """Una campanita de ancho h sobre cada dato, y el promedio."""
    # Tabla (len(xs), len(datos)); el promedio va por filas
    return densidad_normal(xs[:, None], datos[None, :], h).mean(axis=1)

xs = np.array([5.0, 12.0, 22.0, 32.0])
print("Desde cero:  ", kde(xs, tiempos, h=2).round(4))
# scikit-learn quiere una columna, y da el logaritmo de la densidad
modelo_kde = KernelDensity(bandwidth=2).fit(tiempos.reshape(-1, 1))
log_d = modelo_kde.score_samples(xs.reshape(-1, 1))
print("scikit-learn:", np.exp(log_d).round(4))
Desde cero: [0.0082 0.0754 0.0079 0.0312]
scikit-learn: [0.0082 0.0754 0.0079 0.0312]La densidad es alta a los 12 minutos (los que caminan) y a los 32 (los del micro), y baja a los 22, entre los dos grupos. ¿Por qué h = 2? Por ahora, porque sí. Y el ancho de banda lo cambia todo: con campanitas muy angostas, la curva es una sierra con un pico en cada dato (se sobreajusta, como el polinomio de grado alto del tema 7); con campanitas muy anchas, todo se aplana en una sola loma y los dos grupos desaparecen.
Como en el tema 7, el valor se elige con validación cruzada: se ajusta la KDE con 4 de los 5 pliegues y se mide la log-verosimilitud (la suma de los logaritmos de la densidad) de los puntos del pliegue que quedó afuera. Si h es muy chico, los puntos de validación caen entre los picos, donde la densidad es casi cero, y su logaritmo es muy negativo; si es muy grande, la densidad queda repartida en todas partes y es baja en todos lados. GridSearchCV (tema 10) lo hace solo, porque el score de KernelDensity es justo esa log-verosimilitud. Los datos están ordenados (primero los que caminan), así que hay que mezclarlos al repartir los pliegues: KFold(5, shuffle=True).
from sklearn.model_selection import GridSearchCV, KFold

anchos = [0.3, 1, 2, 3, 4, 6, 10]
busqueda = GridSearchCV(KernelDensity(), {"bandwidth": anchos},
                        cv=KFold(5, shuffle=True, random_state=0))
busqueda.fit(tiempos.reshape(-1, 1))
for h, s in zip(anchos, busqueda.cv_results_["mean_test_score"]):
    print(f"h = {h:4}:  log-verosimilitud en validación {s:7.1f}")
h_mejor = busqueda.best_params_["bandwidth"]
print("Mejor ancho de banda:", h_mejor)

xs = np.linspace(0, 50, 400)
plt.hist(tiempos, bins=25, density=True, color="C3", label="Histograma")
plt.plot(xs, kde(xs, tiempos, 0.3), color="C2", linewidth=1,
         label="h = 0,3")
plt.plot(xs, kde(xs, tiempos, 10), color="C0", linestyle="--",
         label="h = 10")
plt.plot(xs, kde(xs, tiempos, h_mejor), color="C1", linewidth=2.5,
         label=f"h = {h_mejor} (validación)")
plt.xlabel("Minutos hasta el colegio")
plt.ylabel("Densidad")
plt.title("KDE con tres anchos de banda")
# Solo para dibujar: espacio arriba para la leyenda
plt.ylim(0, 0.19)
plt.legend(fontsize=11, ncol=2)
plt.show()
h = 0.3: log-verosimilitud en validación -139.0
h = 1: log-verosimilitud en validación -84.6
h = 2: log-verosimilitud en validación -81.2
h = 3: log-verosimilitud en validación -81.9
h = 4: log-verosimilitud en validación -83.5
h = 6: log-verosimilitud en validación -87.1
h = 10: log-verosimilitud en validación -92.3
Mejor ancho de banda: 2La validación elige h = 2, el que usamos arriba, ahora con una razón: su log-verosimilitud en validación (−81,2) es la más alta, apenas por encima de h = 3 (−81,9). Con h = 0,3 cae a −139,0, porque los puntos de validación caen entre los picos; con h = 10 baja a −92,3, porque la densidad se reparte demasiado. density=True escala el histograma para que su área total sea 1, como la de una densidad, y así se puede comparar con las curvas.
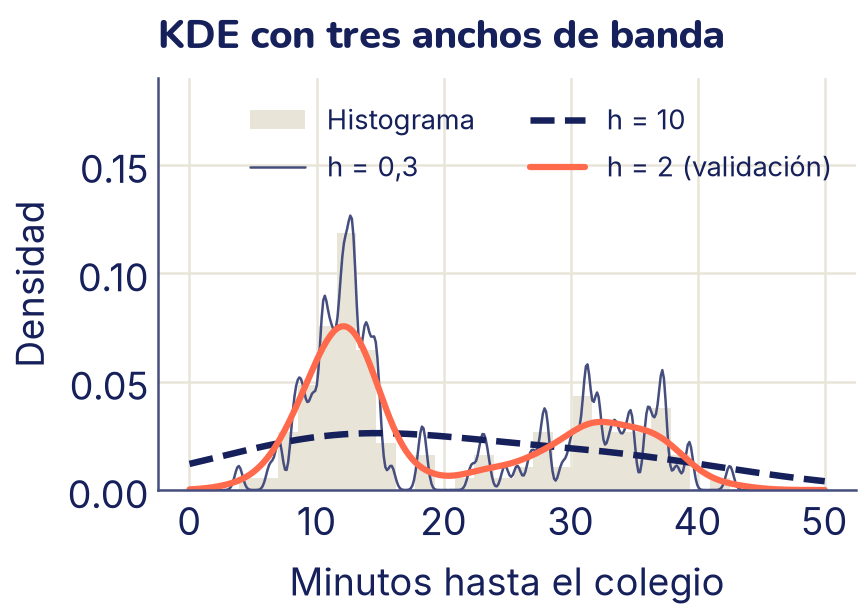
La curva coral cuenta lo que el histograma sugiere: dos grupos, uno alto y angosto (los que caminan tardan parecido) y otro más bajo y ancho (el micro varía más). La sierra de h = 0,3 inventa picos donde solo hay un dato, y la loma de h = 10 borra los dos grupos.
La densidad baja: detectar anomalías
Una densidad sirve para algo más que agrupar: dice qué tan normal es un punto. Si un dato nuevo cae donde la densidad es muy baja, se parece poco a todo lo que vimos antes: es una anomalía (un dato atípico), y vale la pena revisarlo. Así se buscan compras con tarjeta raras, fallas de una máquina o errores de medición, sin una lista de ejemplos malos: es el ejercicio 1, punto 5, con otra herramienta.
La receta: calcular la log-densidad de los datos de entrenamiento con score_samples, fijar un umbral (por ejemplo, el percentil 1: solo el 1 % de los datos de entrenamiento queda por debajo) y marcar como anomalía todo dato nuevo con log-densidad menor. Usemos la mezcla de las manchas estiradas con 30 puntos nuevos de las mismas manchas y 4 puntos raros puestos a mano:
# Los mismos centros y el mismo estiramiento, con otra semilla
X_m2, _ = make_blobs(n_samples=30, centers=centros, cluster_std=1.15,
                     random_state=1)
nuevos_normales = X_m2 @ estirar
raros = np.array([[-6.0, 1.0], [1.0, 3.5], [-1.0, -2.5], [-1.0, 2.0]])
nuevos = np.vstack([nuevos_normales, raros])

umbral = np.percentile(gmm.score_samples(X_est), 1)
anomalia = gmm.score_samples(nuevos) < umbral
print(f"Umbral de log-densidad: {umbral:.2f}")
print("Marcados entre los 30 normales:", anomalia[:30].sum())
print("Marcados entre los 4 raros:    ", anomalia[30:].sum())
Umbral de log-densidad: -5.75
Marcados entre los 30 normales: 0
Marcados entre los 4 raros: 3Dibujemos el umbral: la línea discontinua encierra la zona «normal», donde la log-densidad de la mezcla pasa el umbral.
log_densidad = gmm.score_samples(rejilla).reshape(A.shape)
fig, eje = plt.subplots()
eje.contour(A, B, log_densidad, levels=[umbral], colors="C0",
            linestyles="--", linewidths=1.2)
eje.scatter(X_est[:, 0], X_est[:, 1], s=8, color="C2", alpha=0.5,
            label="Entrenamiento")
eje.scatter(nuevos[~anomalia, 0], nuevos[~anomalia, 1], s=36,
            color="C0", label="Nuevo: normal")
eje.scatter(nuevos[anomalia, 0], nuevos[anomalia, 1], s=110, marker="X",
            color="C1", edgecolors="white", label="Nuevo: anomalía")
eje.set_title("Densidad baja = anomalía")
# Solo para dibujar: espacio a la derecha para la leyenda
eje.set_xlim(-7, 7)
eje.legend(loc="upper right", fontsize=11)
plt.show()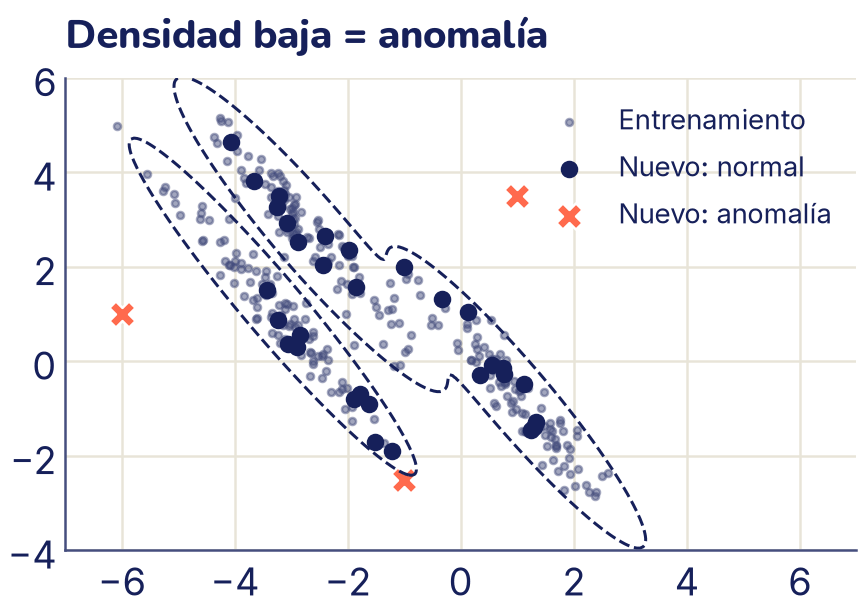
Ninguno de los 30 puntos normales se marcó, y 3 de los 4 raros sí. El que se escapó, (−1, 2), cae donde se tocan dos manchas: ahí hay algunos puntos de entrenamiento, así que la mezcla no lo ve tan raro (su log-densidad, −4,8, queda por encima del umbral de −5,75). Ojo con el umbral: con el percentil 1, se espera que alrededor de 1 de cada 100 datos normales nuevos también quede por debajo y dé una falsa alarma (en la práctica suelen ser algo más, como verás en el ejercicio 10). Subir el umbral atrapa más anomalías, pero también da más falsas alarmas; es el mismo equilibrio entre precisión y exhaustividad del tema 9, y lo pruebas en el ejercicio 10.
La misma receta funciona con cualquier modelo de densidad: una mezcla, una KDE o, en una dimensión, la normal del tema 5 (un dato a más de tres desviaciones de la media tiene densidad muy baja: es la regla 68–95–99,7 vista al revés).
Para profundizar (opcional): KDE en dos dimensiones
Esta parte no hace falta para seguir el tema ni para los ejercicios. La KDE funciona igual en dos dimensiones (o en diez): una campanita redonda sobre cada punto. Donde la mezcla de gaussianas necesita que los datos tengan forma de elipses, la KDE sigue cualquier forma. Comparemos las dos con las lunas, que ninguna elipse describe bien. Para medir cuál describe mejor las lunas, usamos 300 puntos nuevos de las mismas lunas, que ninguno de los dos modelos vio, y promediamos su log-densidad: como en la validación, más alta es mejor.
busqueda_2d = GridSearchCV(KernelDensity(),
                           {"bandwidth": [0.03, 0.05, 0.1, 0.2, 0.4]},
                           cv=KFold(5, shuffle=True, random_state=0))
kde_lunas = busqueda_2d.fit(X_lunas).best_estimator_
gmm_lunas = GaussianMixture(n_components=2, random_state=0).fit(X_lunas)
print("Ancho de banda elegido:", kde_lunas.bandwidth)

X_lunas_nuevas, _ = make_moons(n_samples=300, noise=0.08, random_state=1)
for nombre, m in [("Mezcla de 2", gmm_lunas), ("KDE", kde_lunas)]:
    media = m.score_samples(X_lunas_nuevas).mean()
    print(f"{nombre:12s} log-densidad media en datos nuevos: {media:.2f}")

A2, B2 = np.meshgrid(np.linspace(-1.5, 2.5, 200),
                     np.linspace(-1, 1.5, 200))
rejilla2 = np.column_stack([A2.ravel(), B2.ravel()])
fig, ejes = plt.subplots(2, 1, figsize=(4.8, 4.8), sharex=True)
for eje, (nombre, m) in zip(ejes, [("Mezcla de 2 gaussianas", gmm_lunas),
                                   ("KDE", kde_lunas)]):
    dens = np.exp(m.score_samples(rejilla2)).reshape(A2.shape)
    eje.contour(A2, B2, dens, levels=6, colors="C2", linewidths=0.8)
    eje.scatter(X_lunas[:, 0], X_lunas[:, 1], s=6, color="C0")
    eje.set_title(nombre)
plt.show()
Ancho de banda elegido: 0.1
Mezcla de 2 log-densidad media en datos nuevos: -1.74
KDE log-densidad media en datos nuevos: -0.95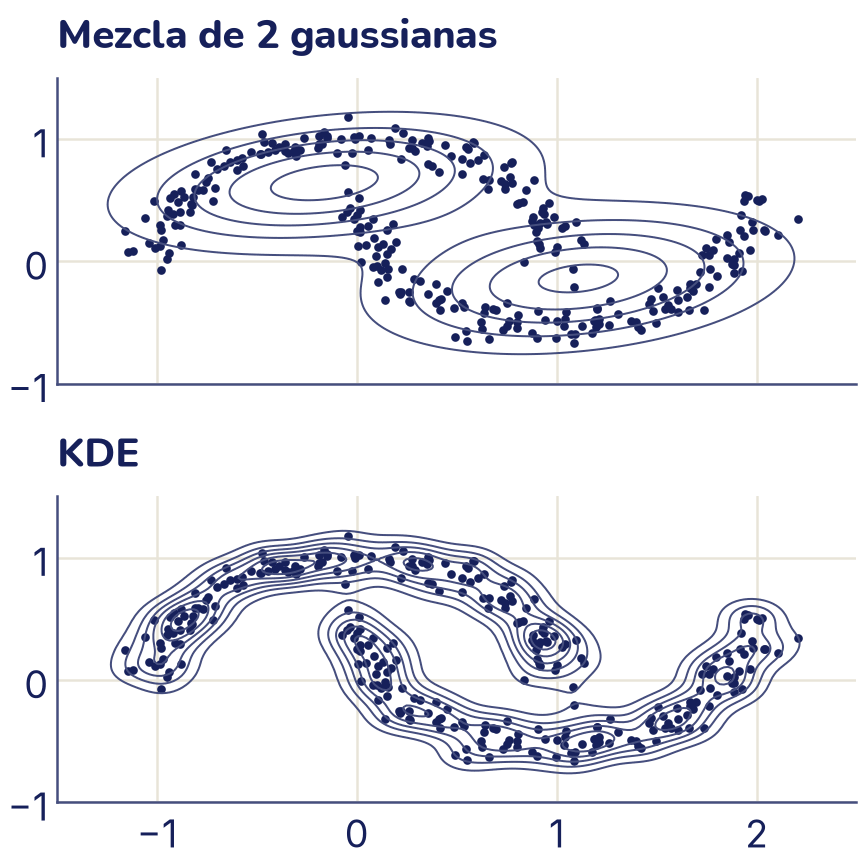
Las elipses de la mezcla cubren zonas vacías y dejan afuera las puntas de las lunas; las curvas de la KDE las abrazan. Los números lo confirman con datos que ningún modelo vio: la log-densidad media de la KDE (−0,95) es más alta que la de la mezcla (−1,74). La KDE tiene sus costos: guarda todos los datos y, para cada punto nuevo, mira la distancia a todos ellos (lento con muchos datos); usa el mismo ancho en todas partes; y, como todo lo que usa distancias, necesita las columnas escaladas. Con muchas columnas necesita además muchísimos datos para llenar el espacio. Por eso, cuando los datos sí se parecen a unas pocas campanas, la mezcla es la opción más económica.
Los cinco métodos sobre las lunas
Ahora sí, comparemos los cinco con las mismas lunas. El sexto panel muestra las lunas reales, para comparar:
from sklearn.cluster import SpectralClustering

metodos = {
    "K-means": KMeans(n_clusters=2, n_init=10, random_state=0),
    "DBSCAN": DBSCAN(eps=0.2, min_samples=5),
    "Jerárquico simple": AgglomerativeClustering(n_clusters=2,
                                                 linkage="single"),
    "Espectral": SpectralClustering(n_clusters=2,
                                    affinity="nearest_neighbors",
                                    random_state=0),
    "Mezcla gaussiana": GaussianMixture(n_components=2, random_state=0),
}

fig, ejes = plt.subplots(3, 2, figsize=(4.8, 4.8),
                         sharex=True, sharey=True)
for eje, (nombre, metodo) in zip(ejes.flat, metodos.items()):
    grupos = metodo.fit_predict(X_lunas)
    acuerdo = adjusted_rand_score(y_lunas, grupos)
    print(f"{nombre:18s} acuerdo con las lunas: {acuerdo:.2f}")
    dibujar_grupos(eje, X_lunas, grupos, s=8)
    eje.set_title(nombre)
dibujar_grupos(ejes[2, 1], X_lunas, y_lunas, s=8)
ejes[2, 1].set_title("Las lunas reales")
plt.show()
K-means acuerdo con las lunas: 0.23
DBSCAN acuerdo con las lunas: 0.99
Jerárquico simple acuerdo con las lunas: 1.00
Espectral acuerdo con las lunas: 0.97
Mezcla gaussiana acuerdo con las lunas: 0.47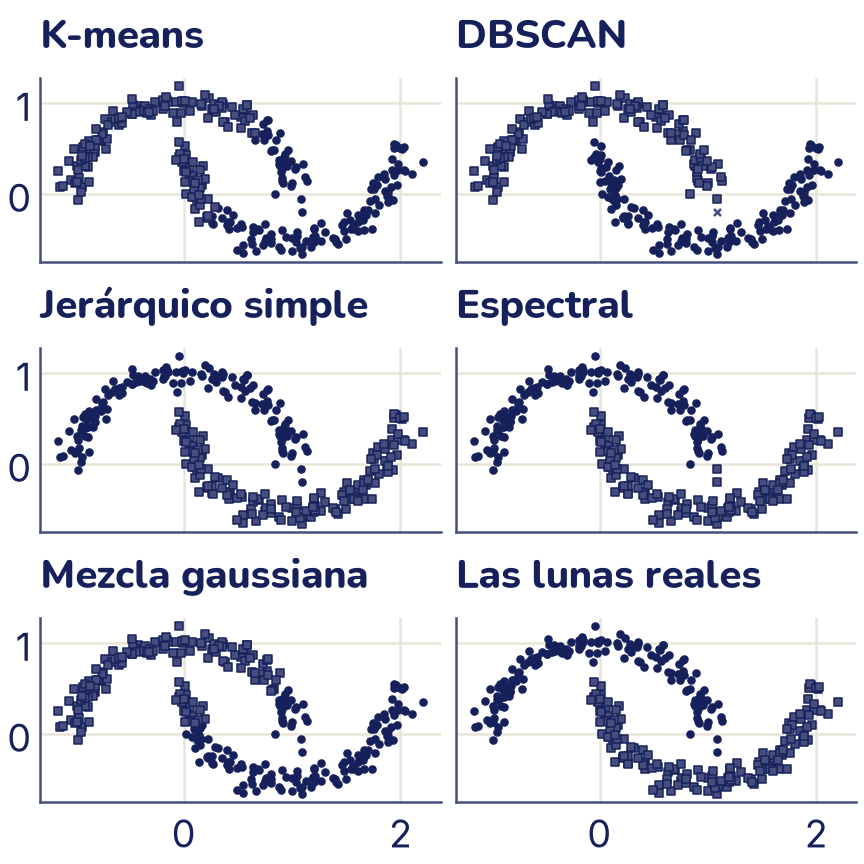
K-means obtiene un acuerdo de solo 0,23: como asigna cada punto al centroide más cercano, la frontera entre sus dos grupos es una recta, y corta la punta de cada luna. DBSCAN, el jerárquico y el espectral siguen la forma. DBSCAN acierta en todo menos en el punto que marca como ruido (0,99); el jerárquico con enlace simple las separa perfecto (1,00), porque encadena vecinos uno tras otro, y el espectral se equivoca solo en unos pocos puntos de las puntas (0,97). La mezcla gaussiana (0,47) mejora un poco a K-means, porque sus elipses pueden inclinarse, pero tampoco sigue la curva: cada campana es una elipse, y una luna no lo es. Su fuerte son las manchas estiradas y las probabilidades, no las formas curvas. Cuidado con sacar una regla de una sola figura: con más ruido entre las lunas, el enlace simple une todo por un puente de puntos y DBSCAN necesita otro eps.
¿Cuál usar?
| Método | Hay que darle | Grupos que encuentra | Ruido | Cuándo usarlo |
|---|---|---|---|---|
| K-means | k | Redondos y de tamaño parecido | No: todo punto va a un grupo | Primera prueba; muchos datos; comprimir (como los colores de una foto) |
| DBSCAN | eps y min_samples |
De cualquier forma, si la densidad es parecida | Sí: lo marca como −1 | Formas raras, datos con puntos sueltos, cuando no sabes k |
| Jerárquico | k (o la altura de corte) y el enlace | Depende del enlace | No | Pocos datos (hasta algunos miles); cuando quieres ver la jerarquía en un dendrograma |
| Espectral | k | Formas curvas conectadas | No | Formas entrelazadas con pocos datos |
| Mezcla de gaussianas | k (o el BIC para elegirlo) | Elipses de cualquier tamaño e inclinación | No, pero la densidad baja señala los puntos raros | Cuando quieres la probabilidad de cada grupo; manchas estiradas; detectar anomalías |
Y para todos: escala las columnas antes, mira el resultado (dibuja los grupos o describe cada uno con promedios) y recuerda que los grupos son una herramienta para entender los datos, no una verdad escondida. Dos métodos razonables pueden dar dos agrupaciones distintas, y las dos pueden ser útiles.
Comprimir una foto con K-means
En el tema 3 viste que una foto es un arreglo de (alto, ancho, 3). Si ponemos cada píxel como una fila de tres números (rojo, verde, azul), una foto es una nube de puntos en tres dimensiones, y agrupar los píxeles es agrupar colores. Si reemplazamos cada píxel por el centroide de su grupo, la foto queda pintada con solo k colores. Es lo que hace un formato como GIF, que usa como máximo 256 colores.
La foto tiene 273 280 píxeles. Para que sea rápido, entrenamos K-means con 2000 píxeles al azar y después usamos predict para asignar todos los píxeles al color más cercano.
from sklearn.datasets import load_sample_image

foto = load_sample_image("china.jpg")
# Una fila por píxel, con sus tres canales entre 0 y 1
pixeles = foto.reshape(-1, 3) / 255
print("Píxeles:", pixeles.shape)
print("Colores distintos en la foto:", len(np.unique(pixeles, axis=0)))

rng = np.random.default_rng(0)
muestra = pixeles[rng.choice(len(pixeles), size=2000, replace=False)]

# Solo para dibujar: las fotos son apaisadas, así que la figura es más baja
fig, ejes = plt.subplots(2, 2, figsize=(4.8, 3.8))
ejes[0, 0].imshow(foto)
ejes[0, 0].set_title("Original")
for eje, k in zip(ejes.flat[1:], [2, 8, 32]):
    colores = KMeans(n_clusters=k, n_init=4, random_state=0).fit(muestra)
    # Cada píxel se reemplaza por el centroide (el color) de su grupo
    grupo = colores.predict(pixeles)
    reducida = colores.cluster_centers_[grupo].reshape(foto.shape)
    eje.imshow(reducida)
    eje.set_title(f"{k} colores")
for eje in ejes.flat:
    eje.axis("off")
plt.show()
Píxeles: (273280, 3)
Colores distintos en la foto: 96615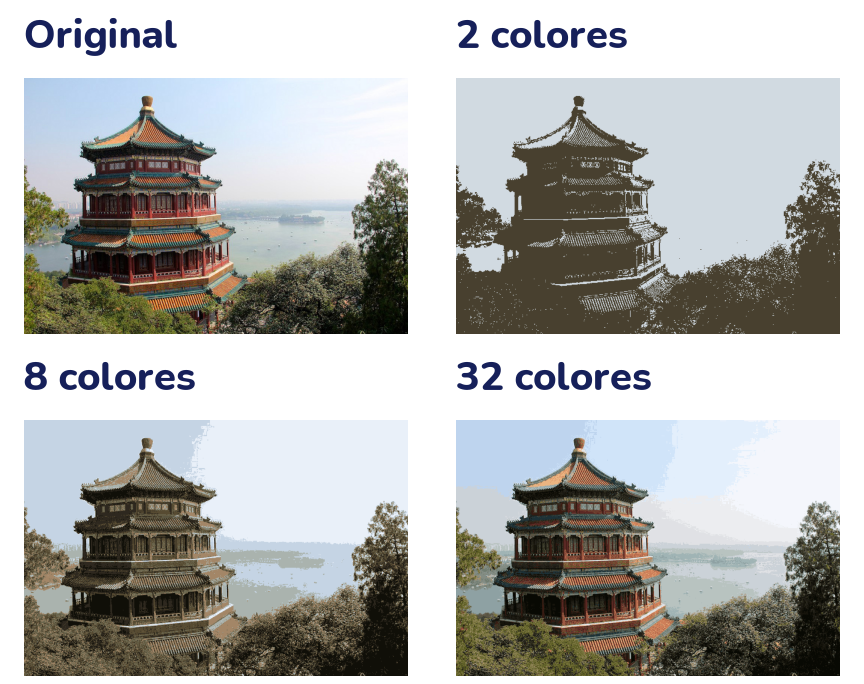
La foto original tiene 96 615 colores distintos. Con 2 colores solo queda una silueta clara y una oscura. Con 8 ya se reconocen el cielo, el agua y los árboles, pero el rojo del techo desapareció: ningún centroide cayó en el rojo, porque son pocos píxeles comparados con el cielo y los árboles. Con 32 colores, el rojo vuelve y la foto se parece mucho a la original. Guardar la foto así ocupa mucho menos: en lugar de tres números de 0 a 255 por píxel, basta con un número de 0 a 31 por píxel (con 5 cifras binarias, o bits, se escriben 2⁵ = 32 valores), más la tabla de 32 colores.
Lo que aprendiste y lo que sigue
- El aprendizaje no supervisado busca estructura en datos sin etiquetas. Agrupar es encontrar puntos cercanos entre sí y lejos del resto, y la cercanía depende de la escala de las columnas.
- K-means repite «asignar al centroide más cercano, mover el centroide al promedio» y baja la inercia hasta un mínimo, que puede ser local. k-means++ y
n_initlo evitan casi siempre. - El codo de la inercia y la silueta más alta ayudan a elegir k, pero no lo deciden solos.
- DBSCAN encuentra grupos de cualquier forma como zonas densas, con
epsymin_samples, y marca el ruido. - El aglomerativo une grupos de abajo hacia arriba según un enlace; el dendrograma muestra todas las uniones y se corta para obtener grupos.
- El espectral agrupa saltando entre vecinos y separa formas que K-means no puede.
- Una mezcla de gaussianas es K-means con elipses y asignación suave: el algoritmo EM alterna repartir cada punto con probabilidades y mover las campanas, y el BIC más bajo ayuda a elegir k. La KDE pone una campanita sobre cada dato; su ancho de banda se elige con validación cruzada. Un dato donde la densidad es muy baja es una anomalía.
En el tema 15 vas a ver otra forma de aprender sin etiquetas: reducir dimensiones, para dibujar en dos dimensiones datos que tienen muchas, y así poder mirar los grupos.